
https://01.me/files/agent-learn-from-experience/dist/1
Co-Founder & Chief Scientist, Pine AI
即時互動的挑戰
- 語音互動延遲很高(幾十秒)
- GUI 操作比人類動作慢 3-5 倍
- 傳統 ReAct 迴圈的串行瓶頸
技術突破
- SEAL 架構(Streaming, Event-driven Agent Loop)
- 感知層:對語音訊號做串流處理
- 思考層:非同步觀察、思考、行動的 Interactive ReAct
- 執行層:回饋迴圈 VLA/TTS
從經驗中學習的挑戰
核心挑戰
- 每個任務都從零開始
- 無法累積領域知識
- 缺少熟練度的提升
agent 從經驗中學習的三大範式
- Post-training:RL 參數更新
- In-context Learning:Attention 軟更新
- Externalized Learning:
- RAG: 持久的經驗儲存
- Tool Generation: Agent 自我演化
科學家 Shunyu Yao 指出第一個問題:agent 執行任務時缺少和真人的互動;第二個問題:缺少從經驗中學習的機制。
(所以我去讀了那篇 blog)
The Second Half - Shunyu Yao
https://ysymyth.github.io/The-Second-Half/
上半場,我們不斷開發新的訓練方法和模型,在基準測試裡拿到穩定的成績。我們不斷做出更難的基準,又在這些測試上穩定拿高分,如此循環。最終找到一種能泛化的有效方法:強化學習。
這套配方已經大致標準化,不太需要新的思考;只要持續跟著上面的循環走,表現就能繼續提升。因此,必須從根本上重新思考評估方法。
問題在於:即便用 AI 打敗了西洋棋和圍棋的世界冠軍,在 SAT 和律師考試上超過大多數人,在競賽裡達到金牌水準,世界並沒有改變太多——至少從經濟或 GDP 的角度看是這樣。
作者稱之為效用問題。
以往的評估設定和真實世界在很多地方不一樣。兩個例子:
- 評估應該能自動跑。通常,一個 agent 接到任務就自主行動,然後拿到任務獎勵。但現實裡,agent 必須在整個任務過程中持續和人互動——你不能給客服發一條極長的訊息,等十分鐘,然後指望收到一份把所有問題都解決掉的詳細回覆。
- 評估「應該」服從獨立同分布(i.i.d.)。如果測試集有 500 個任務,每個任務必須獨立執行,整體評估結果由任務指標彙總而來。但現實裡,任務處理往往是串行而不是並行。Google 工程師越熟悉程式碼庫,處理 Google3 問題的能力就越強;而軟體工程 agent——即便在同一個程式碼庫裡處理大量問題——也做不到這種逐步進步。我們顯然需要長期記憶機制(現有方法 已經能做到),但學界既缺少合適的基準來驗證其必要性,也缺少學術勇氣去質疑機器學習的基礎假設:i.i.d. 假說。
在人工智慧發展的上半場,這些假設用來建立基準沒有問題,因為當時 AI 能力相對較低,提升智力通常就會提升效用。但現在,通用方法已經能在這些假設下保證有效。因此,走向上半場之後的新局面,關鍵在於:
- 為實際應用開發新的評估設定或任務。
- 按既定計劃解問題,或引入創新再 refinement。重複這個循環。
上半場充滿漸進的方法和模型,下半場某種程度上會把它們篩掉。除非能建立打破慣例的新前提,通用方案會徹底蓋過那些漸進方法——只有那時,才有機會去做真正顛覆性的研究。
然後我碰到一段表達,覺得聰明得不得了。我超愛下面這段:
思考,或推理,是一種奇怪的行動——
它並不直接影響外部世界,但推理的空間
是開放的、組合上無窮的——你可以想
一個詞、一句話、整段文字,或 10000 個隨機英文
單詞,但你周圍的世界並不會立刻改變。在
經典 RL 理論裡,這是一筆很糟的交易,會讓決策
變得不可能。想像你要從兩個盒子裡選一個,其中
只有一個盒子裡有 100 萬美元,另一個是空的。你的期望收益是
50 萬。現在想像我加上無窮多個空盒子。你的期望收益變成
零。但把推理加進任何 RL
環境的行動空間之後,我們就能利用語言預訓練的先驗去
泛化,也能為不同決策提供靈活的 test-time compute。這真的是一件神奇的事,我
抱歉沒有在這裡完全講清楚,也許我需要再
專門寫一篇 blog。歡迎去讀 ReAct
看 agent 推理的原始故事,以及我當時的 vibes。
眼下我的直覺解釋是:即便你加上
無窮多個空盒子,你這輩子已經在各種遊戲裡見過它們,
選這些盒子,是在為任何一局遊戲裡更好地選中有錢的那個盒子做準備。我的抽象解釋會是:
語言透過推理,在 agent 裡泛化。
Section 1: Agent 與環境的即時互動
語音 agent 的即時互動挑戰
- 必須等待:先聽,再想;想完才能說。
- 阻塞等待:每個環節都變成瓶頸
- 使用者說完(VAD)→語音辨識(ASR)→ 完整句子
- 完整句子 → 帶思考的 llm → 思考完才完整輸出
- 完整思考 → 切成句子→語音合成(TTS) → 語音回應
- 累積延遲:總延遲遠遠超出人類能忍受的範圍
回得快容易錯,回得慢耗盡使用者的耐心。
沒辦法在聽的同時預判和深思。
感知階段
- 語音:等整句結束再轉成文字,延遲很高;把破碎的語音餵進語音辨識模型,辨識準確率又低。
- 視覺:2K token 截圖的 prefill 延遲很高
思考階段
- 必須完整輸入才能思考。
- 無法預測使用者意圖。
- Test-time scaling 會讓延遲更嚴重。
執行階段
- 只能在思考結束後行動
- GUI 操作的每一步都要再截一張圖來思考。
架構創新:SEAL(Streaming,Event-driven Agent Loop)
核心想法:把所有互動抽象成非同步事件流,做到低延遲、可打斷的即時互動。
- 感知層
把連續的真實世界訊號(語音、GUI 影片)轉成離散事件流
- 思考層
非同步事件處理,邊聽邊想,邊想邊說,生成交錯的思考與行動序列。
- 執行層
把離散的行動指令轉回連續的真實世界訊號(TTS 語音、滑鼠移動)
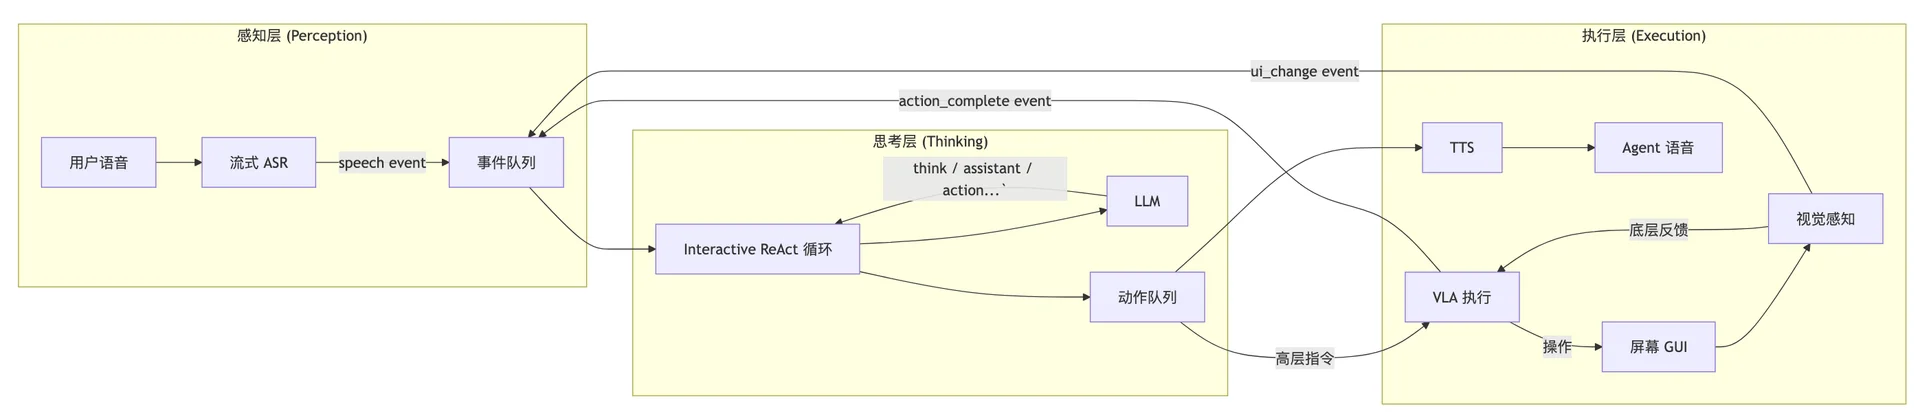
Layer 1 感知層
輸入:序列訊號:語音流、GUI 影片流
輸出:speech_start,interrupt,laugh,speech_fragment,ui_change 等。
用串流語音感知模型取代 VAD+ASR
基於開源自迴歸 LLM 的串流語音感知模型
- 不像 Whisper 這類傳統 ASR 模型那樣用自迴歸架構,這種做法能降低語音辨識延遲。
- 對輸入語音 token 做串流處理
- 串流文字與聲學事件
- 基於開源 LLM 的 post-training
- 保留對話上下文並支援 in-context learning,大幅提高使用者個人資訊和領域術語的辨識準確率。
- 帶著世界知識和常識,品牌名、金額等的辨識率明顯提升。
輸出資訊很豐富,不只是文字,還有聲學事件。
即時轉寫文字片段
Special Tokens(聲學事件):
<speak_start><speak_end><interrupt><emotion:happy><laugh><sigh><music>
Layer 2:思考層
基於事件驅動迴圈,做到可打斷、非同步的邊聽邊想、邊想邊說。
輸入
離散事件流(來自事件佇列)
輸出
交錯的思考與行動指令
核心創新:interactive ReAct
傳統 ReAct

Interactive ReAct:

Interactive ReAct:邊聽邊想
傳統 ReAct:一旦被打斷,之前的思考全部作廢,必須從頭開始。
Interactive ReAct:保留被打斷的思考過程,加入新的使用者輸入後,讓模型基於先前上下文繼續想。
Interactive ReAct:邊想邊說
用「前奏 / preludes」爭取對事件做深度思考,並降低首字延遲。
Layer 3:執行層
把離散行動指令轉成連續的真實世界訊號。
輸入
speak(…),click(…)
輸出
序列訊號(語音波形、滑鼠軌跡)
GUI 操作的 last mile
agent 很難輸出座標。解法:從 Robotics 領域的 VLA 模型取經,用 RL 對模型做 post-training,讓它直接輸出動作。
- 方案 1:主模型直接輸出滑鼠點擊座標。
- 方案 2:單獨訓練一個 VLA 模型,模仿人類滑鼠移動模式:採用「移動、微調、點擊」的閉環回饋模型。
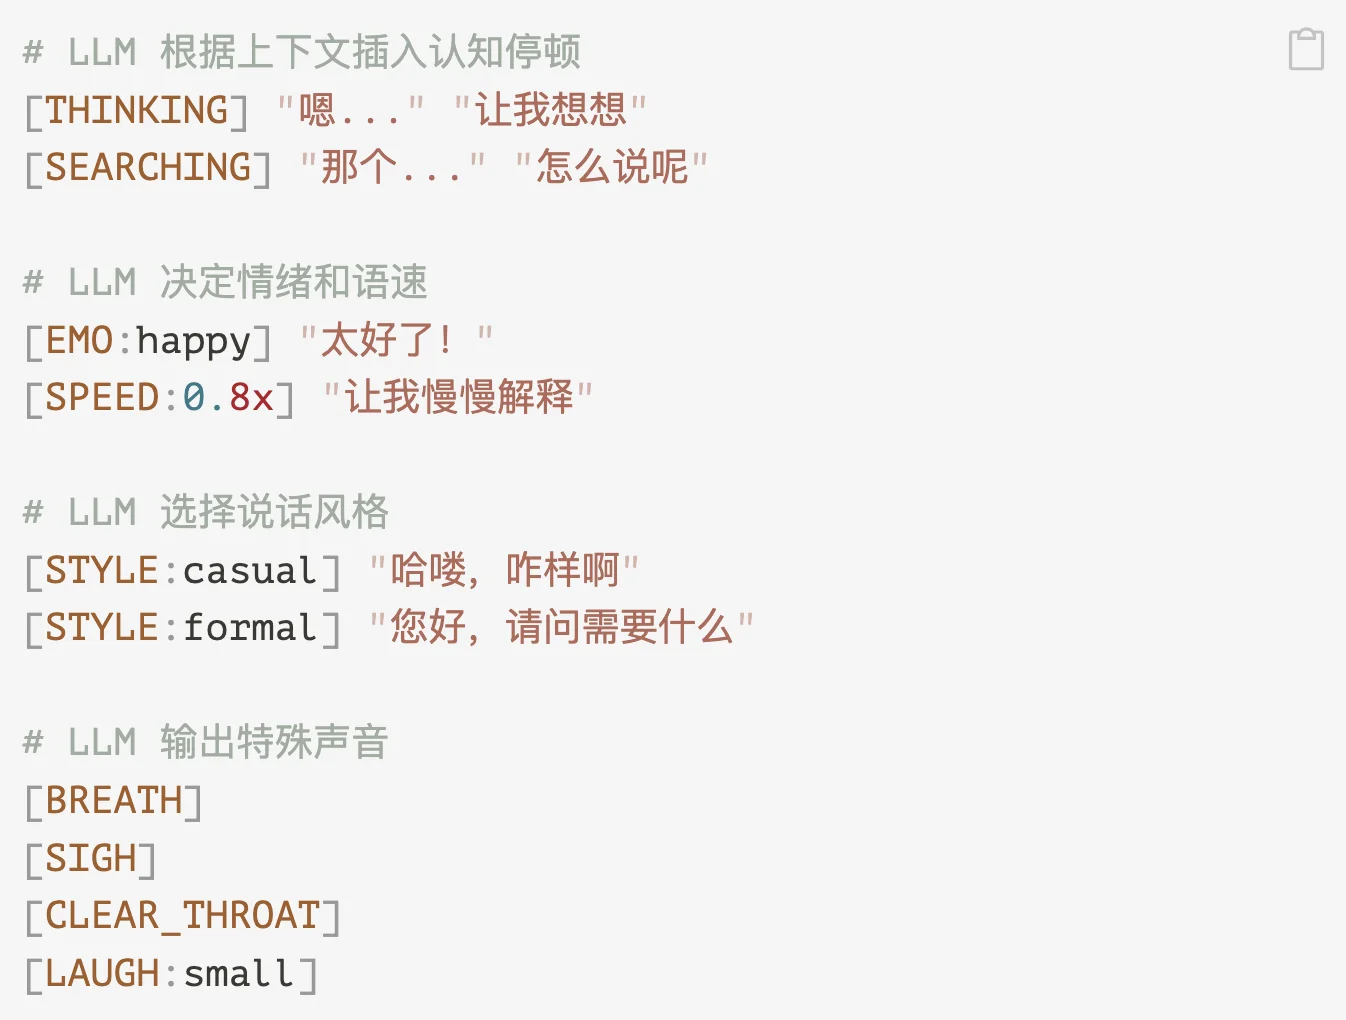
語音合成更像人:先生成帶標註的文字,再用 TTS 產出語音。
Agent 從經驗中學習
範式一:Post-Training
方法:參數更新(Post-training)
- 透過梯度下降更新權重
- 需要大量標註資料
- 訓練完模型就固定了。
- 學習過程又慢又貴。
範式二:In-Context Learning
方法:In-context Learning
- 透過 attention 機制隱式學習。
- 用長上下文當暫時記憶
- 學習效果只限於當前對話,不是永久的。
範式三:Externalized Learning
方法:把知識和流程外化
- RAG: 高效、可靠、少幻覺的知識
- Tool-generation: 把流程程式化,做到自我演化。
- 超越參數化知識的限制
Best Practice: Contextual Embeddings + Contextual BM25+Reranking + Top-20 chunks
Fine-tuning vs. RAG: 知識注入方法的經驗比較
基於論文:Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs
https://aclanthology.org/2024.emnlp-main.15.pdf
論文的核心洞察:RAG 不只更有效,還能避開微調可能帶來的知識遺忘和幻覺問題。
Tool Generation - 讓 Agent 自我演化
https://arxiv.org/abs/2505.20286
最小預定義原則
- 極簡架構:只配備單一核心組件(Web proxy)
- 避免過度工程:不要預設複雜工具和工作流。
- 通用性優先:減少領域特定的硬編碼
最大自我演化機制
核心能力
- 自己造工具:根據任務需求生成新工具。
- 能力增強:迭代改進現有工具的表現
- 經驗複用:把成功模式固化成可複用元件。
MCP-Zero 主動工具發現
傳統方法的困境:
- 全量注入:完整工具集佔用大量 token → 上下文爆炸。
- 靜態檢索:根據初始 query 選擇,無法預測任務演化。除錯檔案需要檔案系統 + 程式分析 + 指令執行。
MCP-Zero:從被動到主動
核心概念:讓 Agent 主動識別能力缺口,並按需請求工具
- 主動工具請求:Agent 生成結構化需求
- 分層語義路由:先過濾 Server,再匹配工具
- 迭代能力擴展:在執行過程中動態發現並搭建工具鏈
把學習外化、超越 attention 的限制,是必然趨勢。
從 70 年 AI 研究裡能讀到的最大教訓是:善用計算的通用方法最終是最有效的,而且是大幅領先。