
https://01.me/files/agent-learn-from-experience/dist/1
Co-Founder & Chief Scientist, Pine AI
Le défi de l'interaction temps réel
- latence élevée en interaction vocale (dizaines de secondes)
- opération GUI 3 à 5 fois plus lente qu'un humain
- le goulot série du ReAct loop classique
percée technique
- architecture SEAL (Streaming, Event-driven Agent Loop)
- couche perception : traitement en streaming des signaux vocaux
- couche pensée : Interactive ReAct avec observation, pensée et action asynchrones
- couche exécution : boucle de feedback VLA/TTS
Le défi d'apprendre de l'expérience
défi central
- chaque tâche recommence de zéro
- impossible d'accumuler de la connaissance de domaine
- pas de montée en maîtrise
trois grands paradigmes d'apprentissage de l'expérience pour un agent
- Post-training : mise à jour de paramètres par RL
- In-context Learning : mise à jour douce via l'attention
- Externalized Learning :
- RAG : stockage persistant d'expérience
- Tool Generation : auto-évolution de l'agent
Le scientifique Shunyu Yao a pointé le premier problème : le manque d'interaction avec de vraies personnes pendant qu'un agent exécute une tâche ; et le second : l'absence d'un mécanisme pour apprendre de l'expérience.
(Donc je suis allé lire ce blog)
The Second Half - Shunyu Yao
https://ysymyth.github.io/The-Second-Half/
Dans la première mi-temps, on a développé sans cesse de nouvelles méthodes d'entraînement et de nouveaux modèles, avec des résultats stables sur les benchmarks. On a créé des benchmarks plus durs, on a encore marqué haut, et on a cyclé. Au final, on a trouvé une méthode efficace capable de généraliser : l'apprentissage par renforcement.
Cette recette est largement standardisée, elle n'a presque plus besoin de pensée neuve ; tant qu'on suit le cycle ci-dessus, la perf peut continuer à monter. Il faut donc revoir fondamentalement la méthode d'évaluation.
Le problème, c'est que même en battant les champions du monde aux échecs et au go, en dépassant la plupart des humains au SAT et au barreau, en atteignant le niveau médaille d'or en compétition, le monde n'a pas beaucoup changé — du moins du point de vue économique ou du PIB.
L'auteur appelle ça le problème d'utilité.
Les anciens setups d'éval diffèrent du réel sur beaucoup de points. Deux exemples :
- Une éval devrait tourner toute seule. Typiquement, un agent reçoit une tâche, agit tout seul, puis gagne une récompense de tâche. En réalité, l'agent doit interagir avec des humains pendant toute la tâche — tu ne peux pas envoyer un message énorme au support, attendre dix minutes, et espérer une réponse détaillée qui règle tout.
- L'éval « devrait » suivre i.i.d. Si le test set a 500 tâches, chacune doit s'exécuter indépendamment, et le score global agrège les métriques. En réalité, le travail est plutôt séquentiel que parallèle. Plus les ingénieurs Google connaissent le codebase, mieux ils traitent les issues Google3 ; les agents de software engineering — même sur de nombreux problèmes dans le même codebase — n'ont pas cette progression incrémentale. On a clairement besoin de mémoire long terme (des méthodes existent déjà), mais l'académique n'a ni les bons benchmarks pour en montrer la nécessité, ni le courage de questionner une hypothèse fondatrice du ML : i.i.d.
Dans la première mi-temps de l'IA, ces hypothèses allaient bien pour construire des benchmarks, parce qu'avec une IA encore faible, plus d'intelligence voulait souvent dire plus d'utilité. Maintenant, des méthodes générales marchent déjà sous ces hypothèses. Donc la clé de la seconde mi-temps :
- Inventer de nouveaux setups d'éval, ou des tâches pour des applis réelles.
- Résoudre selon le plan, ou raffiner la solution en y mettant de l'innovation. Répéter le cycle.
La première mi-temps est pleine d'approches et de modèles incrémentaux ; la seconde, dans une certaine mesure, va les filtrer. À moins d'établir de nouvelles prémisses qui cassent les conventions, les solutions générales écraseront complètement ces méthodes graduelles — seulement là, il y aura de la place pour une recherche vraiment disruptive.
et je suis tombé sur une formulation que j'ai trouvée terriblement maligne. J'adore ce passage :
Penser, ou raisonner, est une sorte d'action étrange —
ça n'affecte pas directement le monde extérieur, et pourtant l'espace du
raisonnement est ouvert et combinatoirement infini — tu peux penser
à un mot, une phrase, tout un passage, ou 10000 mots anglais
au hasard, mais le monde autour de toi ne change pas tout de suite. Dans la
théorie RL classique, c'est un très mauvais deal, ça rend la décision
impossible. Imagine que tu dois choisir une boîte sur deux, et qu'il n'y a
qu'une boîte avec 1 M$ et l'autre vide. Ton espérance est
500 k$. Maintenant j'ajoute une infinité de boîtes vides. Ton espérance
tombe à zéro. Mais en ajoutant le raisonnement dans l'espace d'actions de n'importe quel
environnement RL, on se sert des priors du pré-entraînement langue pour
généraliser, et on peut se permettre un test-time compute flexible selon
les décisions. C'est vraiment magique, et je
m'excuse de ne pas le rendre tout à fait clair ici, il me faudra peut-être
un autre billet juste pour ça. Tu peux lire ReAct
pour l'histoire originale du raisonnement pour les agents, et mes vibes de
l'époque. Pour l'instant, mon explication intuitive : même si tu ajoutes
une infinité de boîtes vides, tu les as vues toute ta vie dans toutes
sortes de jeux, et choisir ces boîtes te prépare à mieux choisir
la boîte avec l'argent, quel que soit le jeu. Mon explication abstraite :
le langage généralise par le raisonnement, chez les agents.
Section 1 : interaction temps réel de l'agent avec l'environnement
Défis d'interaction temps réel des agents vocaux
- Il faut attendre : d'abord écouter, puis penser ; seulement après avoir pensé on peut parler.
- Attente bloquante : chaque maillon devient un goulot
- l'utilisateur a fini de parler (VAD) → reconnaissance vocale (ASR) → phrase complète
- phrase complète → llm avec thinking → sortie complète après thinking
- thinking complet → découpe en phrases → synthèse vocale (TTS) → réponse vocale
- délai cumulé : le délai total dépasse largement ce qu'un humain tolère
répondre vite, on se trompe ; répondre lent, on brûle la patience.
incapable d'anticiper et de délibérer tout en écoutant
phase perception
- voix : attendre la fin de la phrase entière avant de convertir en texte → haute latence ; nourrir l'ASR avec de la parole fragmentée → mauvaise précision.
- vision : haute latence de prefill pour des screenshots de 2K tokens
phase thinking
- il faut l'entrée complète pour penser.
- impossible de prédire l'intention.
- le test-time scaling aggrave le délai.
phase exécution
- on ne peut agir que quand la pensée est finie
- chaque pas GUI demande une nouvelle capture d'écran pour réfléchir.
innovation d'architecture : SEAL (Streaming, Event-driven Agent Loop)
Idée centrale : abstraire toutes les interactions en flux d'événements asynchrones, pour une interaction temps réel à basse latence, interruptible.
- couche perception
Convertir des signaux continus du monde réel (voix, vidéo GUI) en flux d'événements discrets
- couche thinking
Traitement d'événements async, penser en écoutant, parler en pensant, générer des séquences entrelacées de pensée et d'action.
- couche exécution
Reconvertir des commandes d'action discrètes en signaux continus (voix TTS, mouvements de souris)
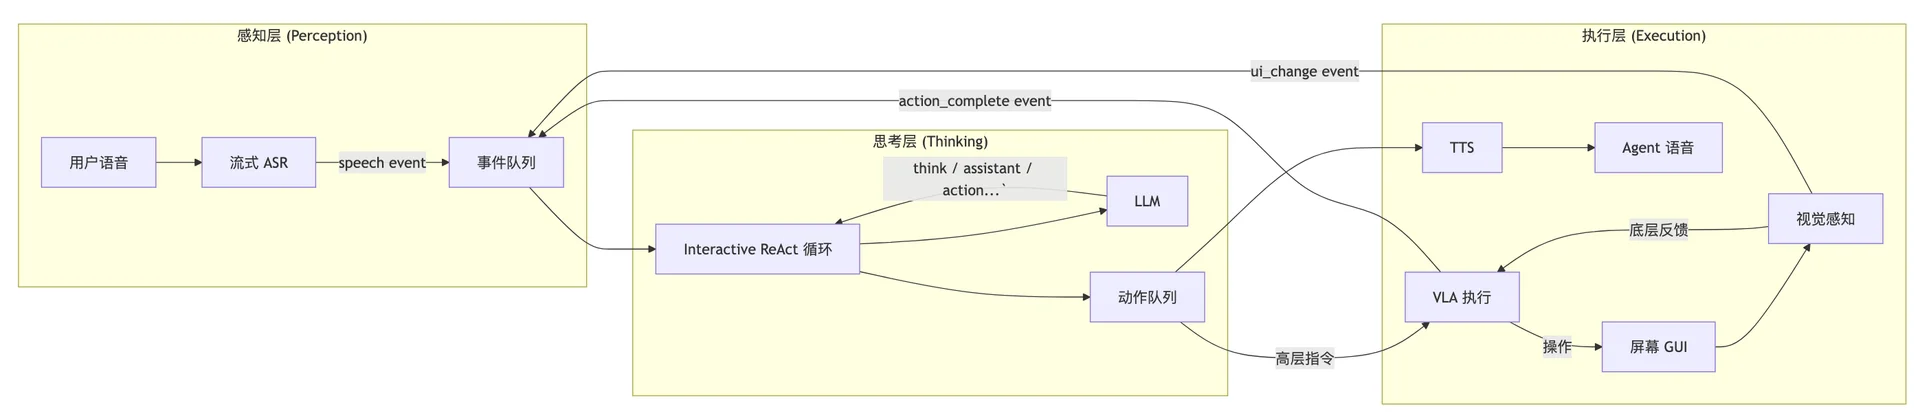
Layer 1 couche perception
entrée : signal séquentiel : flux vocal, flux vidéo GUI
sortie : speech_start, interrupt, laugh, speech_fragment, ui_change, etc.
Modèle de perception vocale en streaming qui remplace VAD+ASR
Modèles speech-aware en streaming, basés sur des LLM autorégressifs open source
- Contrairement aux ASR classiques comme Whisper, cette approche réduit la latence de reconnaissance.
- traitement streaming des speech tokens
- texte et événements acoustiques en streaming
- basé sur le post-training d'un LLM open source
- garder le contexte de dialogue et le in-context learning améliore beaucoup la reconnaissance des infos perso et des termes de domaine.
- avec de la connaissance du monde et du bon sens, la reco des marques, montants, etc. grimpe.
La sortie est riche : pas seulement du texte, aussi des événements acoustiques.
Segment de transcription temps réel
Special Tokens (événement acoustique) :
<speak_start><speak_end><interrupt><emotion:happy><laugh><sigh><music>
Layer 2 : couche thinking
Boucle event-driven : écouter en pensant et parler en pensant, de façon interruptible et asynchrone.
Entrée
flux d'événements discrets (depuis la file d'événements)
sortie
pensées et commandes d'action entrelacées
innovation centrale : interactive ReAct
ReAct classique

Interactive ReAct :

Interactive ReAct : penser en écoutant
ReAct classique : une interruption invalide toute la pensée précédente ; il faut tout recommencer.
Interactive ReAct : garder le fil de pensée interrompu, ajouter la nouvelle entrée utilisateur, et laisser le modèle continuer à partir du contexte précédent.
Interactive ReAct : parler en pensant
Utiliser des « preludes » pour gagner du temps de pensée profonde sur les événements, et baisser le délai du premier caractère.
Layer 3 : couche exécution
Convertir des commandes d'action discrètes en signaux continus du monde réel.
Entrée
speak(…), click(…)
Sortie
signal séquentiel (forme d'onde vocale, trajectoire de souris)
last mile pour l'opération GUI
L'agent galère à sortir des coordonnées. Solution : s'inspirer des modèles VLA en robotique, post-entraîner en RL, pour qu'il sorte directement des actions.
- Option 1 : le modèle principal sort directement les coordonnées de clic.
- Option 2 : entraîner un VLA à part qui imite le mouvement de souris humain : modèle en boucle fermée « bouger, affiner, cliquer ».
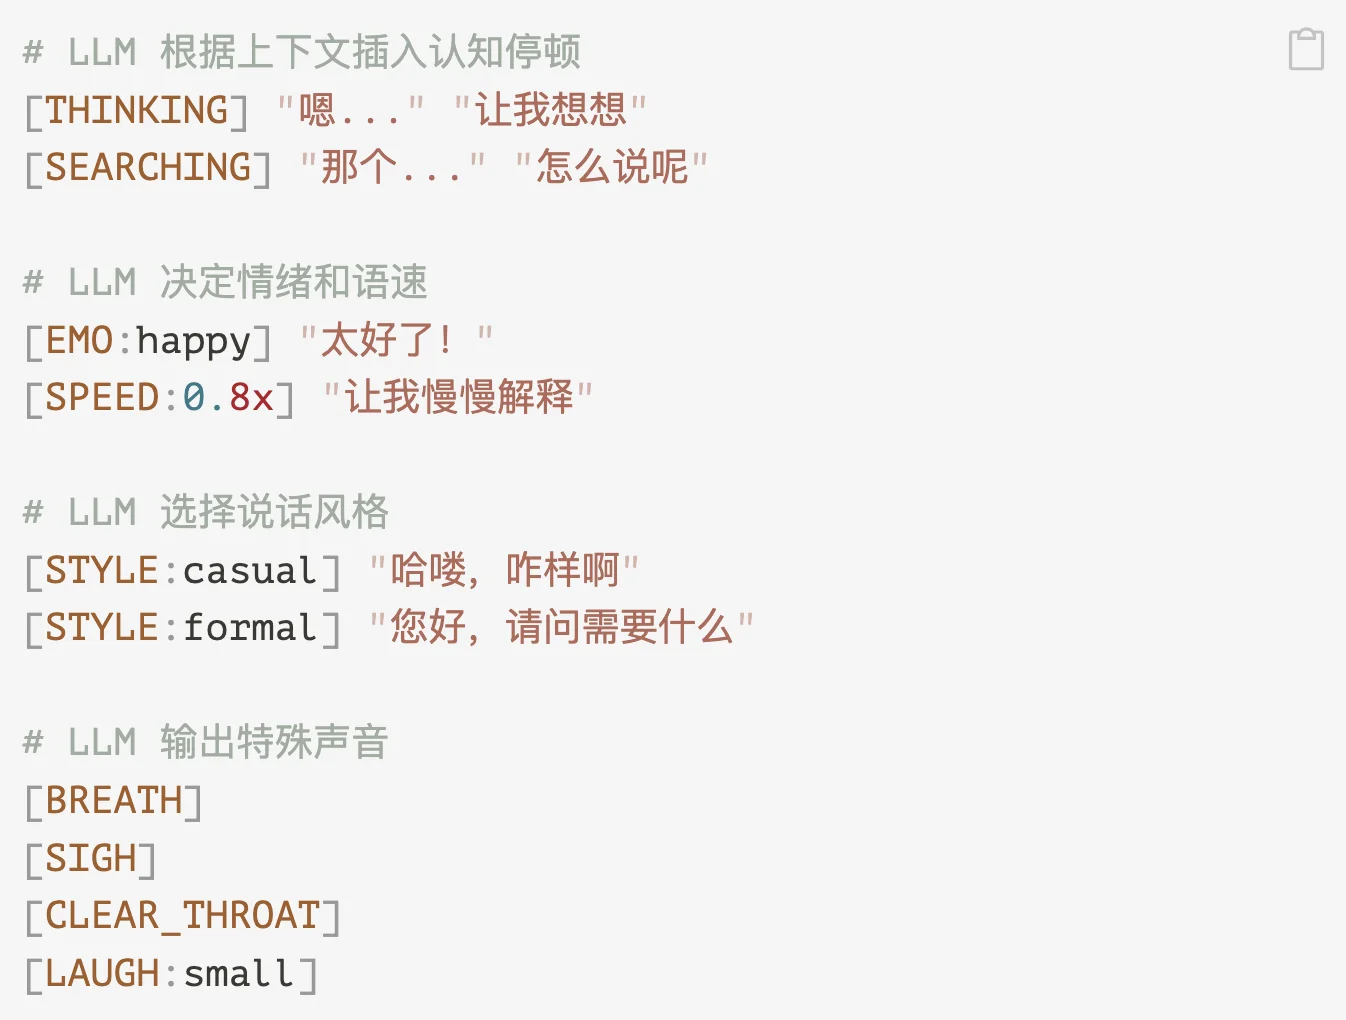
Synthèse vocale plus humaine : générer du texte annoté, puis TTS.
L'agent apprend de l'expérience
Paradigme 1 : Post-Training
Méthode : mise à jour de paramètres (post-training)
- mettre à jour les poids par descente de gradient
- il faut beaucoup de données annotées
- le modèle est figé après l'entraînement.
- l'apprentissage est lent et cher.
Paradigme 2 : In-Context Learning
Méthode : in-context learning
- apprentissage implicite via l'attention.
- le long contexte comme mémoire temporaire
- l'effet ne dure que pour la conversation courante ; ce n'est pas permanent.
Paradigme 3 : Externalized Learning
Méthode : externaliser la connaissance et les processus
- RAG : connaissance efficace, fiable, peu hallucinée
- Tool-generation : coder les processus, s'auto-évoluer.
- dépasser les limites de la connaissance paramétrique
Best practice : Contextual Embeddings + Contextual BM25 + Reranking + Top-20 chunks
Fine-tuning vs. RAG : comparaison empirique des méthodes d'injection de connaissance
D'après l'article : Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs
https://aclanthology.org/2024.emnlp-main.15.pdf
Insight central : le RAG n'est pas seulement plus efficace, il évite aussi l'oubli et les hallucinations que le fine-tuning peut amener.
Tool Generation — permettre l'auto-évolution de l'agent
https://arxiv.org/abs/2505.20286
Principe du minimum prédéfini
- architecture minimaliste : un seul composant cœur (web proxy)
- éviter le sur-engineering : ne pas présupposer des outils et workflows complexes.
- généricité d'abord : moins de hardcode de domaine
Mécanisme d'auto-évolution maximale
capacité cœur
- Créer ses outils : générer de nouveaux outils selon la tâche.
- Renforcement de capacité : améliorer itérativement les outils existants
- Réemploi d'expérience : figer les patterns qui marchent en composants réutilisables.
MCP-Zero, découverte active d'outils
Dilemme des méthodes classiques :
- injection totale : le jeu d'outils complet mange énormément de tokens → explosion de contexte.
- retrieval statique : choix d'après la query initiale, incapable de prédire l'évolution de la tâche. Déboguer des fichiers demande filesystem + analyse de code + exécution de commandes.
MCP-Zero : du passif à l'actif
Idée centrale : laisser l'agent repérer activement les trous de capacité et demander des outils à la demande
- Requête d'outil active : l'agent génère des besoins structurés
- Routage sémantique hiérarchique : d'abord filtrer les servers, puis matcher les outils
- Expansion itérative de capacité : découvrir et construire des toolchains pendant l'exécution
Externaliser l'apprentissage pour dépasser les limites de l'attention, c'est inévitable.
La plus grande leçon de 70 ans de recherche IA, c'est que les méthodes générales qui s'appuient sur le calcul sont au final les plus efficaces, et de loin.