
https://01.me/files/agent-learn-from-experience/dist/1
Co-Founder & Chief Scientist, Pine AI
リアルタイム相互作用の課題
- 音声インタラクションの遅延が大きい(数十秒)
- GUI操作は人間の動作より3〜5倍遅い
- 従来のReActループの直列ボトルネック
技術的ブレークスルー
- SEALアーキテクチャ(Streaming, Event-driven Agent Loop)
- 知覚層:音声信号のストリーミング処理
- 思考層:非同期の観察・思考・行動による Interactive ReAct
- 実行層:フィードバックループ VLA/TTS
経験から学ぶことの課題
中核の課題
- どのタスクもゼロから始まる
- ドメイン知識を蓄積できない
- 習熟度が上がらない
agentが経験から学ぶ三大パラダイム
- Post-training:RLによるパラメータ更新
- In-context Learning:Attentionのソフト更新
- Externalized Learning:
- RAG: 永続的な経験ストレージ
- Tool Generation: Agentの自己進化
科学者 Shunyu Yao が指摘した第一の問題:agentがタスクを実行するあいだ、実在の人間との相互作用が欠けていること。第二の問題:経験から学ぶ仕組みがないこと。
(だからそのブログを読みに行った)
The Second Half - Shunyu Yao
https://ysymyth.github.io/The-Second-Half/
前半戦では、新しい訓練方法とモデルを作り続け、ベンチマークで安定した成果を出した。より難しいベンチマークを作り、そこでまた高得点を取り、この循環を繰り返した。最終的に、汎化できる有効な方法を見つけた:強化学習である。
このレシピはほぼ標準化され、新しい思考はほとんど要らない。上の循環を追い続ければ、性能は上がり続ける。だから評価方法の根本的な再考が必要だ。
問題は、AIでチェスや囲碁の世界チャンピオンを破り、SATや司法試験でほとんどの人間を超え、競技で金メダル級になっても、世界はあまり変わっていないことだ——少なくとも経済やGDPの観点では。
著者はこれを効用の問題と呼ぶ。
これまでの評価設定は、現実世界と多くの点で違う。二つの例:
- 評価は自動で走るべきだ。典型的には、agentはタスクを受け取り自律的に動き、タスク報酬を得る。しかし現実では、agentはタスクの全過程で人間と相互作用し続けなければならない——カスタマーサポートに極端に長いメッセージを送り、10分待って、全部解決する詳細な返信が来る、ということはない。
- 評価は「独立同分布(i.i.d.)」に従う「べき」だ。テストセットが500タスクなら、各タスクは独立に実行され、全体の評価はタスク指標の集約になる。しかし現実では、タスク処理は並列ではなく直列になりがちだ。Googleのエンジニアはコードベースに慣れるほどGoogle3の問題を処理する能力が上がる。一方、ソフトウェア工学agentは——同じコードベースで多数の問題を扱っても——そのような漸進的な進歩をしない。長期記憶の仕組みは明らかに必要だ(既存の方法 はすでにこれを可能にしている)。しかし学界には、その必要性を検証する適切なベンチマークも、機械学習の基礎仮定であるi.i.d.仮説に疑問を呈する学術的勇気も欠けている。
人工知能発展の前半戦では、これらの仮定でベンチマークを作っても問題なかった。AIの能力が相対的に低いとき、知能を上げれば効用も上がることが多かったからだ。しかし今は、汎用的な方法論がこれらの仮定の下で有効性を保証する。だから後半戦の新しい局面を進む鍵は:
- 実応用のための新しい評価設定やタスクを作る。
- 立てた計画に従って問題を解くか、革新を入れて解法を洗練する。この循環を繰り返す。
前半戦は漸進的なアプローチとモデルで満ちている。後半戦はある程度それらを篩い落とす。慣例を破る新しい前提を立てられない限り、汎用解法がそれらの漸進的方法を完全に覆い尽くす——そのとき初めて、真に破壊的な研究を追う機会が生まれる。
そして、とても賢いと感じた表現に出会った。次の一節が大好きだ:
思考、あるいは推論は、奇妙な種類の行動である——
それは外部世界に直接影響しない。しかし推論の空間は
開いていて、組み合わせ的に無限だ——単語を考えることも、
文を、一段落を、あるいは10000個のランダムな英語
単語を考えることもできる。だが周りの世界はすぐには変わらない。古典的な
RL理論では、これはひどい取引であり、意思決定を
不可能にする。二つの箱から一つを選ぶとしよう。一方にだけ
100万ドルがあり、もう一方は空だ。期待値は
50万ドル。ここで空の箱を無限に足す。期待値は
ゼロになる。しかし推論を任意のRL環境の行動空間に加えることで、
言語の事前学習の事前分布を使って汎化し、
異なる決定に柔軟なtest-time computeを使えるようになる。これは本当に魔法のようなことで、
ここで完全に意味を通せていないことを謝る。これだけでもう一本
ブログが要るかもしれない。ReAct を読んで、
agentのための推論の元の話と、当時の私のvibesを見てほしい。
今の直感的な説明はこうだ:空の箱を無限に足しても、
人生のさまざまなゲームでそれらを見てきた。それらの箱を選ぶことは、
どのゲームでもお金の入った箱をより良く選ぶ準備になる。抽象的な説明は:
言語は、agentにおける推論を通じて汎化する。
Section 1: Agentと環境のリアルタイム相互作用
音声agentのリアルタイム相互作用の課題
- 待たなければならない:まず聞き、それから考える。考えてからしか話せない。
- ブロッキング待ち:どのリンクもボトルネックになる
- ユーザーが話し終わる(VAD)→音声認識(ASR)→ 完全な文
- 完全な文 → 思考付きllm → 思考後の完全な出力
- 完全な思考 → 文に分割→音声合成(TTS) → 音声応答
- 累積遅延:総遅延は人間の耐容をはるかに超える
速い応答は誤りやすく、遅い応答はユーザーの忍耐を燃やす。
聞きながら先読みし、熟考することができない
知覚フェーズ
- 音声:文全体が終わるまで待ってからテキストにすると遅延が大きい。断片的な音声を音声認識に入れると精度が低い。
- 視覚:2K tokenのスクリーンショットのprefill遅延が大きい
思考フェーズ
- 完全な入力がないと考えられない。
- ユーザー意図を予測できない。
- Test-time scalingが遅延を悪化させる。
実行フェーズ
- 思考が終わってからしか行動できない
- GUI操作の一歩ごとに新しいスクリーンショットを撮って考えなければならない。
アーキテクチャ革新:SEAL(Streaming,Event-driven Agent Loop)
中核のアイデア:すべての相互作用を非同期イベントストリームに抽象化し、低遅延で割り込み可能なリアルタイム相互作用を実現する。
- 知覚層
連続的な現実世界の信号(音声、GUI映像)を離散イベントストリームに変換
- 思考層
非同期イベント処理。聞きながら考え、考えながら話し、思考と行動のインターリーブ列を生成する。
- 実行層
離散的な行動コマンドを、連続的な現実世界の信号(TTS音声、マウス移動)に戻す
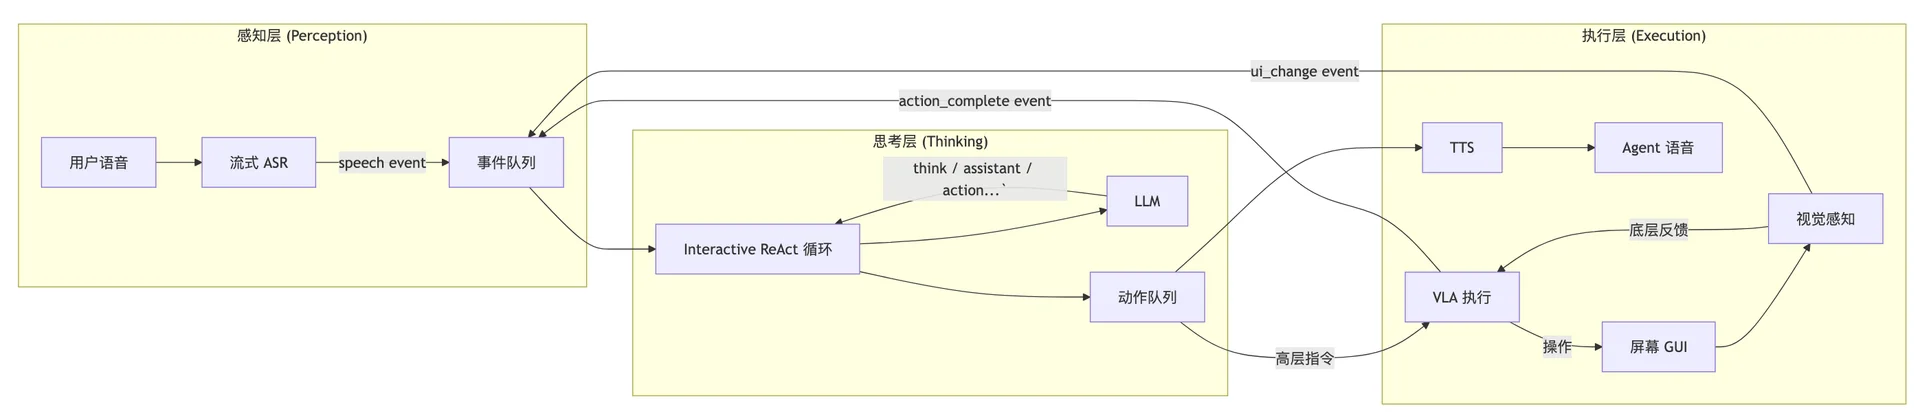
Layer 1 知覚層
入力:系列信号:音声ストリーム、GUI映像ストリーム
出力:speech_start,interrupt,laugh,speech_fragment,ui_change など。
VAD+ASRを置き換えるストリーミング音声知覚モデル
オープンソースの自己回帰LLMに基づくストリーミング音声認識モデル
- Whisperのような従来のASRモデルと異なり、このアプローチは音声認識の遅延を下げる。
- 入力音声tokenのストリーミング処理
- ストリーミングのテキストと音響イベント
- オープンソースLLMのpost-trainingに基づく
- 対話文脈を保持しin-context learningを支えることで、ユーザー個人情報やドメイン用語の認識精度が大幅に上がる。
- 世界知識と常識があり、ブランド名や金額などの認識率が大きく上がる。
出力情報は豊かで、テキストだけでなく音響イベントも含む。
リアルタイム書き起こしテキスト断片
Special Tokens(音響イベント):
<speak_start><speak_end><interrupt><emotion:happy><laugh><sigh><music>
Layer 2:思考層
イベント駆動ループに基づき、割り込み可能で非同期な、聞きながら考える・考えながら話すを実現する。
入力
離散イベントストリーム(イベントキューから)
出力
インターリーブされた思考と行動コマンド
中核の革新:interactive ReAct
従来のReAct

Interactive ReAct:

Interactive ReAct:聞きながら考える
従来のReAct:一度割り込まれると、それまでの思考はすべて無効になり、最初からやり直さなければならない。
Interactive ReAct:割り込まれた思考過程を保存し、新しいユーザー入力を足したあと、以前の文脈に基づいてモデルが考え続ける。
Interactive ReAct:考えながら話す
「prelude」を使い、イベントについての深い思考の時間を稼ぎ、最初の文字の遅延を減らす。
Layer 3:実行層
離散的な行動コマンドを連続的な現実世界の信号に変換する。
入力
speak(…),click(…)
出力
系列信号(音声波形、マウス軌跡)
GUI操作のlast mile
agentは座標の出力が苦手だ。解法:Robotics分野のVLAモデルから着想し、RLでpost-trainingし、直接アクションを出させる。
- 案1:メインモデルがマウスクリック座標を直接出す。
- 案2:独立したVLAモデルを訓練し、人間のマウス移動を模倣する:「動く、微調整、クリック」の閉ループフィードバック。
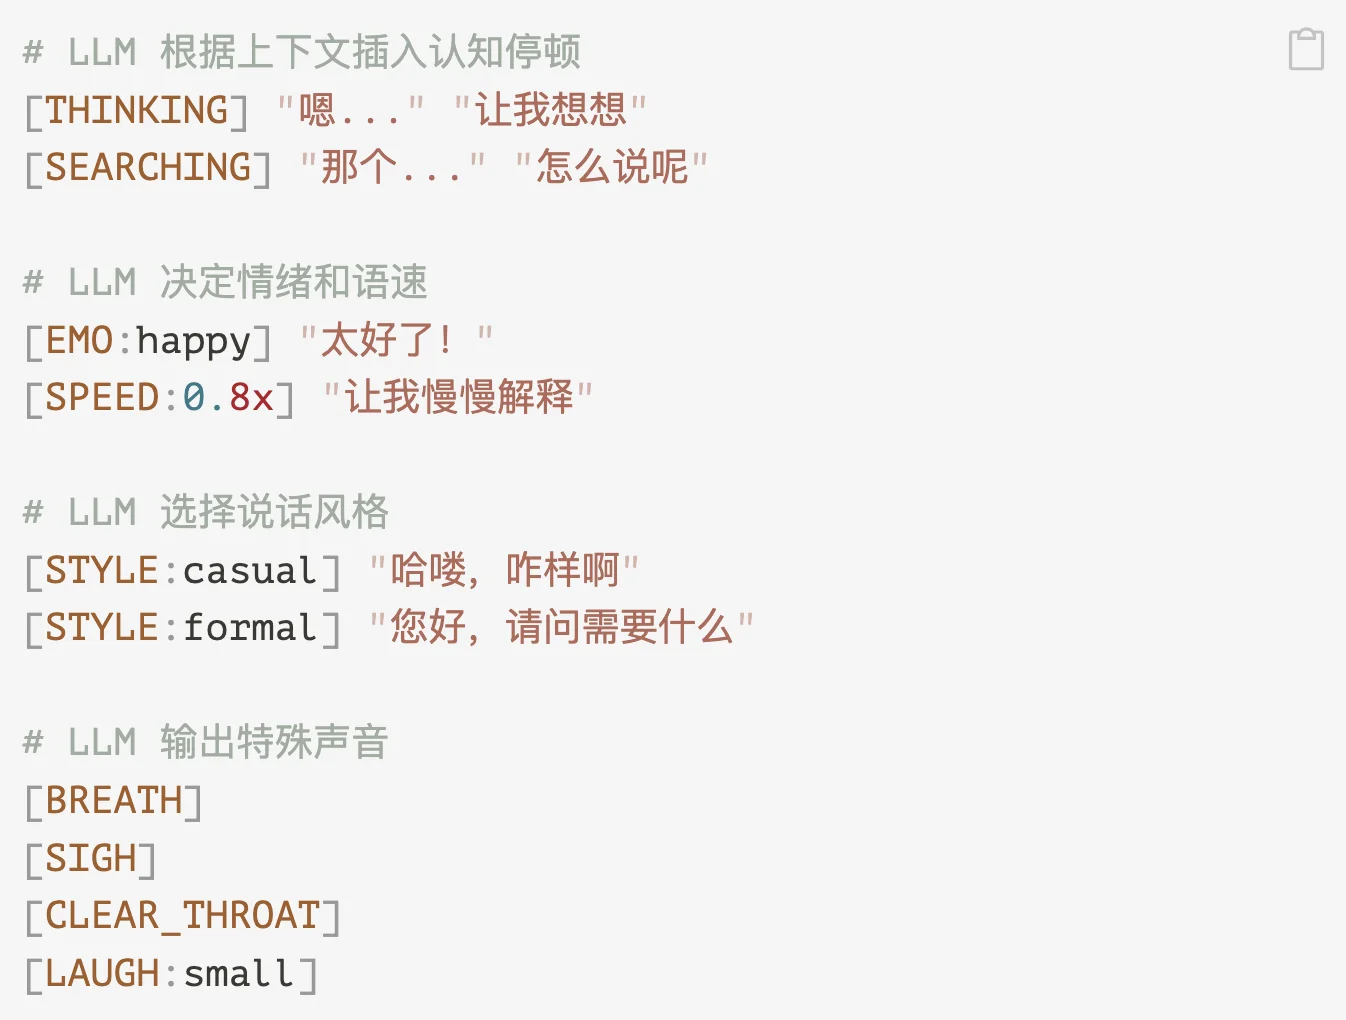
音声合成をより人間らしく:ラベル付きテキストを生成し、TTSで音声にする。
経験からのAgent学習
パラダイム1:Post-Training
方法:パラメータ更新(Post-training)
- 勾配降下で重みを更新
- 大量のアノテーションデータが必要
- 訓練後、モデルは固定される。
- 学習は遅くて高い。
パラダイム2:In-Context Learning
方法:In-context Learning
- attention機構による暗黙の学習。
- 長い文脈を一時記憶として使う
- 学習効果は今の会話に限られ、永続しない。
パラダイム3:Externalized Learning
方法:知識とプロセスの外化
- RAG: 効率的で信頼でき、幻覚の少ない知識
- Tool-generation: プロセスをコード化し、自己進化する。
- パラメータ知識の限界を超える
Best Practice: Contextual Embeddings + Contextual BM25+Reranking + Top-20 chunks
Fine-tuning vs. RAG: 知識注入方法の実証比較
論文に基づく:Fine-Tuning or Retrieval? Comparing Knowledge Injection in LLMs
https://aclanthology.org/2024.emnlp-main.15.pdf
論文の中核洞察:RAGはより有効であるだけでなく、ファインチューニングが招きうる知識の忘却と幻覚も避けられる。
Tool Generation - Agentの自己進化を可能にする
https://arxiv.org/abs/2505.20286
最小事前定義の原則
- 最小構成:単一のコアコンポーネント(Web proxy)だけを装備
- 過剰設計を避ける:複雑なツールとワークフローを前提にしない。
- 汎用性優先:ドメイン固有のハードコードを減らす
最大自己進化メカニズム
中核能力
- 自分でツールを作る:タスク要件に基づいて新しいツールを生成する。
- 能力強化:既存ツールの性能を反復的に改善する
- 経験の再利用:成功パターンを再利用可能な部品に固める。
MCP-Zero 能動的ツール発見
従来手法のジレンマ:
- 全注入:完全なツールセットが大量のtokenを占める → 文脈爆発。
- 静的検索:初期queryに基づく選択で、タスクの進化を予測できない。ファイルのデバッグにはファイルシステム + コード解析 + コマンド実行が必要。
MCP-Zero:受動から能動へ
中核概念:Agentが能力の隙間を能動的に識別し、必要に応じてツールを要求できるようにする
- 能動的ツール要求:Agentが構造化された要件を生成
- 階層的意味ルーティング:まずServerをフィルタし、それからツールをマッチ
- 反復的能力拡張:実行中に動的にツールチェーンを発見し構築する
学習を外化し、attentionの限界を超えるのは必然の流れである。
70年のAI研究から読める最大の教訓は、計算を活かす汎用的方法が最終的に最も有効であり、しかも大きく差をつけて、ということだ。