
KubeEdge-Sedna
程式碼倉庫:https://github.com/kubeedge/sedna
相關PR:
- initial proposal
- updated proposal
- JointInferenceService controller enhancement
- FederatedLearning controller enhancement
一直想等到控制器部分完全完善了再整理出來,但是發現後面的完善方法和初次嘗試的思路不一樣了,所以決定分版本記錄下來完善的方法,v1大部分是開源之夏的內容。和proposal會有所不同,隨著對kubernetes和kubeedge以及sedna的瞭解,希望自己能更深入進去。
最佳化需求
- 聯合推理和聯邦學習沒有辦法正常實現級聯刪除,
kubectl delete JointInferenceService/FederatedLearningJob **時子資源並不會隨之被級聯刪除。 - 在
kubectl edit FederatedLearningJob/JointInferenceService **更新自定義資源配置時,其管理的子資源pod並不會隨之更新。 - 希望實現當手動刪除或者誤操作刪除pod時,pod能夠被重新建立。
級聯刪除
kubernetes中的級聯刪除
kubernetes 中的 Owner Reference 向控制面提供物件間的關聯資訊。kubernetes 透過 Owner Reference(屬主引用)為控制面以及其他 API 客戶端在刪除某物件時提供一個清理關聯資源的能力。在大多數情況下,kubernetes 自動管理 Owner Reference。垃圾收集器可以實現級聯刪除的功能
Kubernetes 的邏輯是刪掉了一個資源時,如果其他資源的 Metadata 中的 ownerReference 中引用該資源,那麼這些資源會被級聯刪除,這個行為是可以配置的,並且預設為 true。
每個資源的 metadata 中都會有 ownerReferences 欄位,它是一個陣列,用來表示該資源的 owner 有哪些。每當 owner 資源被刪除,就會從這個陣列中移除。當所有的 owner 都被刪除後,GC 就會回收該資源。
其實只要知道這個就能順利解決存在的問題,kubernetes自動控制管理級聯刪除,只要設定了正確的owner reference的值,就可以正常級聯刪除。那既然沒有正常級聯刪除,問題就在於沒能正常設定owner reference。然後在尋找建立任務和建立pod邏輯的程式碼就行。
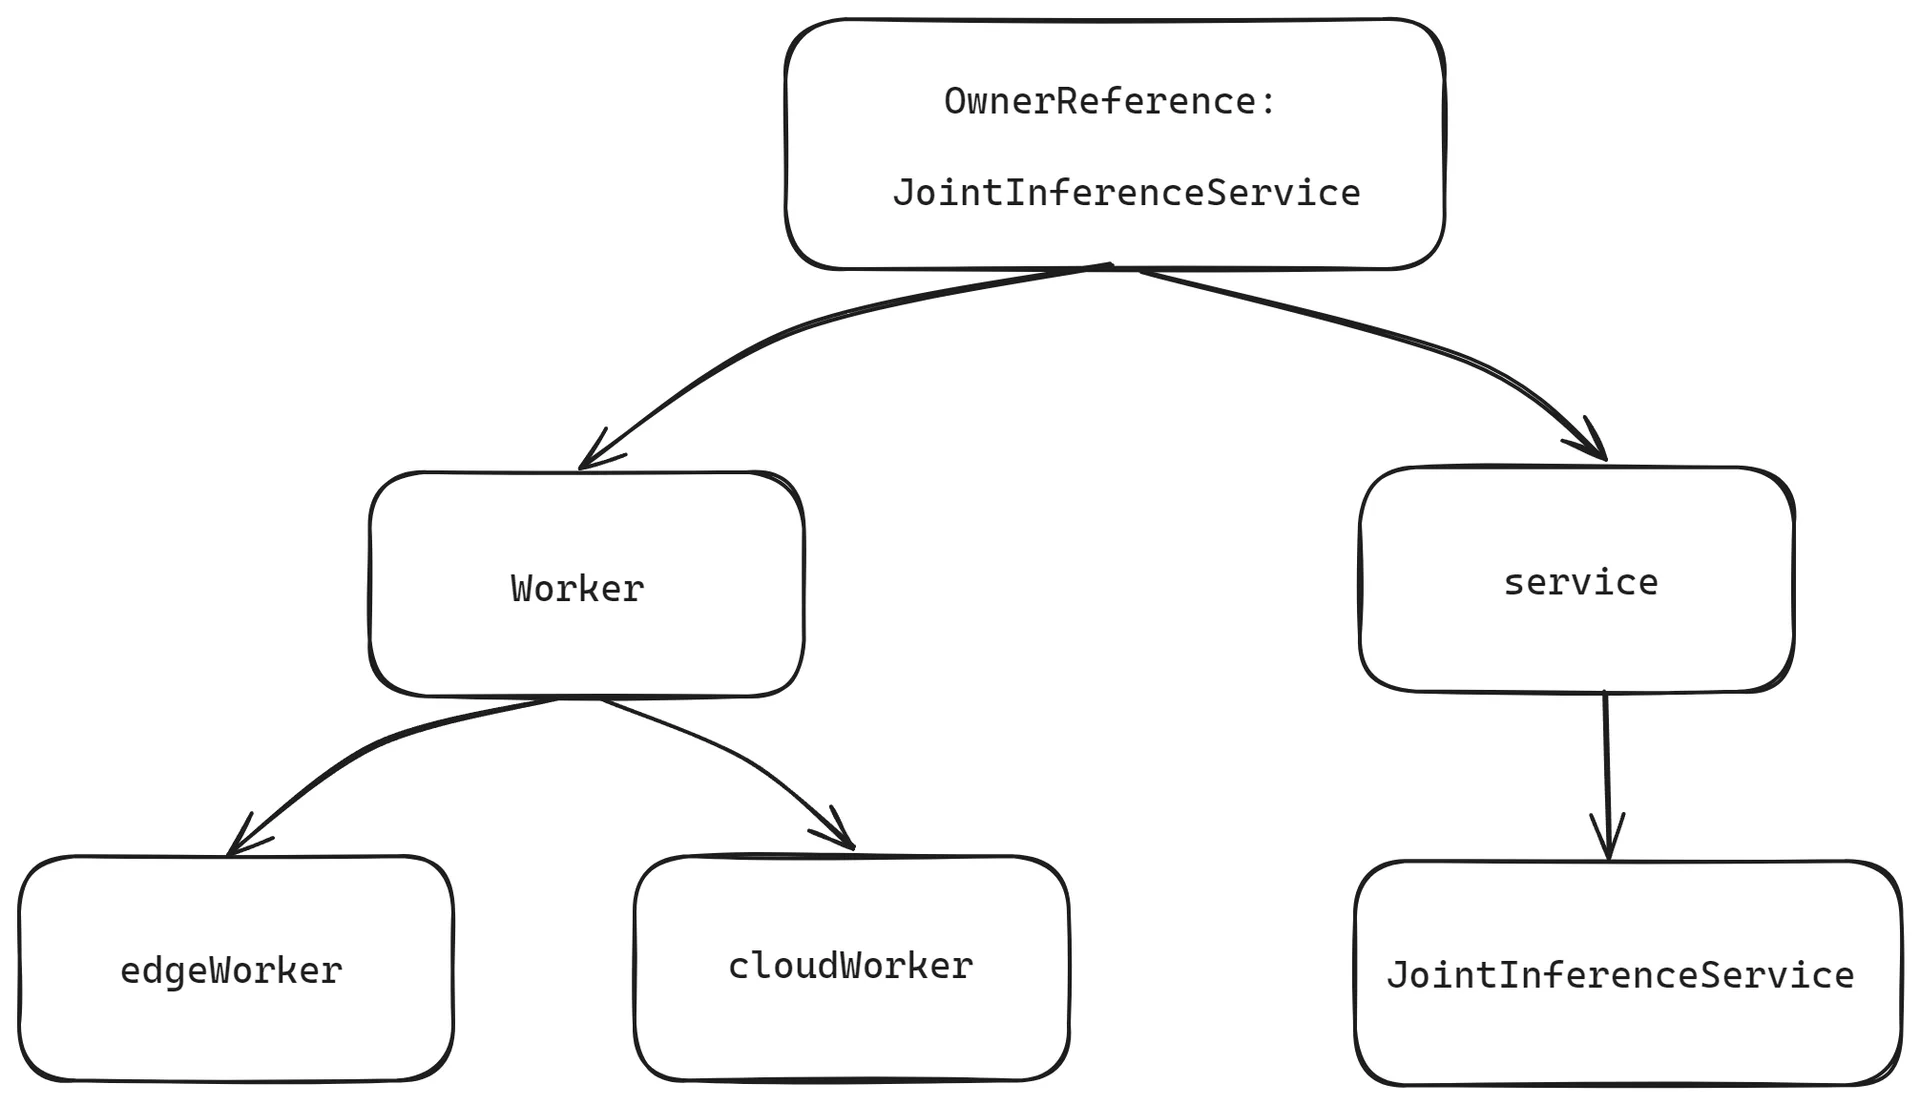
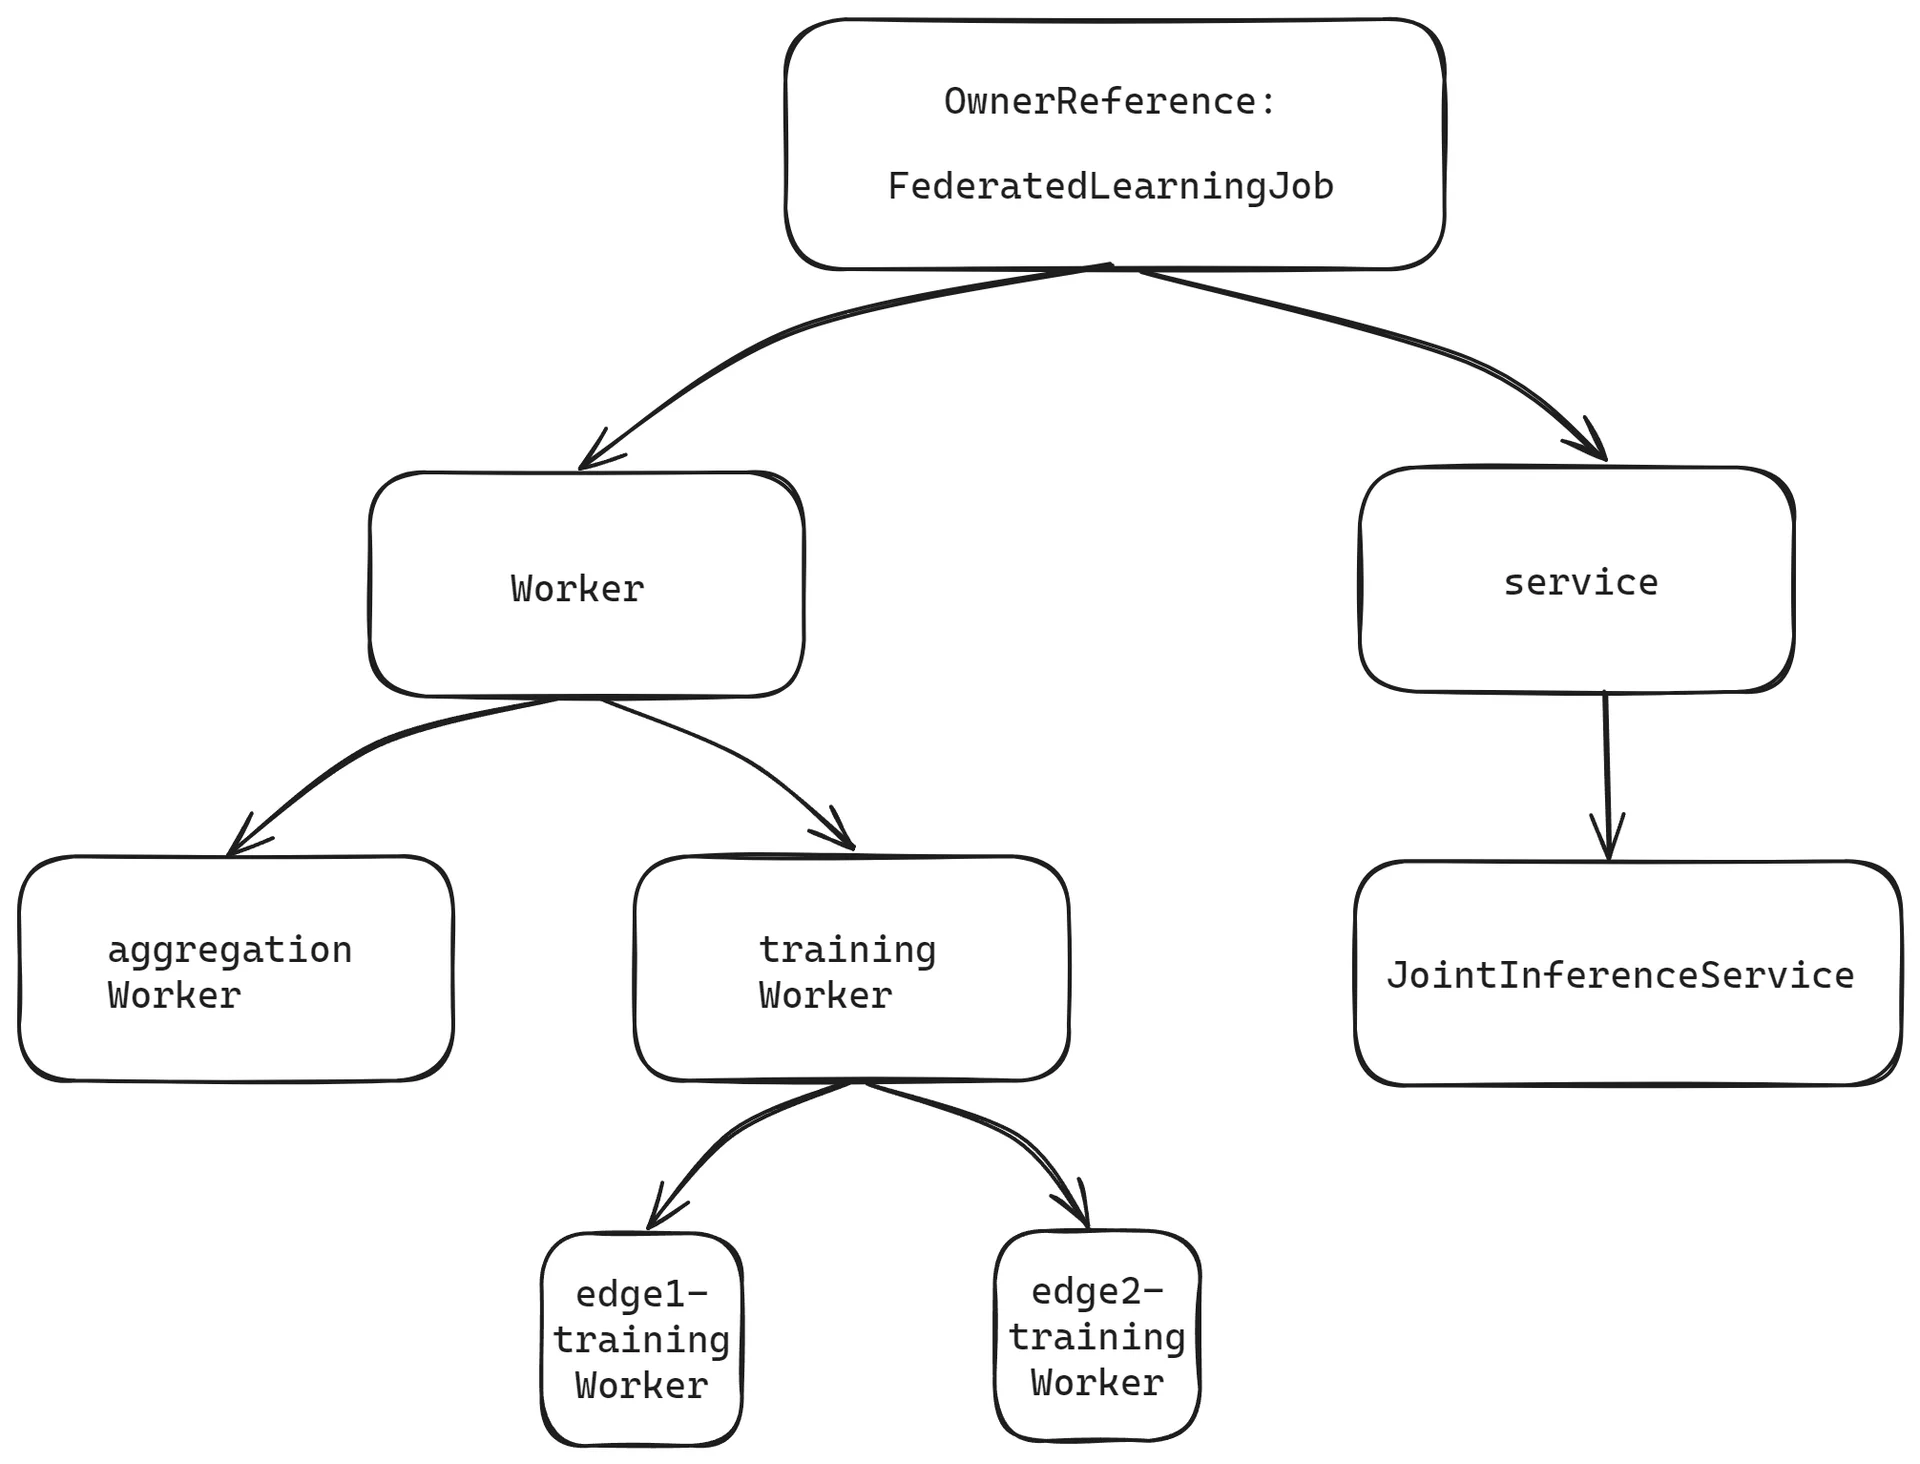
聯合推理和聯邦學習的owner reference關係
JointInferenceService聯合推理
FederatedLearningJob聯邦學習
聯合推理控制器owner reference設定過程
以聯合推理控制器為例,分析 Ownerreference 設定過程。
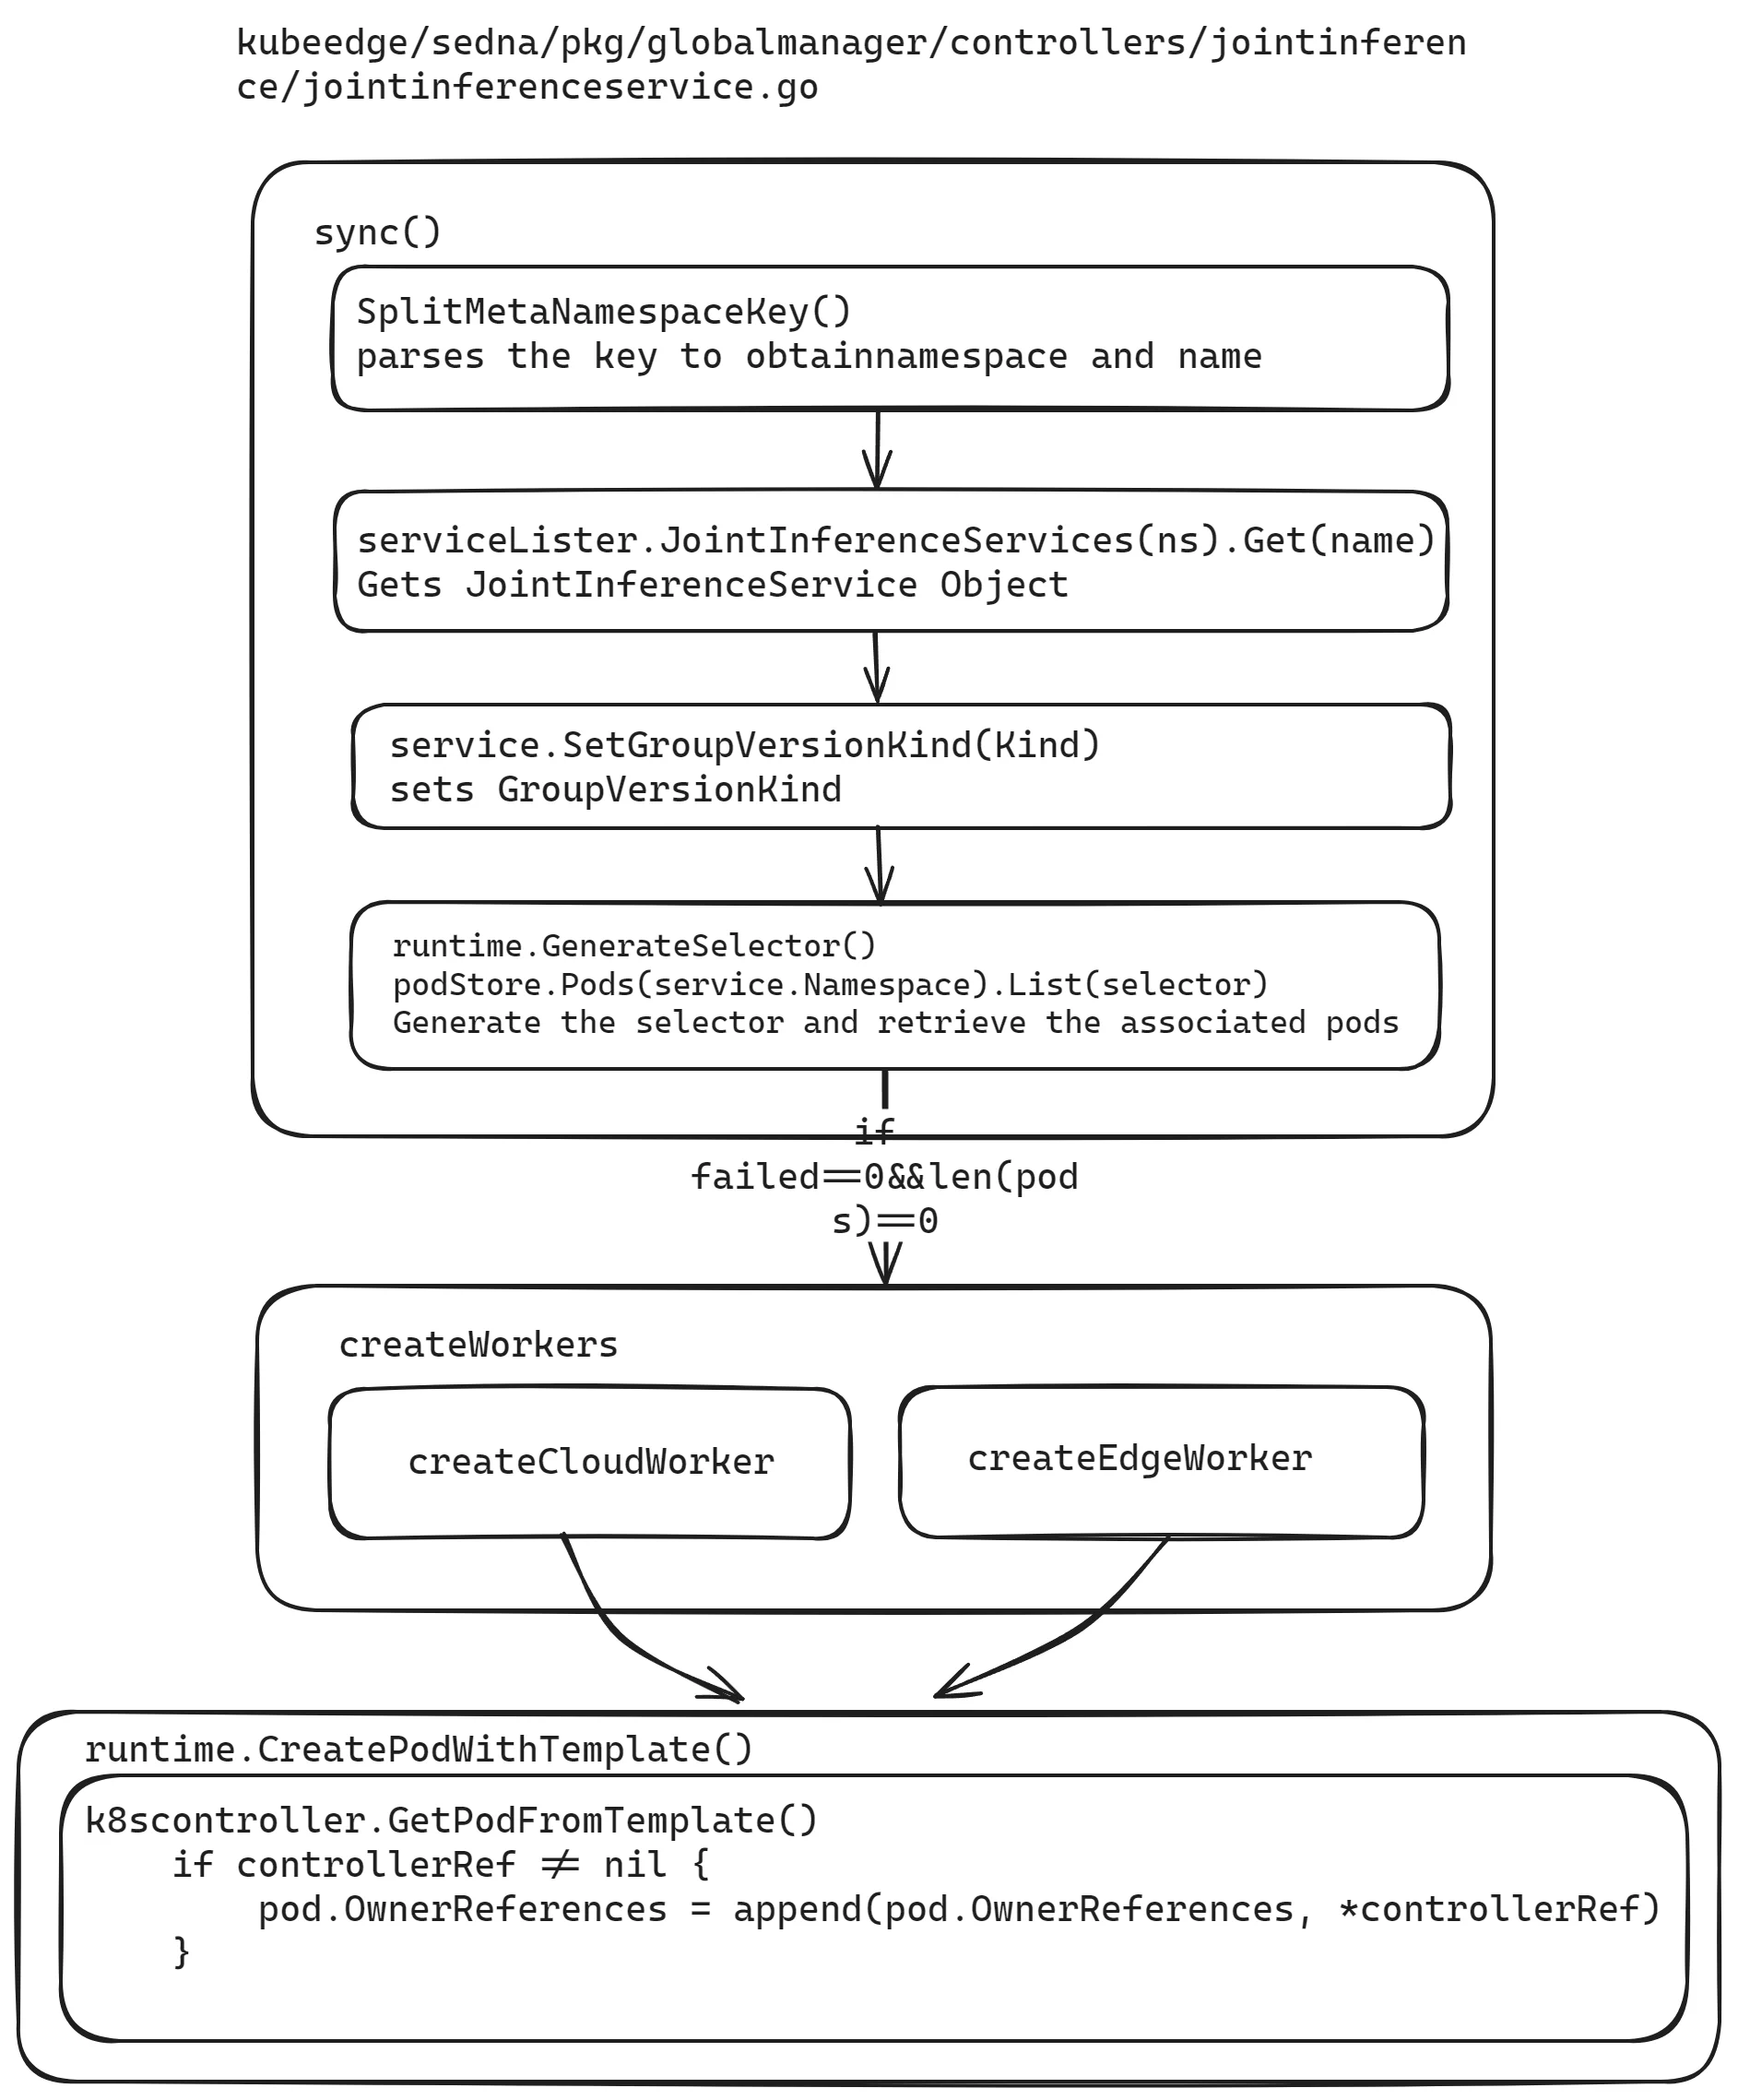
發現整個owner reference的定義過程是沒有問題的,那麼存在問題的其實就是定義的變數。
在pkg/globalmanager/controllers/jointinference/jointinferenceservice.go中,首先定義了 controller name 和 CR 的 kind name。我們傳入 Ownerreference 的值應該是 kind name 而不是控制器的名字。
// Name is this controller name
Name = "JointInference"

// KindName is the kind name of CR this controller controls
KindName = "JointInferenceService"
在這裡對 CR 的 kind name 進行定義,需要注意的是,原先的程式碼中傳入的是 Name(JointInference),而實際應該傳入 Kind Name(JointInferenceService)
// Kind contains the schema.GroupVersionKind for this controller type.
var Kind = sednav1.SchemeGroupVersion.WithKind(KindName)
由 run 函式負責啟動控制器,首先定義worker的數量,然後根據worker數量設定工作執行緒,不斷從工作佇列中獲取任務並進行處理
for i := 0; i < workers; i++ { go wait.Until(c.worker, time.Second, stopCh) }在run函式的這段程式碼中,wait.Until函式啟動了一個goroutine,不斷呼叫c.worker函式,每次呼叫之間間隔一秒鐘,直到stopCh訊號關閉。
// worker runs a worker thread that just dequeues items, processes them, and marks them done.
// It enforces that the sync is never invoked concurrently with the same key.
func (c *Controller) worker() {
    for c.processNextWorkItem() {
    }
}worker函式呼叫processNextWorkItem()函式,由該函式從佇列中獲取任務並處理,呼叫sync函式執行具體的同步方法,直到佇列被關閉。
ns, name, err := cache.SplitMetaNamespaceKey(key)
if err != nil {
    return false, err
}
if len(ns) == 0 || len(name) == 0 {
    return false, fmt.Errorf("invalid jointinference service key %q: either namespace or name is missing", key)
}在sync函式中,由cache.SplitMetaNamespaceKey函式解析key獲取namespace和name
sharedService, err := c.serviceLister.JointInferenceServices(ns).Get(name)
if err != nil {
    if errors.IsNotFound(err) {
        klog.V(4).Infof("JointInferenceService has been deleted: %v", key)
        return true, nil
    }
    return false, err
}
service := *sharedService
從lister中獲取JointInferenceService物件
service.SetGroupVersionKind(Kind)設定GroupVersionKind
selector, _ := runtime.GenerateSelector(&service)
pods, err := c.podStore.Pods(service.Namespace).List(selector)
if err != nil {
    return false, err
}
klog.V(4).Infof("list jointinference service %v/%v, %v pods: %v", service.Namespace, service.Name, len(pods), pods)
生成選擇器並獲取關聯的pods。
當沒有失敗worker時,如果關聯pods的數量為0,即呼叫createWorkers函式建立pod
else {
        if len(pods) == 0 {
            active, manageServiceErr = c.createWorkers(&service)
}在createWorkers函式中呼叫createCloudWorker和createEdgeWorker來建立雲邊端工作pod
在兩個函式中,runtime.CreatePodWithTemplate負責建立pod,其中的k8scontroller.GetPodFromTemplate設定Ownerreference,起作用的是以下程式碼
if controllerRef != nil {
    pod.OwnerReferences = append(pod.OwnerReferences, *controllerRef)
}
Pod重建
Pod 出現故障自動重建是由重啟策略決定的(RestartPolicy)。
在 JointInferenceService 中,未設定 RestartPolicy,所以預設是 always 。在聯合推理任務進行的過程中,當出現程式問題時,比如 EdgeMesh 未正確配置,導致邊緣端無法訪問雲端5000埠進行雲端的較大模型的推理,此時邊緣端 pod 就會不斷重啟。在 FederatedLearningJob 中,設定 RestartPolicy 為 OnFailure。
要實現刪除pod能夠自動建立pod,需要先了解kubernetes的informer機制。
k8s的informer機制
Kubernetes 使用 Informer 代替 Controller 去訪問 API Server,Controller 的所有操作都和 Informer 進行互動,而 Informer 並不會每次都去訪問 API Server。Informer 使用 ListAndWatch 的機制,在Informer首次啟動時,會呼叫LIST API獲取所有最新版本的資源物件,然後再透過WATCH API來監聽這些物件的變化,並將事件資訊維護在一個只讀的快取佇列中提升查詢的效率,同時降低API Server的負載。
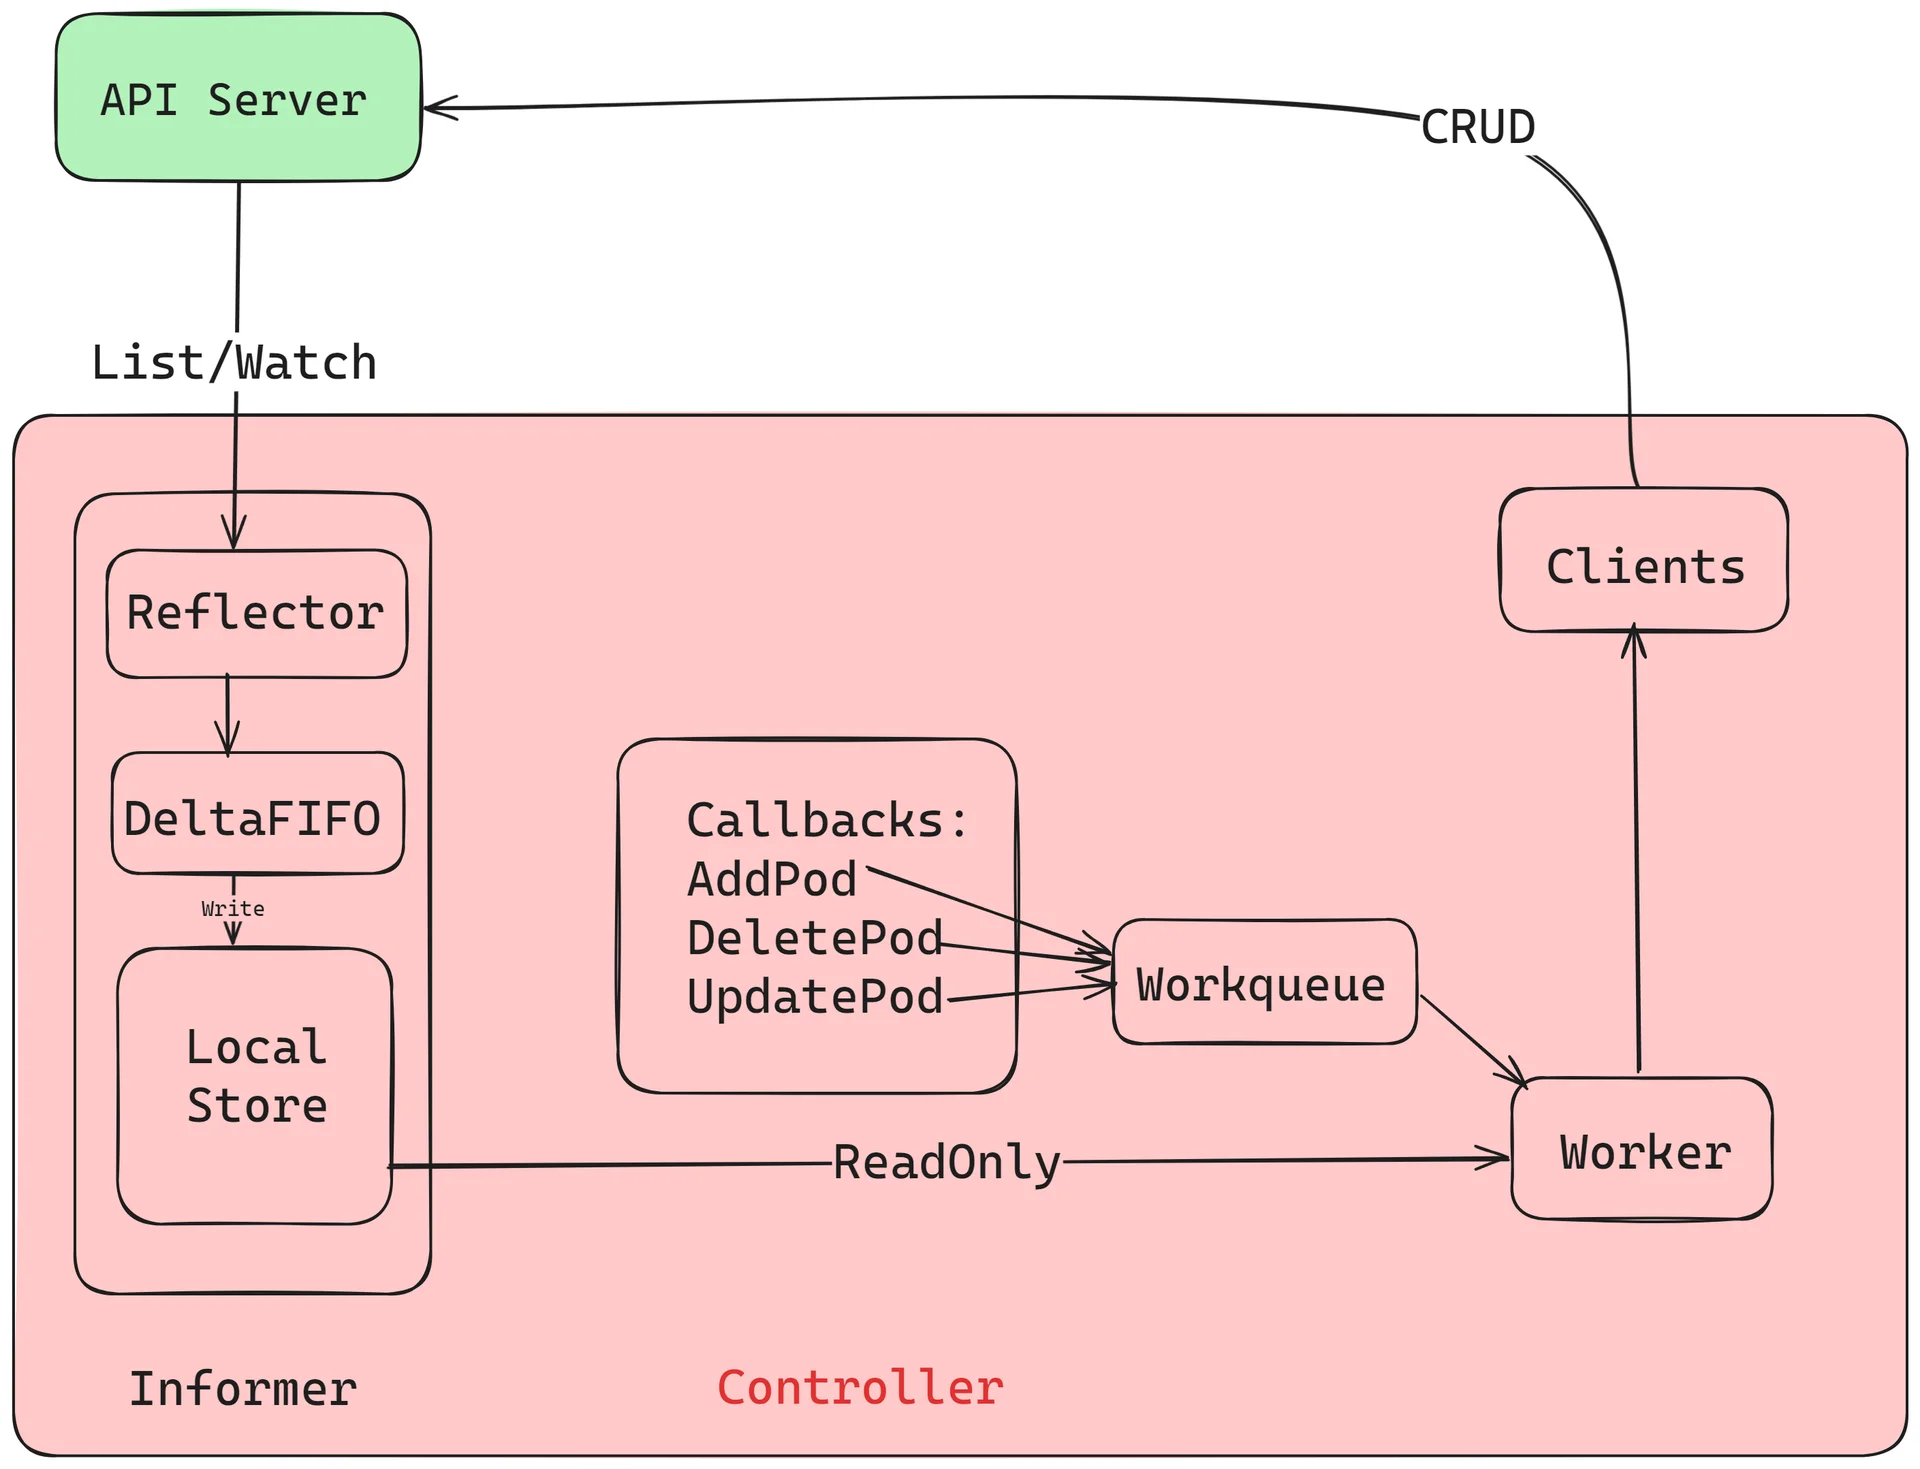
根據流程圖來解釋Informer中幾個元件的作用:
- Controller:Informer的實施載體,可以建立reflector及控制processLoop。processLoop將DeltaFIFO佇列中的資料pop出,首先呼叫Indexer進行快取並建立索引,然後分發給processor進行處理。
- Reflector:Informer並沒有直接訪問k8s-api-server,而是透過一個叫Reflector的物件進行api-server的訪問。Reflector透過ListAndWatch監控指定的 kubernetes 資源,當資源發生變化的時候,例如發生了 Added 資源新增等事件,會將其資源物件存放在本地快取 DeltaFIFO 中。
- DeltaFIFO:是一個先進先出的快取佇列,用來儲存 Watch API 返回的各種事件,如Added、Updated、Deleted。
- LocalStore:就是 informer 的 cache,這裡面快取的是 apiserver 中的物件(其中有一部分可能還在DeltaFIFO 中),此時使用者再查詢物件的時候就直接從 cache 中查詢,減少了 apiserver 的壓力,LocalStore 只會被 Lister 的 List/Get 方法訪問。
- WorkQueue:DeltaIFIFO 收到時間後會先將時間儲存在自己的資料結構中,然後直接操作 Store 中儲存的資料,更新完 store 後 DeltaIFIFO 會將該事件 pop 到 WorkQueue 中,Controller 收到 WorkQueue 中的事件會根據對應的型別觸發對應的回撥函式。
Informer 首先會 list/watch apiserver,Informer 所使用的 Reflector 包負責與 apiserver 建立連線,Reflector 使用 ListAndWatch 的方法,會先從 apiserver 中 list 該資源的所有例項,list 會拿到該物件最新的 resourceVersion,然後使用 watch 方法監聽該 resourceVersion 之後的所有變化,若中途出現異常,reflector 則會從斷開的 resourceVersion 處重現嘗試監聽所有變化,一旦該物件的例項有建立、刪除、更新動作,Reflector 都會收到”事件通知”,這時,該事件及它對應的 API 物件這個組合,被稱為增量(Delta),它會被放進 DeltaFIFO 中。
- Informer 會不斷地從這個 DeltaFIFO 中讀取增量,每拿出一個物件,Informer 就會判斷這個增量的時間型別,然後建立或更新本地的快取,也就是 store。
- 如果事件型別是 Added(新增物件),那麼 Informer 會透過 Indexer 的庫把這個增量裡的 API 物件儲存到本地的快取中,併為它建立索引,若為刪除操作,則在本地快取中刪除該物件。
- DeltaFIFO 再 pop 這個事件到 controller 中,controller 會呼叫事先註冊的 ResourceEventHandler 回撥函式進行處理。
- 在 ResourceEventHandler 回撥函式中,其實只是做了簡單的過濾,然後將關心變更的 Object 放到 workqueue 裡面。
- Controller 從 workqueue 裡面取出 Object,啟動一個 worker 來執行自己的業務邏輯,業務邏輯通常是計算目前叢集的狀態和使用者希望達到的狀態有多大的區別,然後讓 apiserver 將狀態演化到使用者希望達到的狀態,比如為 deployment 建立新的 pods,或者是擴容/縮容 deployment。
- 在worker中就可以使用 lister 來獲取 resource,而不用頻繁的訪問 apiserver,因為 apiserver 中 resource 的變更都會反映到本地的 cache 中。
Informer 中的 ResourceEventHandler 函式有三種:
// ResourceEventHandlerFuncs is an adaptor to let you easily specify as many or
// as few of the notification functions as you want while still implementing
// ResourceEventHandler.
type ResourceEventHandlerFuncs struct {
    AddFunc    func(obj interface{})
    UpdateFunc func(oldObj, newObj interface{})
    DeleteFunc func(obj interface{})
}
這三種函式的處理邏輯是使用者自定義的,在初始化 controller 時註冊完 ResourceEventHandler 後,一旦該物件的例項有建立、刪除、更新三中操作後就會觸發對應的 ResourceEventHandler。
聯合推理和聯邦學習控制器informer流程
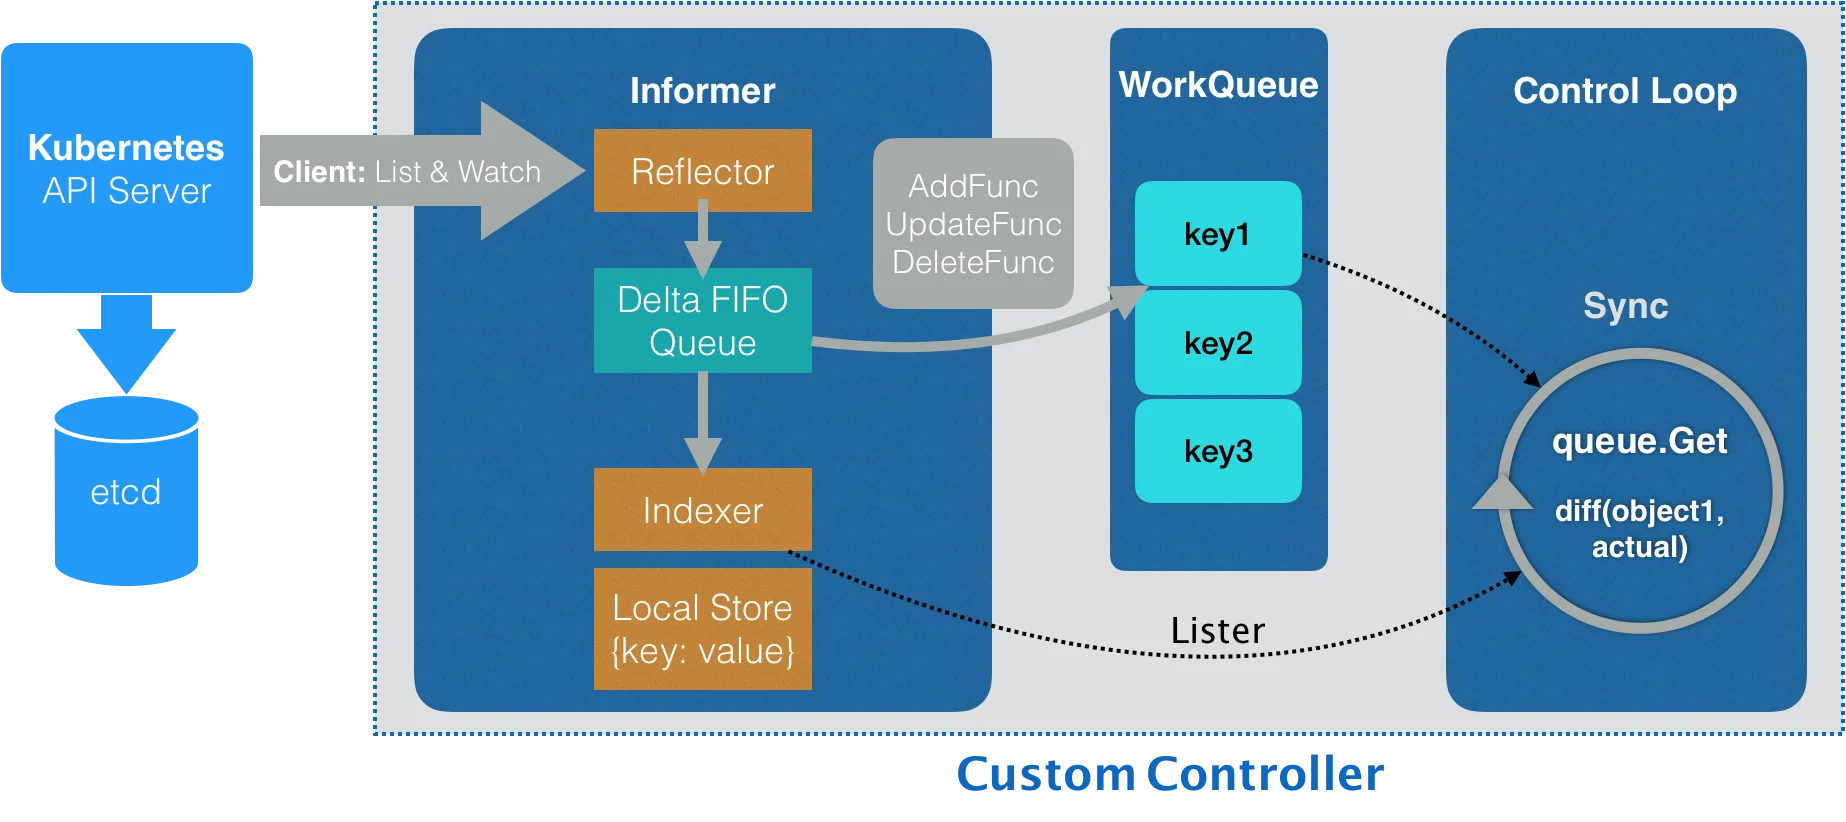
以jointinferenceservice.go為例,New()函式建立一個新的JointInferenceService控制器,來使相關的pod與對應的JointInferenceService物件保持同步。在New()函式中,對informer進行初始化。
podInformer := cc.KubeInformerFactory.Core().V1().Pods()

serviceInformer := cc.SednaInformerFactory.Sedna().V1alpha1().JointInferenceServices()
service informer使用自定義的handler:
serviceInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
    AddFunc: func(obj interface{}) {
        jc.enqueueController(obj, true)
        jc.syncToEdge(watch.Added, obj)
    },
    UpdateFunc: func(old, cur interface{}) {
        jc.enqueueController(cur, true)
        jc.syncToEdge(watch.Added, cur)
    },

    DeleteFunc: func(obj interface{}) {
        jc.enqueueController(obj, true)
        jc.syncToEdge(watch.Deleted, obj)
    },
})
pod informer使用自定義handler:
podInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
    AddFunc:    jc.addPod,
    UpdateFunc: jc.updatePod,
    DeleteFunc: jc.deletePod,
})這裡的EventHandler(addPod、updatePod、deletePod),其實只是將相關的物件加入佇列中,並沒有做其它處理。
podInformer.Lister() 建立Lister()獲取Pod資源,podInformer.Informer().HasSynced檢查Informer的快取是否已經同步。
jc.serviceLister = serviceInformer.Lister()
jc.serviceStoreSynced = serviceInformer.Informer().HasSynced
//...
jc.podStore = podInformer.Lister()
jc.podStoreSynced = podInformer.Informer().HasSynced
從api server同步資源的過程,jointinferenceservice控制器是在Run()函式中進行的,Run()函式開啟負責watch和sync服務的main goroutine。
if !cache.WaitForNamedCacheSync(Name, stopCh, c.podStoreSynced, c.serviceStoreSynced) {
    klog.Errorf("failed to wait for %s caches to sync", Name)
    return

}
啟動Informer後,等待本地cache sync完成後,啟動workers。當收到變更事件後,從事件中獲取變更的Object,生成object key(namespace/name形式),將key放入workerqueue中。
由worker()函式呼叫c.processNextWorkItem()函式。
func (c *Controller) worker() {
    for c.processNextWorkItem() {
    }
}processNextWorkItem函式從workerqueue中獲取key,呼叫sync(),在sync()函式中透過lister從本地快取中獲取真正的object物件,執行相關的同步操作。
聯邦學習pod重建方案設計
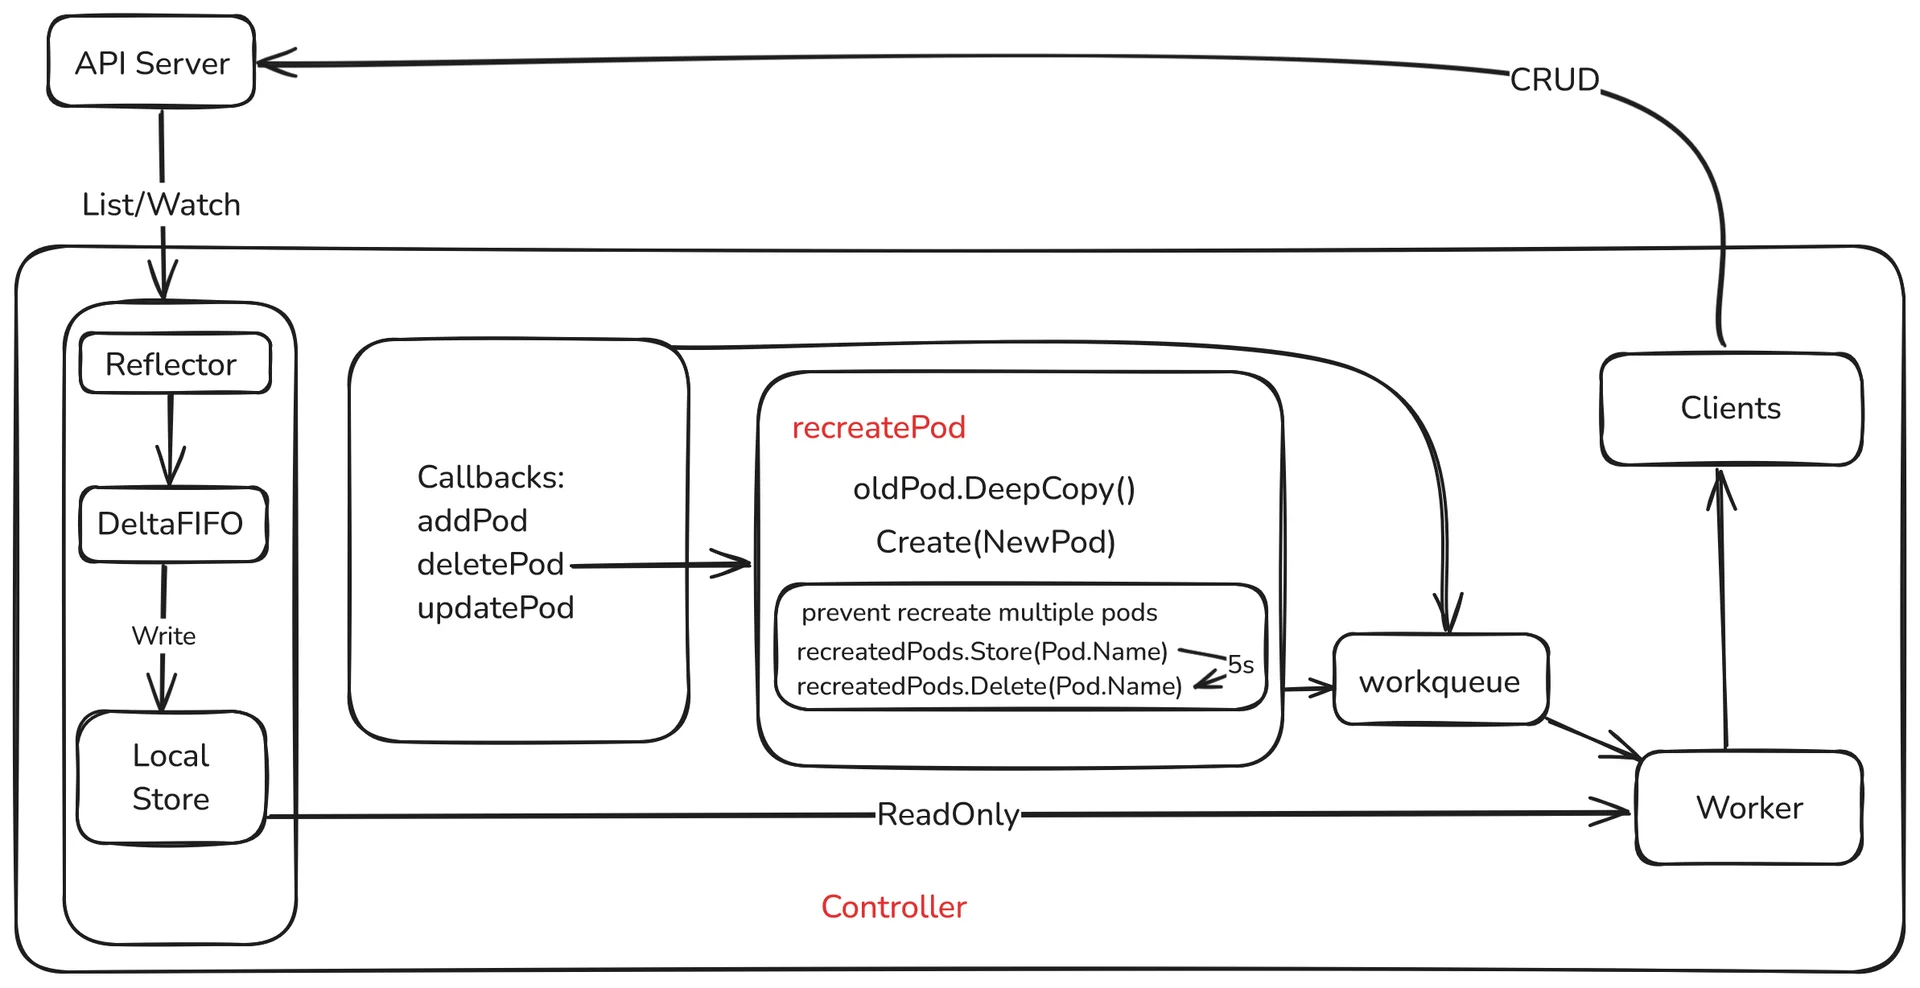
監聽刪除事件,當Informer監聽到OwnerReference為FederatedLearning的刪除事件,啟動DeletePod函式,由DeletePod函式重建pod,重新建立後的Pod會和原來的Pod幾乎一樣,保留其配置和規範,但資源版本和UID等標識會被重置,以便重新生成。
- 重建前檢查
- 檢查該pod是否被
FederatedLearningJob所擁有。 - 檢查該Pod是否已經被重新建立過: 使用
c.recreatedPods.Load(pod.Name)來檢查這個Pod是否已經被重新建立過。如果已經重新建立,則不再重複建立。
- 檢查該pod是否被
// first check if the pod is owned by a FederatedLearningJob
controllerRef := metav1.GetControllerOf(pod)
if controllerRef == nil || controllerRef.Kind != Kind.Kind {
    return
}- 重新建立Pod
- 使用
pod.DeepCopy()建立一個Pod的深複製。 - 重置一些唯一標識(如
ResourceVersion、UID)和狀態欄位。 - 透過
c.kubeClient.CoreV1().Pods(pod.Namespace).Create方法呼叫 Kubernetes API 建立新的Pod。 - 如果建立成功,記錄日誌,標記該Pod已被重新建立。
- 使用
// Create a deep copy of the old pod
newPod := pod.DeepCopy()
// Reset the resource version and UID as they are unique to each object
newPod.ResourceVersion = ""
newPod.UID = ""
// Clear the status
newPod.Status = v1.PodStatus{}
// Remove the deletion timestamp
newPod.DeletionTimestamp = nil
// Remove the deletion grace period seconds
newPod.DeletionGracePeriodSeconds = nil
_, err := c.kubeClient.CoreV1().Pods(pod.Namespace).Create(context.TODO(), newPod, metav1.CreateOptions{})
if err != nil {
    return
}- 標記已重建並設定定時器清理記錄:
- 使用
c.recreatedPods.Store(pod.Name, true)標記這個Pod已經被重新建立。 - 設定一個定時器,在5秒後清除這個標記(
c.recreatedPods.Delete(pod.Name)),這樣之後如果Pod再次被刪除,可以重新觸發重建邏輯。
- 使用
// mark the pod as recreated
c.recreatedPods.Store(newPod.Name, true)
// set a timer to delete the record from the map after a while
go func() {
    time.Sleep(5 * time.Second)
    c.recreatedPods.Delete(pod.Name)
}()我們在Controller的資料結構中增加sync.Map型別的recreatedPods,用來避免一個刪除事件中pod被重複建立。當手動刪除pod並且pod被成功建立後,pod的名稱被加入到recreatedPods中,當同一個刪除事件中deletePod再次被呼叫時,因為pod名稱已經存在於recreatedPods中,因此手動刪除的pod不會被重複刪除和重複建立。同時設定定時器,5s後清除標記,便於之後如果pod再次被手動刪除,可以重新觸發重建邏輯。
type Controller struct{
//...
preventRecreation bool
//...
}
聯合推理pod重建方案設計
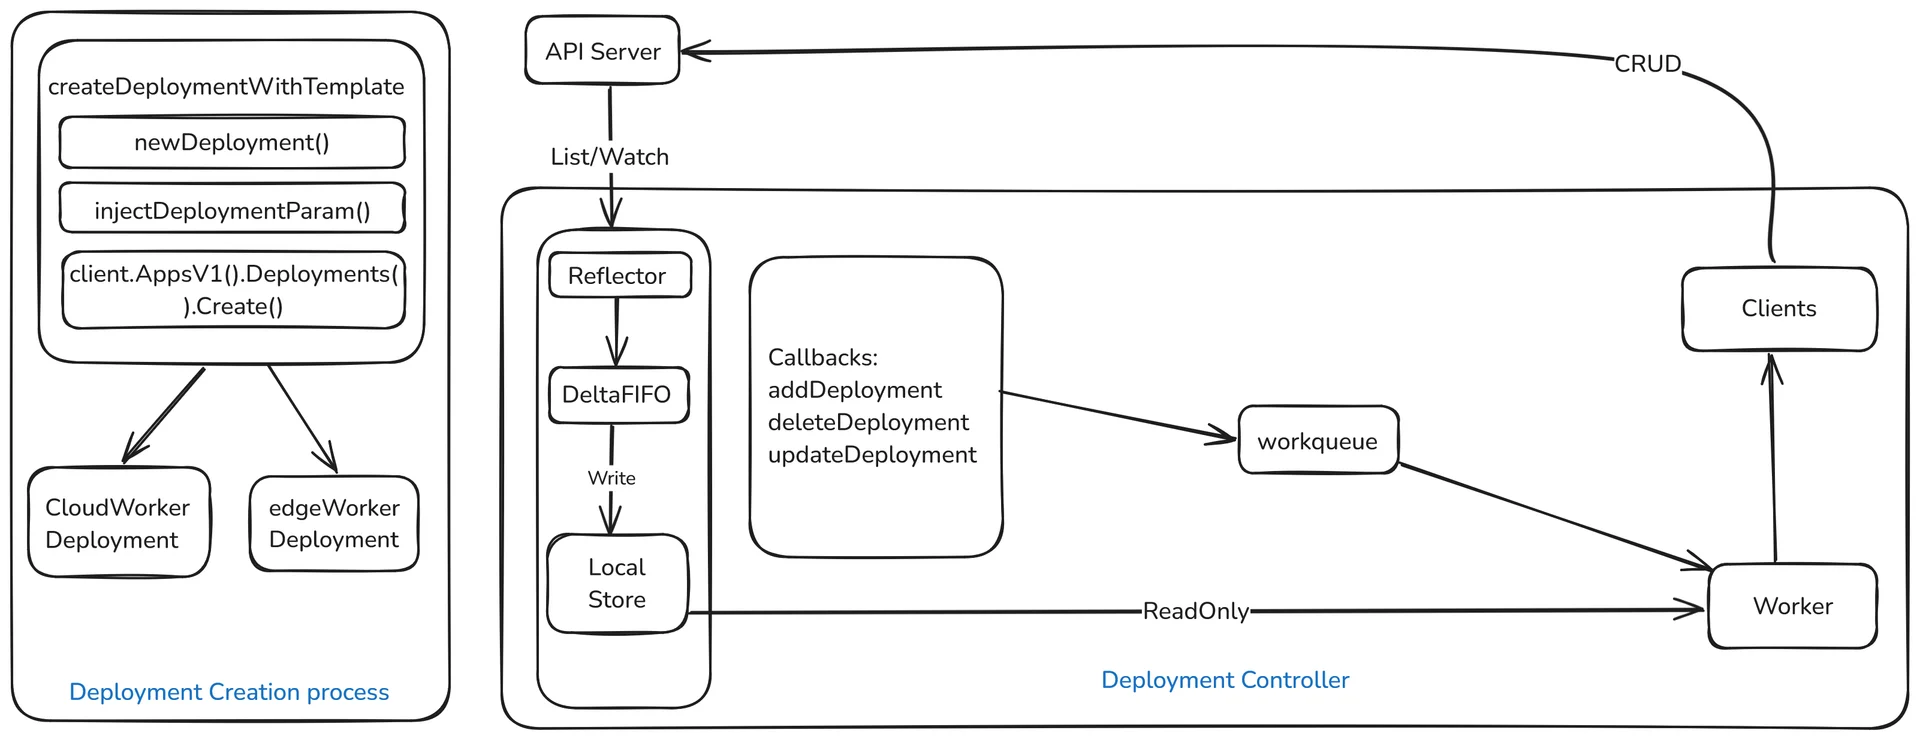
推理任務本身是無狀態負載,因此可以藉助k8s的原生元件deployment實現pod自愈。需要構建完整的監控和處理資源變化的過程。
- 從informer工廠中獲取
deployment informer資源。 - 在informer中註冊對事件的處理函式(
addDeployment、updateDeployment、deleteDeployment) - 啟動informer並且和k8s api同步資料。
- 在開始處理事件前,需要等待本地快取與API Server同步。
- 當叢集中
Deployment資源發生變化時,Informer會觸發相應的事件處理函式。
聯邦學習修改CRD更新pod
聯邦學習控制器修改CRD更新pod流程圖:
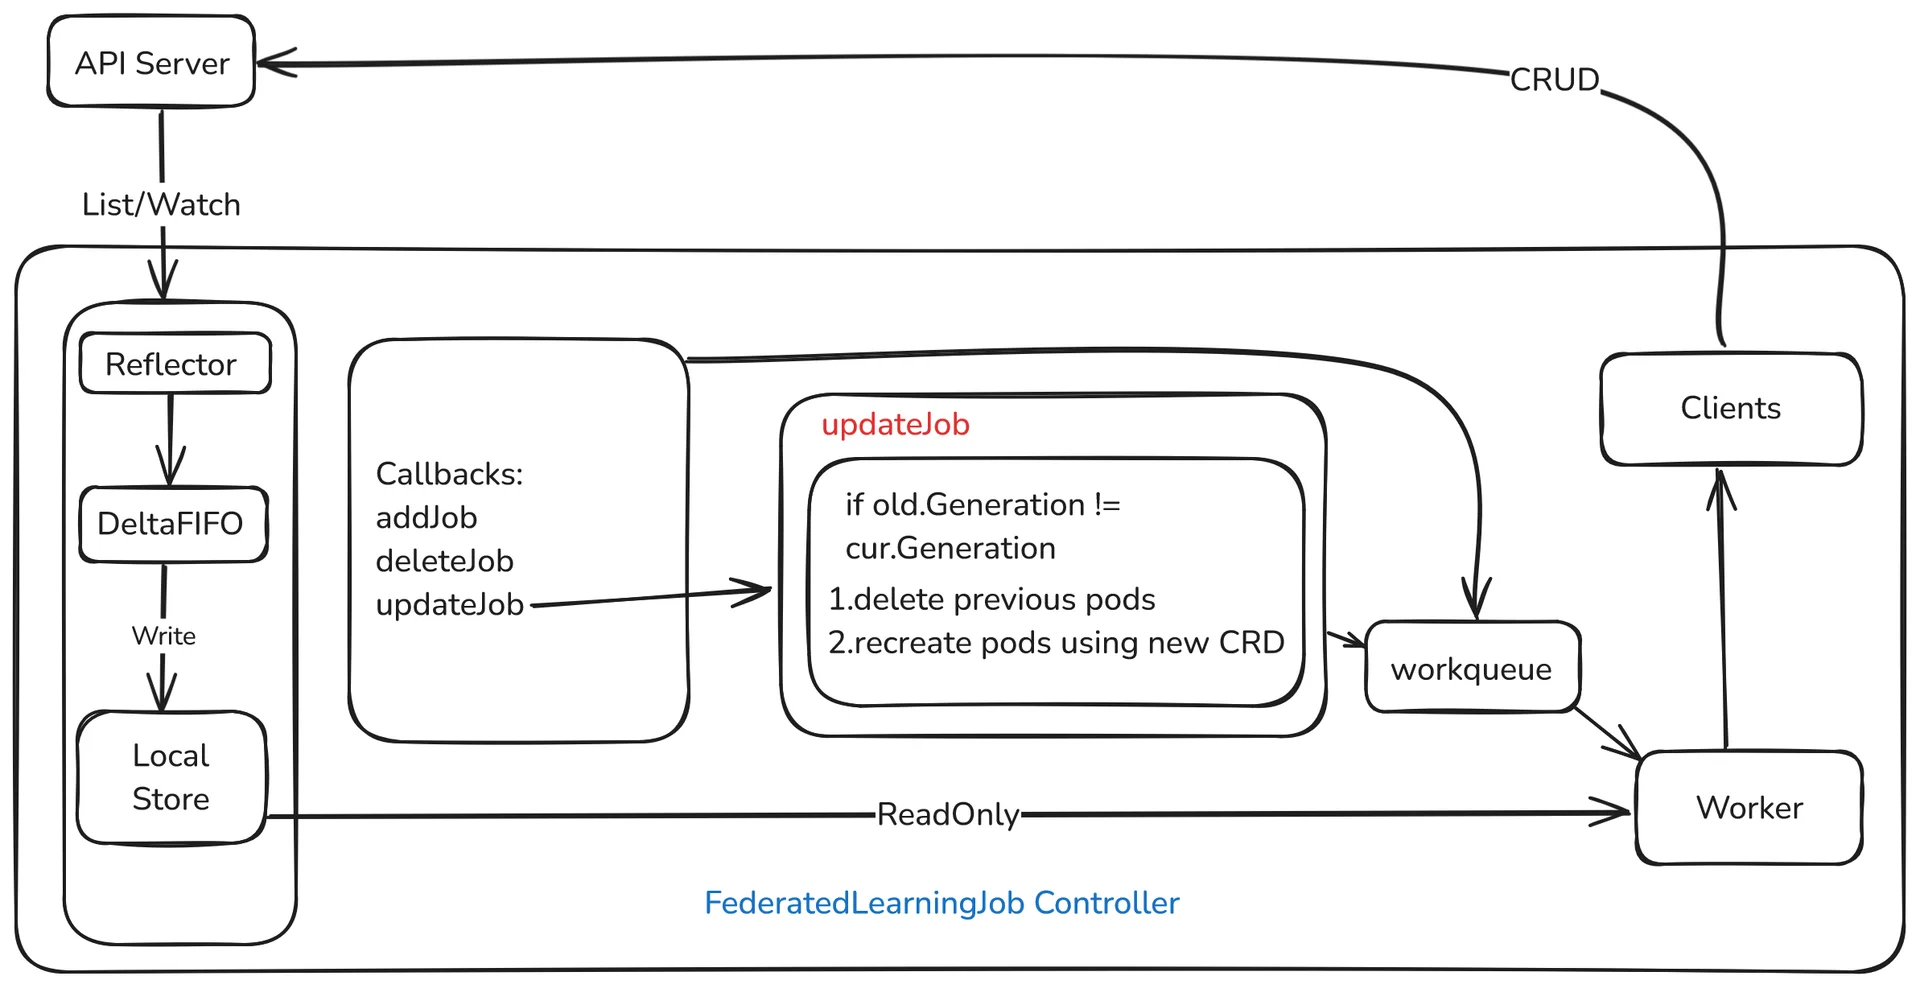
監聽更新事件,當Informer監聽到關於FederatedLearningJob的更新事件,如果CRD有修改,刪除原先的pod,並且根據CRD的新引數建立pod。
程式碼邏輯
啟動updateJob函式,updateJob函式首先進行是否需要更新的判斷。
- 如果
old和cur沒有辦法轉換成sednav1.FederatedLearningJob的物件,直接返回。 - 如果
oldJob和curJob的ResourceVersion相同則表示沒有變化,直接返回,不需要處理更新。 - 設定
preventRecreation標誌為 true,防止在更新期間重新建立 Pod。
接下來進行oldJob和curJob的引數比較。
- 比較
old.Generation和cur.Generation欄位。CRD都有一個Spec欄位Generation。該欄位是自動生成的,是每次修改/建立crd物件,都會修改,建立時為1,後面每次修改都會加1。只有當 spec 修改時,才會觸發 Generation+1,而 status 的修改不會觸發。因此可以用該欄位,判斷是 spec 修改還是 status 修改。如果不相等,則表示FederatedLearningJob的引數發生了變化。 - 然後遍歷獲取的Pod列表,刪除每個 Pod。
- 使用更新後的
curJob.Spec來重新創造AggWorker和TrainWorker。 - 將
preventRecreation標誌重置為false不影響後續pod自愈。
聯合推理修改CRD更新pod
聯合推理控制器修改CRD更新pod流程圖:
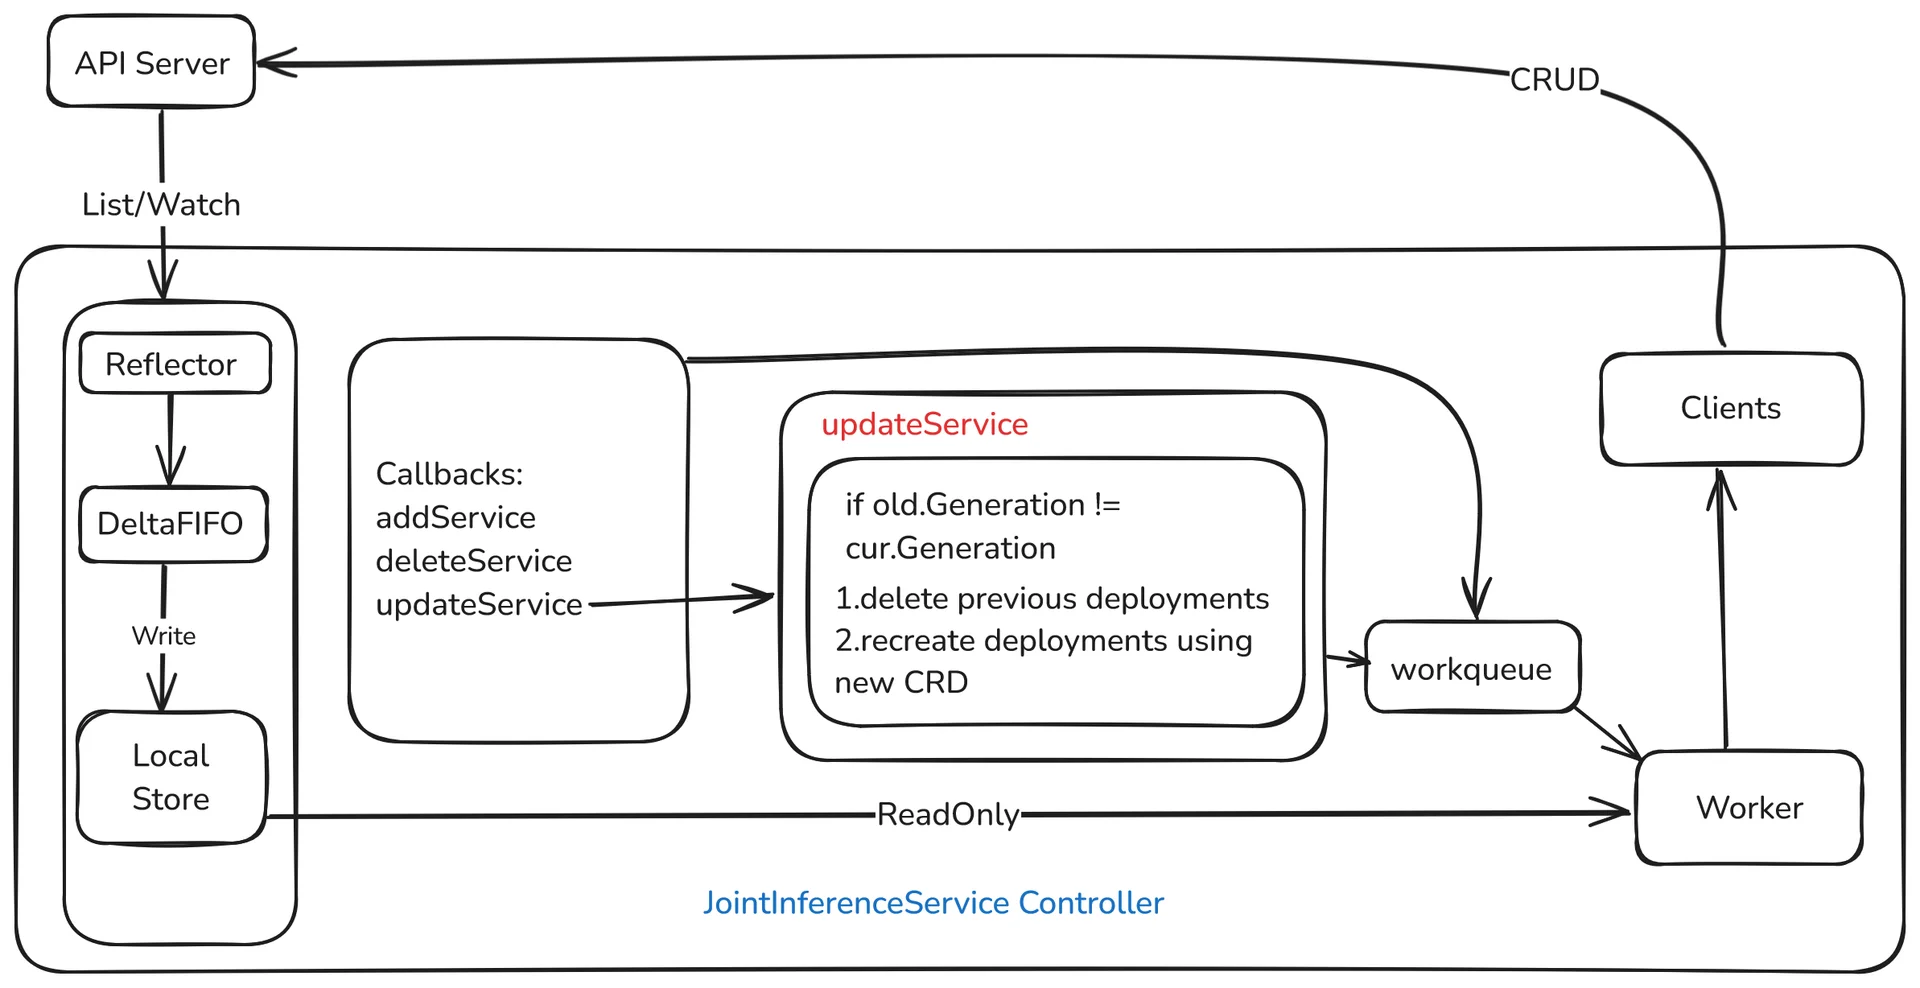
監聽更新事件,當Informer監聽到關於JointInferenceService的更新事件,如果CRD有修改,就刪除原先的pod,並且根據CRD的新引數建立pod。
程式碼邏輯
聯合推理在修改CRD更新pod的邏輯上,和聯邦學習基本一致。
啟動updateService函式,比較old.Generation和cur.Generation欄位。如果不相等,則表示JointInferenceService的引數發生了變化。
- 然後遍歷獲取的 Pod 列表,刪除每個 Pod。
- 使用更新後的
curService.Spec來重新創造cloudWorker和edgeWorker。
測試
聯邦學習單元測試
採用單元測試而非e2e測試,著重測試兩個修改後的函式deletePod()和updateJob()函式。
- 使用
fake.NewSimpleClientset()建立了一個模擬的k8s客戶端。 - 透過
fakeclient建立一個測試用的pod。 - 建立一個控制器,把
fakeclient註冊進去。 - 把測試用pod傳入
controller.deletePod()函式中,使用fakeClient.CoreV1().Pods("default").Get(context.TODO(), "test-pod", metav1.GetOptions{})檢查pod是否被重新建立,如果未被重新建立,則測試失敗。
- 建立模擬客戶端。
- 建立控制器。
- 呼叫
controller.deletePod()刪除不存在pod。 - 確認是否會有錯誤發生。
- mock pod list過程。
- 建立模擬客戶端。
- 建立資料集,模型以及相關job和pod資源。
- 初始化控制器,傳入假客戶端,測試作業和mock pod list,以及事件廣播器等必要的依賴項。
- 定義新job,並對其中部分引數進行更新(將
TrainingWorker中batch_size從32改為16). - 呼叫
updateJob函式,將舊job更新為新job,模擬實際環境中作業更新過程。 - 驗證更新結果,如果更新後引數符合預期,測試透過。
聯合推理單元測試
- 建立Sedna和Kubernetes的偽客戶端。
- 建立old service,其中包含了對雲端worker和邊端worker的配置資訊。建立兩種模型資源。
- 根據old service建立建立deployment和pod資源。
- 初始化控制器controller,為其設定偽客戶端、pod列表、deployment列表。
- 控制器的
sendToEdgeFunc被設定為一個空函式(不執行實際的邊緣通訊)。 - 複製了舊的聯合推理服務,並修改邊緣worker中的硬示例挖掘引數,將其值從
value1更改為value2,同時增加了服務的Generation值。 - 呼叫控制器的
updateService函式,觸發對聯合推理服務的更新。 - 測試驗證了是否成功透過偽客戶端獲取到更新後的聯合推理服務。
- 檢查更新後的HEM引數是否已從
value1正確更新為value2,確保服務更新邏輯正確執行。