
KubeEdge-Sedna
コード倉庫:https://github.com/kubeedge/sedna
関連PR:
- initial proposal
- updated proposal
- JointInferenceService controller enhancement
- FederatedLearning controller enhancement
コントローラ部分が完全に整ってからまとめようと思っていたが、あとの改善方法が最初の試みの考え方と違うと分かったので、バージョンを分けて記録することにした。v1の大部分はオープンソースの夏(OSPP)の内容だ。proposalとは違うところがある。kubernetes と kubeedge、sedna への理解が進むにつれ、もっと深く入りたい。
最適化の需要
- 連合推論と連邦学習がカスケード削除を正常にできない。
kubectl delete JointInferenceService/FederatedLearningJob **のとき、子リソースが一緒に削除されない。 kubectl edit FederatedLearningJob/JointInferenceService **でカスタムリソース設定を更新しても、管理している子リソース pod は更新されない。- 手動削除や誤操作で pod を消したとき、pod が再作成されてほしい。
カスケード削除
kubernetes のカスケード削除
kubernetes の Owner Reference は、オブジェクト間の関連をコントロールプレーンに伝える。kubernetes は Owner Reference(オーナー参照)により、あるオブジェクトを削除するとき関連リソースを掃除する能力をコントロールプレーンと他の API クライアントに与える。ほとんどの場合、kubernetes が Owner Reference を自動管理する。ガベージコレクタがカスケード削除を実現する。
Kubernetes の論理は、あるリソースを消したとき、他リソースの Metadata の ownerReference がそのリソースを指していれば、それらのリソースはカスケード削除される、というものだ。この振る舞いは設定でき、デフォルトは true。
各リソースの metadata には ownerReferences フィールドがある。配列で、そのリソースの owner を表す。owner リソースが削除されるたび、配列から外される。すべての owner が消えたら、GC がそのリソースを回収する。
これさえ分かれば、あった問題はスムーズに解ける。kubernetes がカスケード削除を自動管理するので、正しい owner reference を置けば正常にカスケード削除できる。正常にできていなかったのは、owner reference を正しく置けていなかったからだ。あとはタスク作成と pod 作成のロジックを探せばよい。
連合推論と連邦学習の owner reference 関係
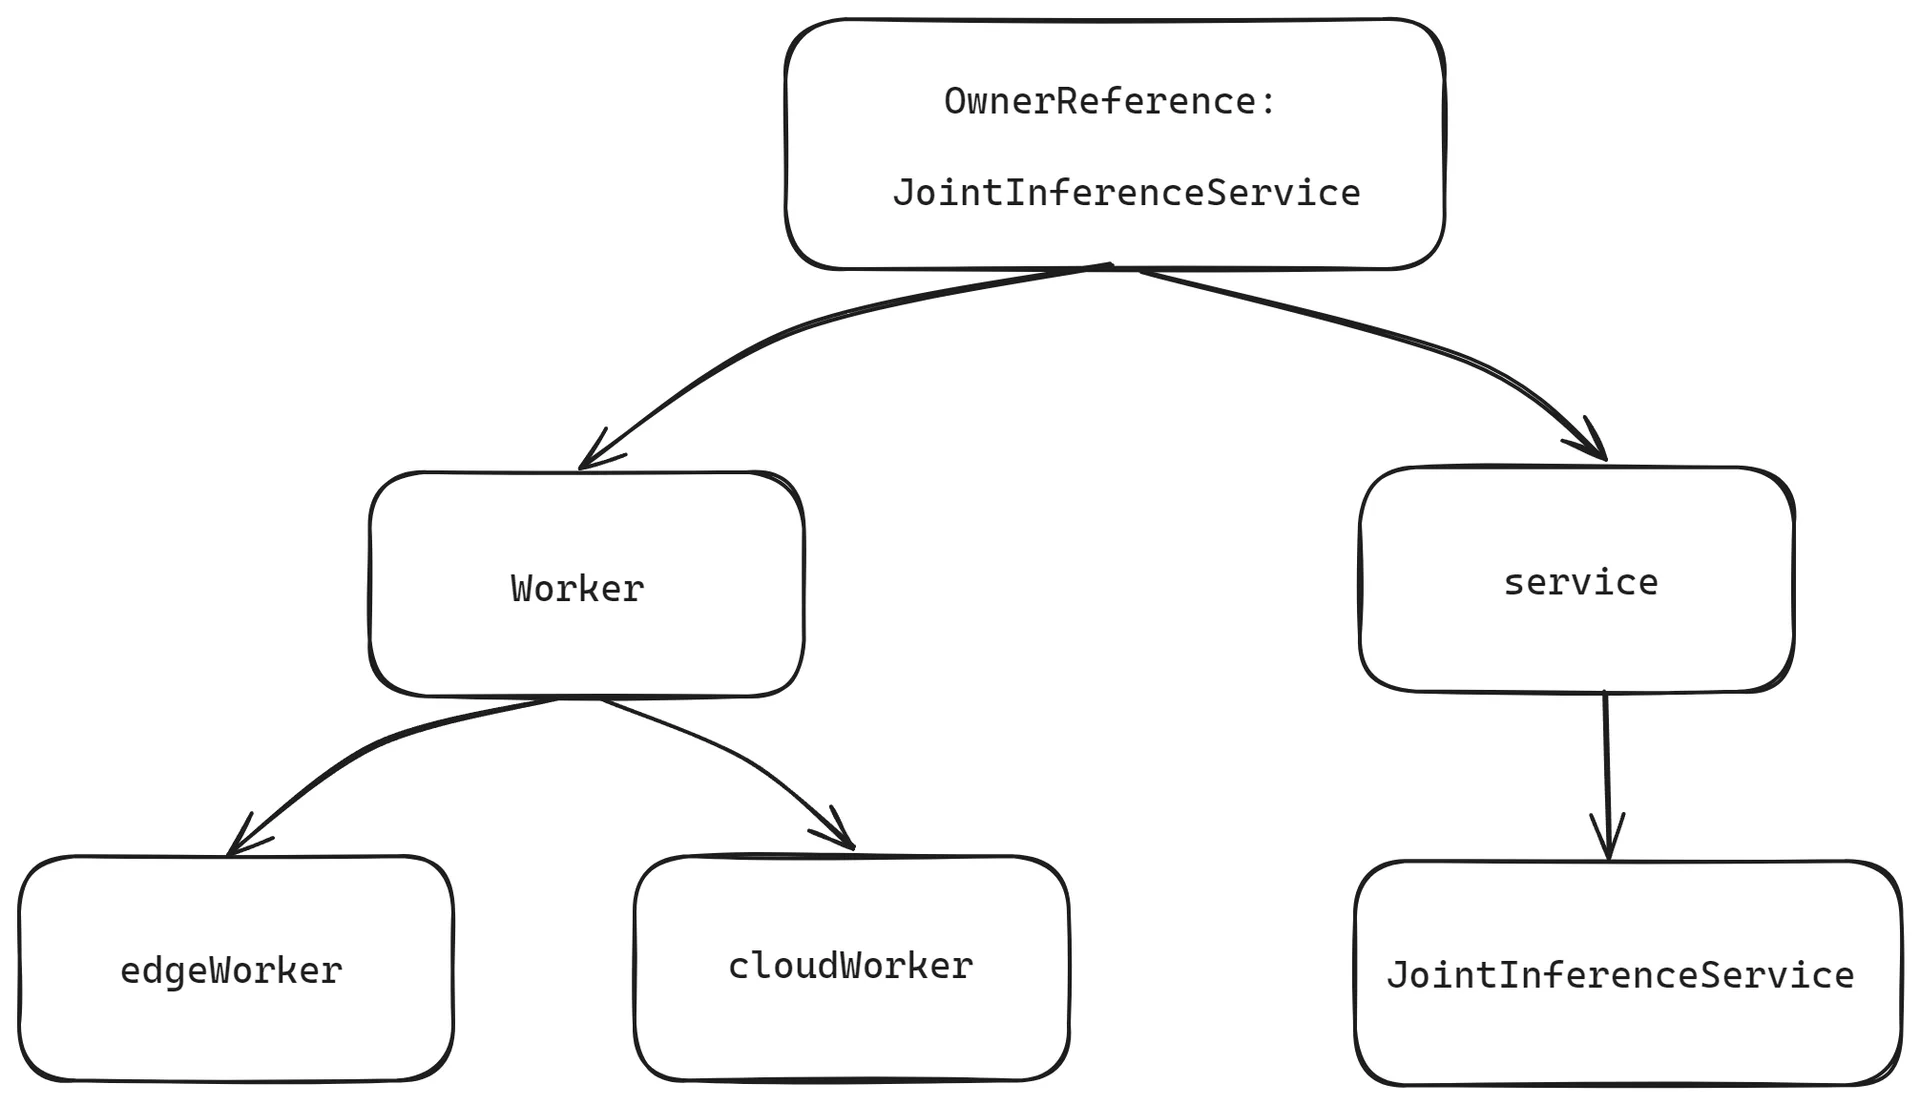
JointInferenceService 連合推論
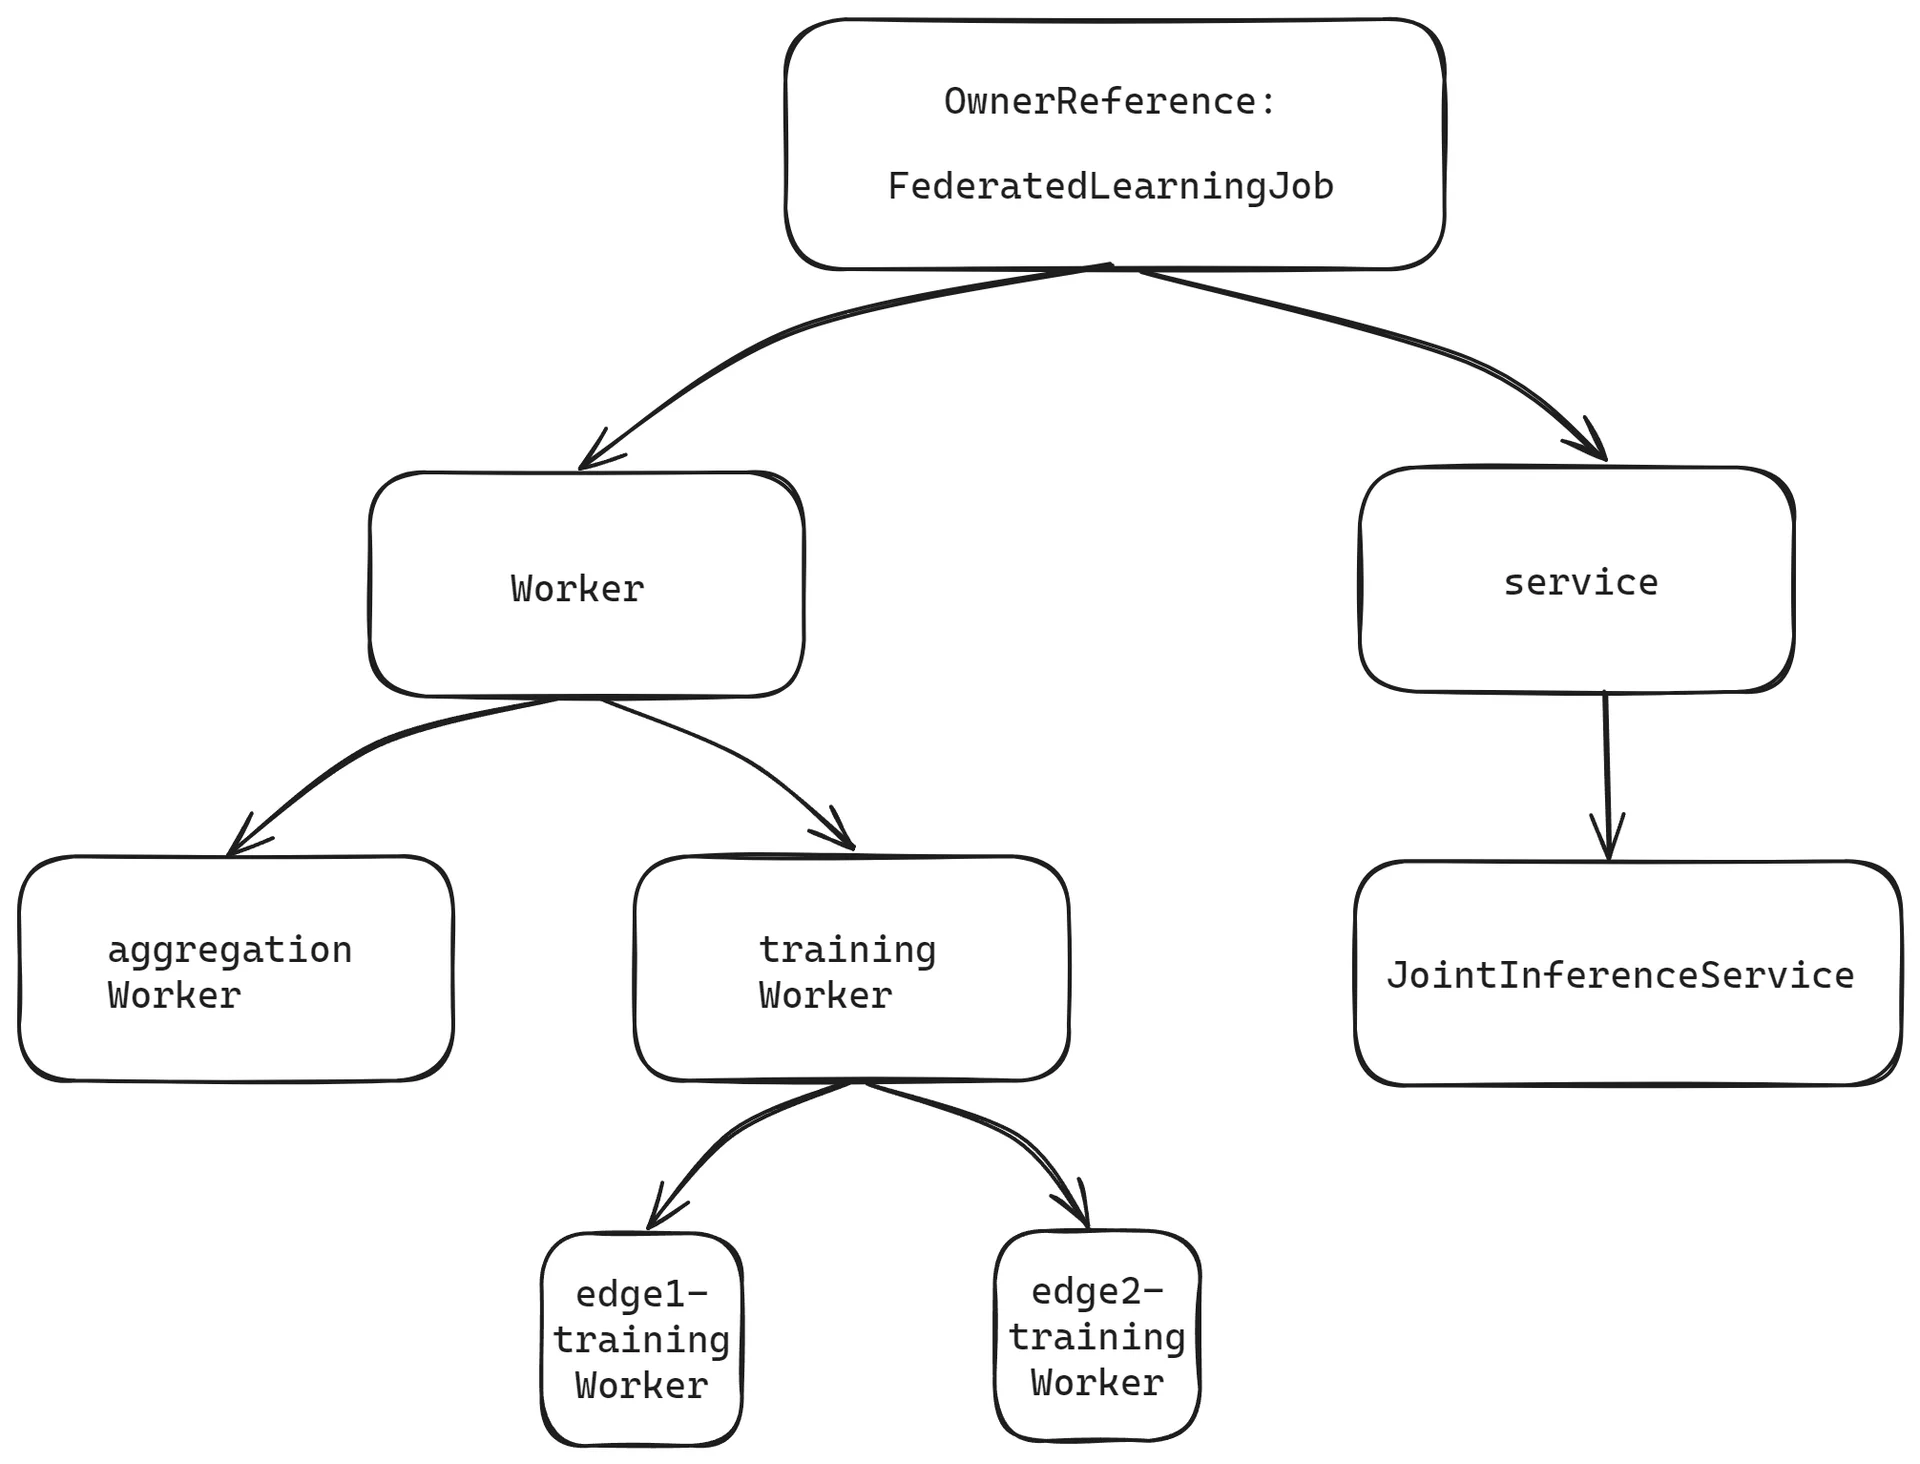
FederatedLearningJob 連邦学習
連合推論コントローラの owner reference 設定過程
連合推論コントローラを例に、Ownerreference の設定過程を分析する。
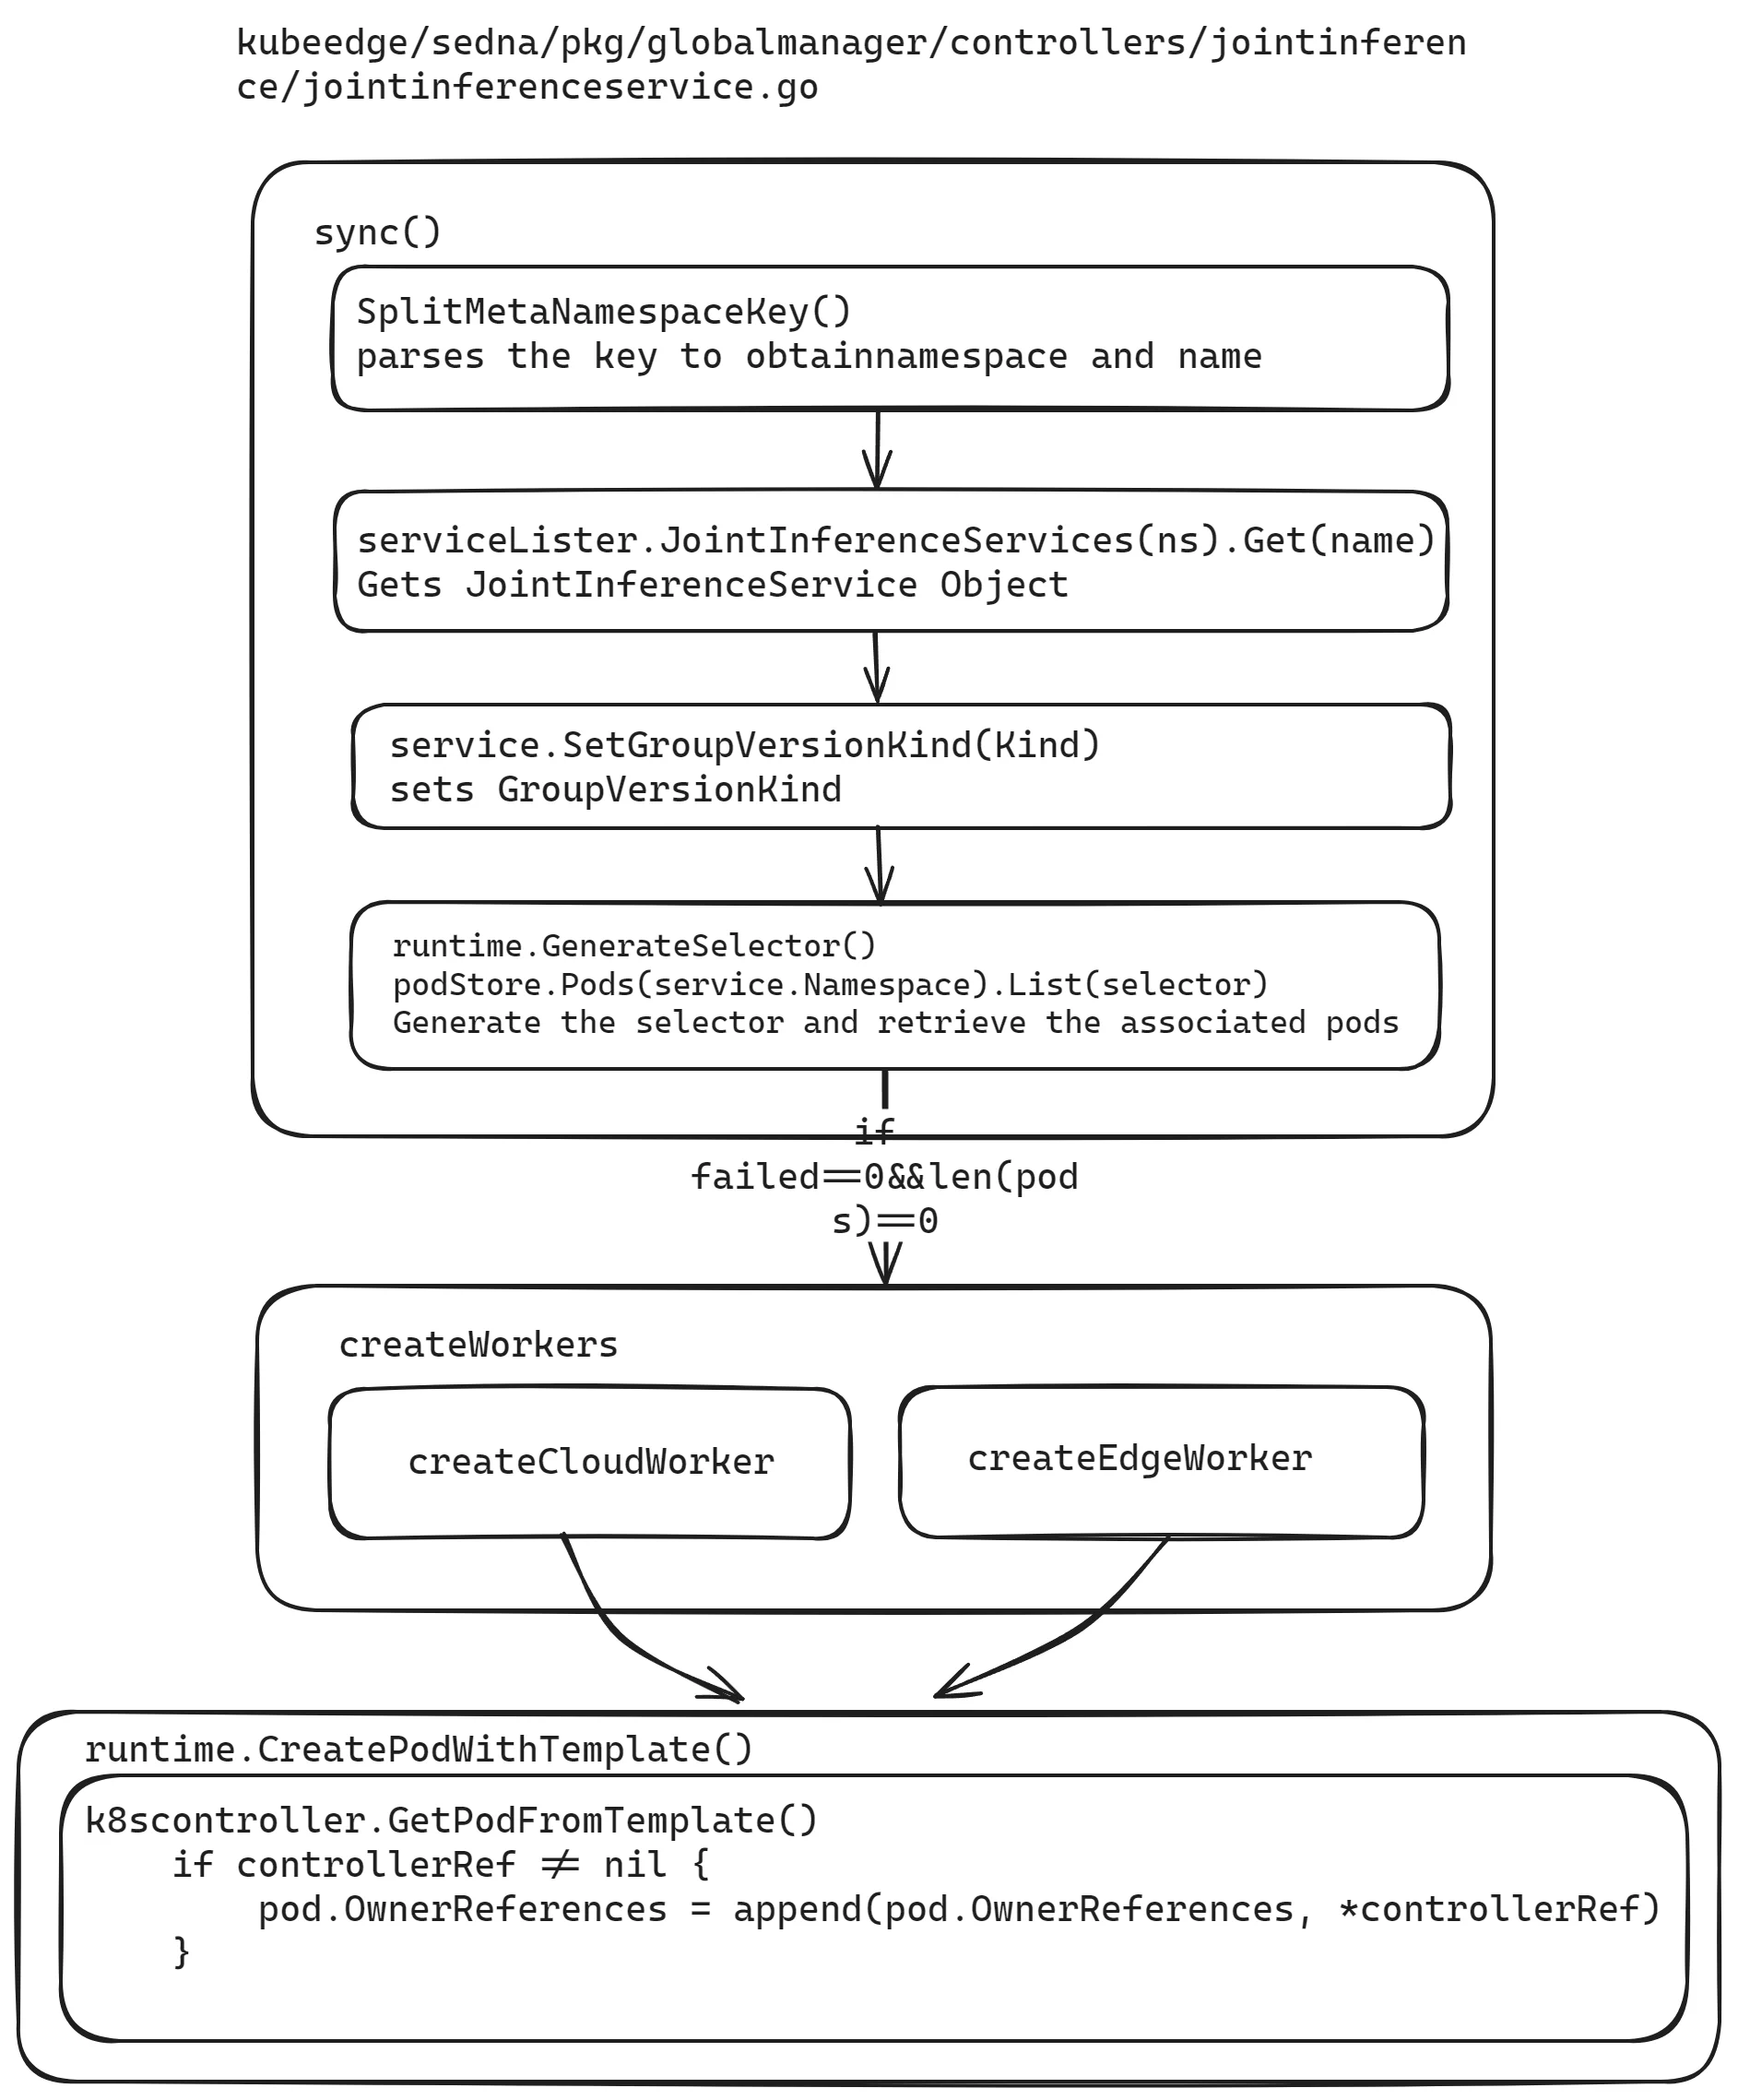
owner reference の定義過程全体に問題はない。問題があるのは、渡している変数だ。
pkg/globalmanager/controllers/jointinference/jointinferenceservice.go で、まず controller name と CR の kind name を定義している。Ownerreference に渡すべきは kind name であり、コントローラの名前ではない。
// Name is this controller name
Name = "JointInference"

// KindName is the kind name of CR this controller controls
KindName = "JointInferenceService"
ここで CR の kind name を定義する。注意すべきは、元のコードでは Name(JointInference)を渡していたこと。実際に渡すべきは Kind Name(JointInferenceService)だ。
// Kind contains the schema.GroupVersionKind for this controller type.
var Kind = sednav1.SchemeGroupVersion.WithKind(KindName)
run 関数がコントローラを起動する。まず worker 数を定義し、その数に応じて作業スレッドを立て、作業キューからタスクを取って処理し続ける。
for i := 0; i < workers; i++ { go wait.Until(c.worker, time.Second, stopCh) }run のこのコードでは、wait.Until が goroutine を起動し、c.worker を呼び続け、呼び出し間隔は1秒、stopCh が閉じるまで続く。
// worker runs a worker thread that just dequeues items, processes them, and marks them done.
// It enforces that the sync is never invoked concurrently with the same key.
func (c *Controller) worker() {
    for c.processNextWorkItem() {
    }
}
worker は processNextWorkItem() を呼び、キューからタスクを取って処理し、sync で具体的な同期を実行する。キューが閉じるまで。
ns, name, err := cache.SplitMetaNamespaceKey(key)
if err != nil {
    return false, err
}
if len(ns) == 0 || len(name) == 0 {
    return false, fmt.Errorf("invalid jointinference service key %q: either namespace or name is missing", key)
}
sync では cache.SplitMetaNamespaceKey が key を解析して namespace と name を取る。
sharedService, err := c.serviceLister.JointInferenceServices(ns).Get(name)
if err != nil {
    if errors.IsNotFound(err) {
        klog.V(4).Infof("JointInferenceService has been deleted: %v", key)
        return true, nil
    }
    return false, err
}
service := *sharedService
lister から JointInferenceService オブジェクトを取る。
service.SetGroupVersionKind(Kind)GroupVersionKind を設定する。
selector, _ := runtime.GenerateSelector(&service)
pods, err := c.podStore.Pods(service.Namespace).List(selector)
if err != nil {
    return false, err
}
klog.V(4).Infof("list jointinference service %v/%v, %v pods: %v", service.Namespace, service.Name, len(pods), pods)
セレクタを生成し、関連 pods を取る。
失敗 worker が無いとき、関連 pods が 0 なら createWorkers を呼んで pod を作る。
else {
        if len(pods) == 0 {
            active, manageServiceErr = c.createWorkers(&service)
        }
createWorkers は createCloudWorker と createEdgeWorker を呼んでクラウド/エッジの作業 pod を作る。
二つの関数の中で、runtime.CreatePodWithTemplate が pod を作り、その中の k8scontroller.GetPodFromTemplate が Ownerreference を設定する。効いているのは次のコードだ。
if controllerRef != nil {
    pod.OwnerReferences = append(pod.OwnerReferences, *controllerRef)
}
Pod 再作成
Pod が故障したときの自動再作成は再起動ポリシー(RestartPolicy)で決まる。
JointInferenceService では RestartPolicy を置いていないので、デフォルトは always。連合推論タスクの途中でプログラムの問題が出ると、例えば EdgeMesh が正しく設定されず、エッジがクラウドの 5000 ポートに届かず大きなモデルの推論ができないと、エッジ pod は再起動を繰り返す。FederatedLearningJob では RestartPolicy を OnFailure にしている。
pod を消したときに自動作成するには、まず kubernetes の informer 機構を知る必要がある。
k8s の informer 機構
Kubernetes は Controller の代わりに Informer で API Server にアクセスする。Controller の操作はすべて Informer とやり取りし、Informer は毎回 API Server に行かない。Informer は ListAndWatch を使う。初回起動時に LIST API ですべての最新リソースオブジェクトを取り、WATCH API で変化を聞き、イベントを読み取り専用のキャッシュキューに保って問い合わせ効率を上げ、API Server の負荷を下げる。
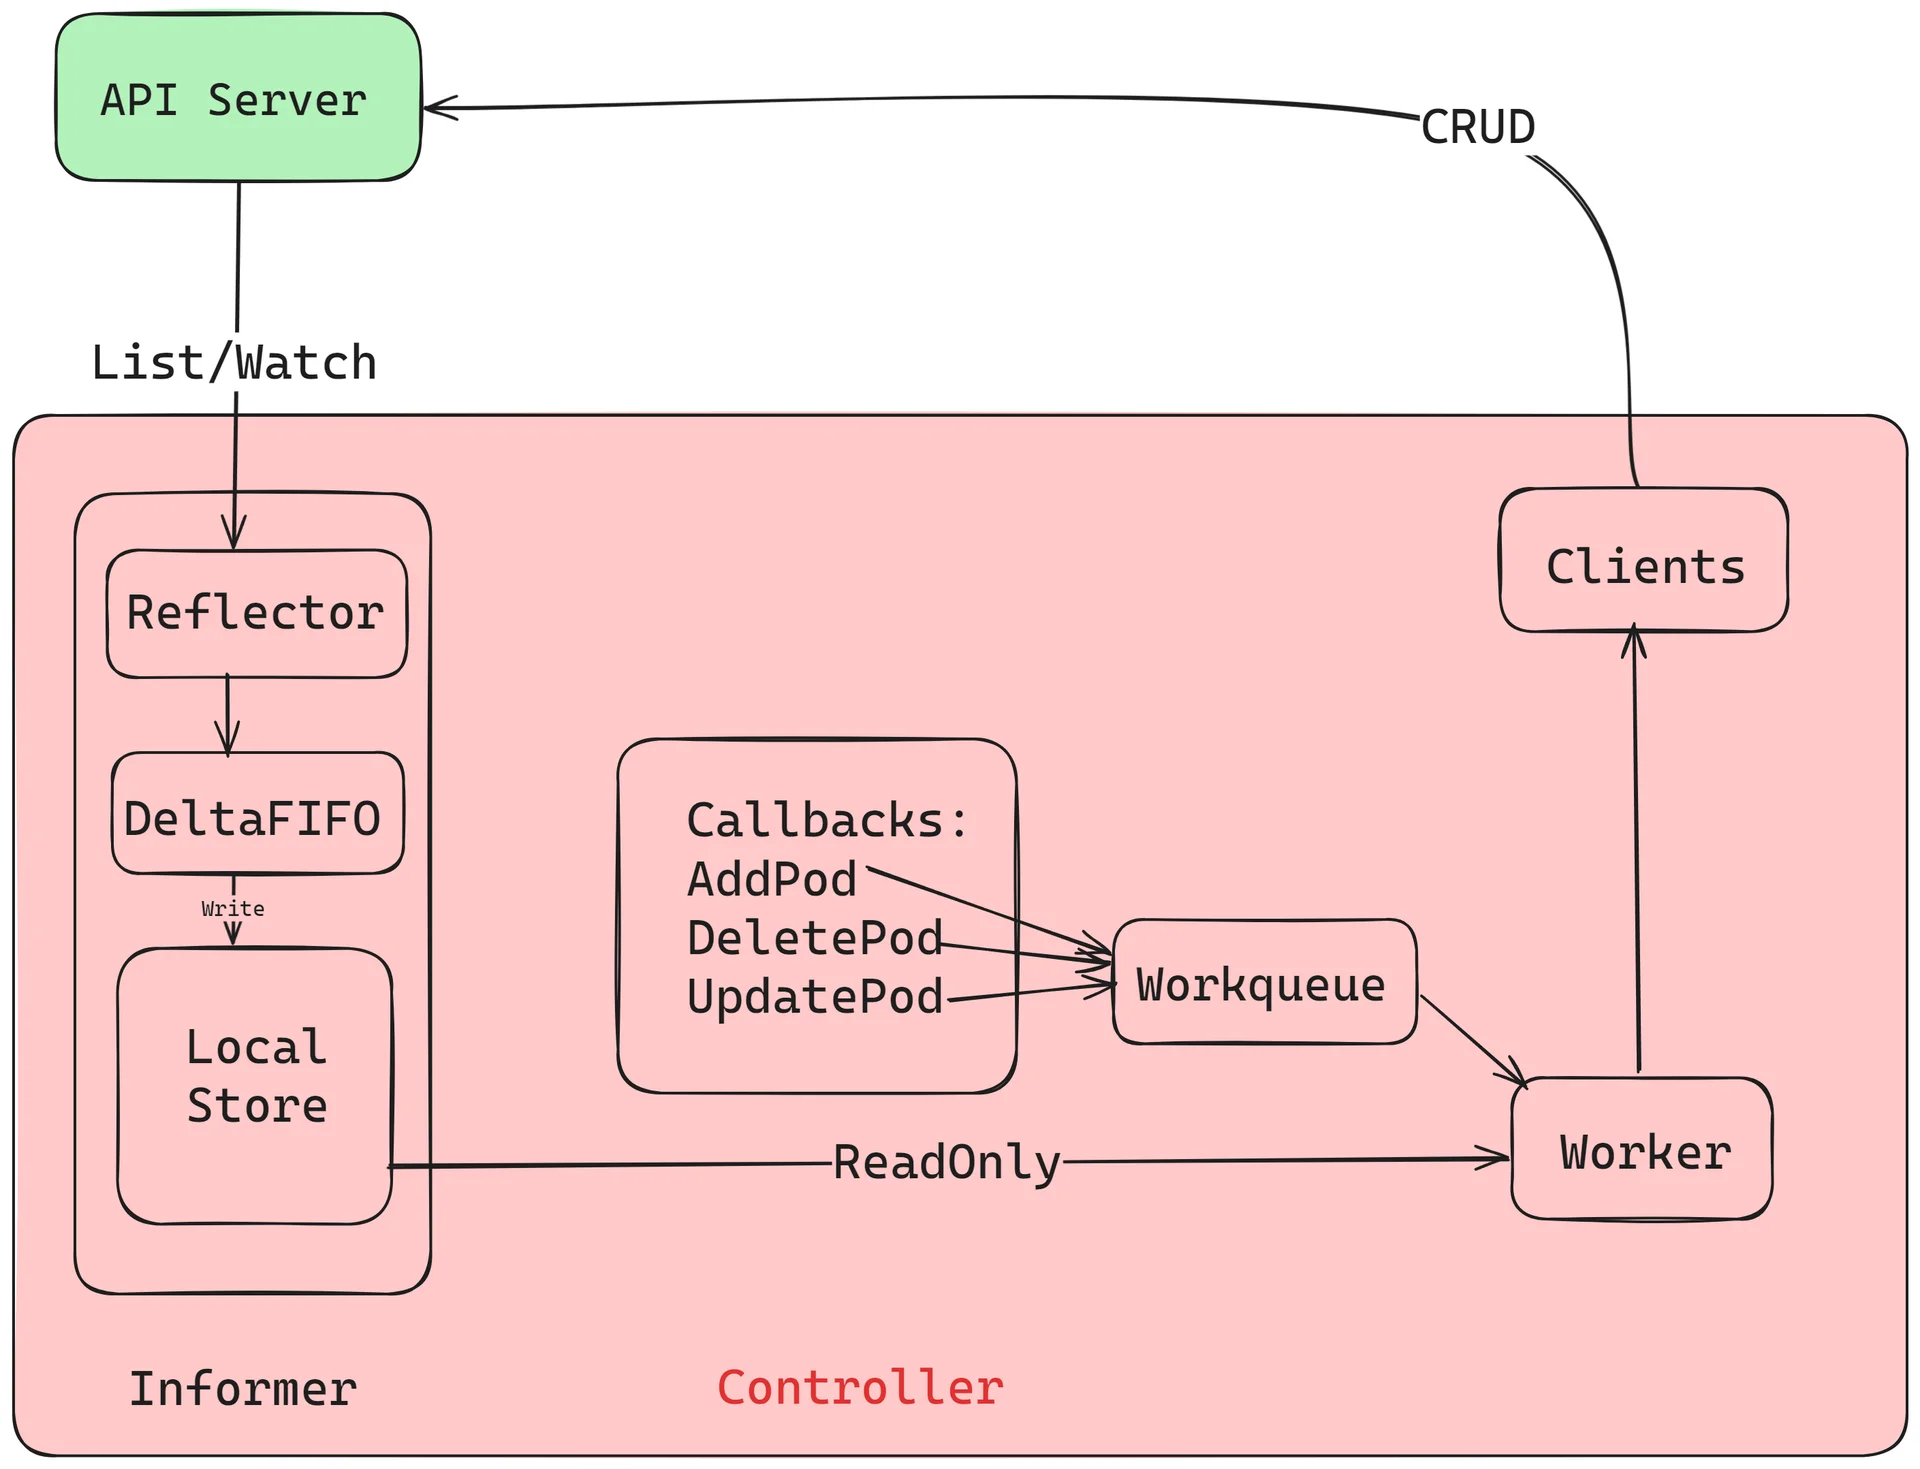
フロー図から Informer の各コンポーネントの役割:
- Controller:Informer の実施担体。reflector を作り processLoop を制御できる。processLoop は DeltaFIFO のデータを pop し、まず Indexer でキャッシュと索引を作り、processor に渡す。
- Reflector:Informer は k8s-api-server に直接行かず、Reflector というオブジェクト経由でアクセスする。Reflector は ListAndWatch で指定の kubernetes リソースを監視し、Added などの変化があると、リソースオブジェクトをローカルキャッシュ DeltaFIFO に入れる。
- DeltaFIFO:FIFO のキャッシュキュー。Watch API が返す Added、Updated、Deleted などのイベントを貯める。
- LocalStore:informer の cache。apiserver のオブジェクトをキャッシュする(一部はまだ DeltaFIFO にある)。利用者がオブジェクトを問い合わせるときは cache から探し、apiserver の圧力を減らす。LocalStore は Lister の List/Get だけが触る。
- WorkQueue:DeltaFIFO はイベントを自分の構造に貯めたあと Store のデータを操作し、store 更新後にイベントを WorkQueue に pop する。Controller は WorkQueue のイベントを受け、型に応じたコールバックを起こす。
informer の作業フロー
Informer はまず apiserver を list/watch する。Informer が使う Reflector が apiserver と接続する。Reflector は ListAndWatch で、まずそのリソースの全インスタンスを list し、最新の resourceVersion を取り、その resourceVersion 以降の変化を watch する。途中で異常があれば、切れた resourceVersion から聞き直す。インスタンスの作成・削除・更新があれば Reflector は「イベント通知」を受け、そのイベントと API オブジェクトの組は増分(Delta)と呼ばれ、DeltaFIFO に入る。
- Informer は DeltaFIFO から増分を読み続け、取り出すたびにイベント型を判断し、ローカルキャッシュ store を作るか更新する。
- イベントが Added なら、Informer は Indexer で増分の API オブジェクトをローカルキャッシュに保存し索引を作る。削除ならローカルキャッシュから消す。
- DeltaFIFO はそのイベントを controller に pop し、controller は事前登録の ResourceEventHandler を呼ぶ。
- ResourceEventHandler では、実は簡単なフィルタだけで、関心のある Object を workqueue に入れる。
- Controller は workqueue から Object を取り、worker を起こして自分の業務論理を実行する。業務論理は通常、いまのクラスタ状態とユーザーが望む状態の差を計算し、apiserver に望む状態へ進化させること、例えば deployment に新しい pods を作る、あるいは拡縮する。
- worker では lister で resource を取れ、apiserver に頻繁に行かなくてよい。apiserver の resource 変更はローカル cache に反映されるからだ。
Informer の ResourceEventHandler は三種:
// ResourceEventHandlerFuncs is an adaptor to let you easily specify as many or
// as few of the notification functions as you want while still implementing
// ResourceEventHandler.
type ResourceEventHandlerFuncs struct {
    AddFunc    func(obj interface{})
    UpdateFunc func(oldObj, newObj interface{})
    DeleteFunc func(obj interface{})
}
この三種の処理論理はユーザー定義だ。controller 初期化時に ResourceEventHandler を登録したあと、そのオブジェクトのインスタンスに作成・削除・更新があれば対応する ResourceEventHandler が発火する。
連合推論と連邦学習コントローラの informer フロー
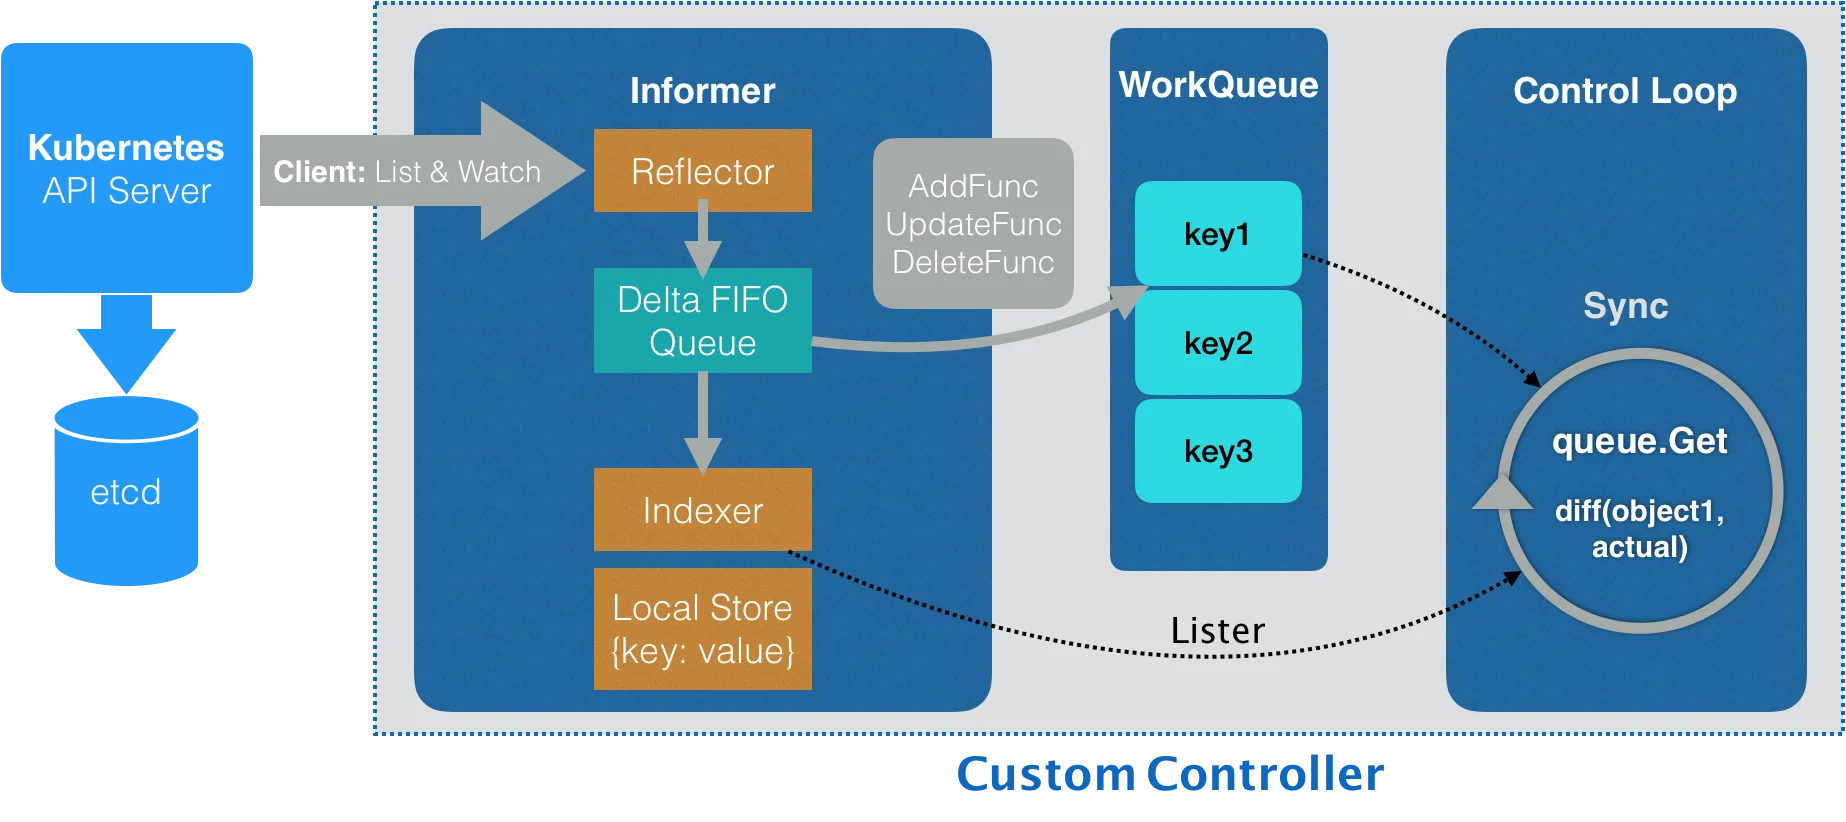
jointinferenceservice.go を例に、New() は新しい JointInferenceService コントローラを作り、関連 pod を対応する JointInferenceService と同期させる。New() で informer を初期化する。
podInformer := cc.KubeInformerFactory.Core().V1().Pods()

serviceInformer := cc.SednaInformerFactory.Sedna().V1alpha1().JointInferenceServices()
service informer はカスタム handler を使う:
serviceInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
    AddFunc: func(obj interface{}) {
        jc.enqueueController(obj, true)
        jc.syncToEdge(watch.Added, obj)
    },
    UpdateFunc: func(old, cur interface{}) {
        jc.enqueueController(cur, true)
        jc.syncToEdge(watch.Added, cur)
    },

    DeleteFunc: func(obj interface{}) {
        jc.enqueueController(obj, true)
        jc.syncToEdge(watch.Deleted, obj)
    },
})
pod informer はカスタム handler を使う:
podInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
    AddFunc:    jc.addPod,
    UpdateFunc: jc.updatePod,
    DeleteFunc: jc.deletePod,
})
ここでの EventHandler(addPod、updatePod、deletePod)は、関連オブジェクトをキューに入れるだけで、他の処理はしていない。
podInformer.Lister() が Lister() を作り Pod を取る。podInformer.Informer().HasSynced は Informer のキャッシュが同期済みかを見る。
jc.serviceLister = serviceInformer.Lister()
jc.serviceStoreSynced = serviceInformer.Informer().HasSynced
//...
jc.podStore = podInformer.Lister()
jc.podStoreSynced = podInformer.Informer().HasSynced
api server からリソースを同期する過程は、jointinferenceservice コントローラでは Run() で行われる。Run() は watch と sync を担う main goroutine を開く。
if !cache.WaitForNamedCacheSync(Name, stopCh, c.podStoreSynced, c.serviceStoreSynced) {
    klog.Errorf("failed to wait for %s caches to sync", Name)
    return

}
Informer 起動後、ローカル cache sync を待ってから workers を起動する。変更イベントを受けたら、イベントから変更 Object を取り、object key(namespace/name)を作り、key を workerqueue に入れる。
worker() が c.processNextWorkItem() を呼ぶ。
func (c *Controller) worker() {
    for c.processNextWorkItem() {
    }
}
processNextWorkItem は workerqueue から key を取り、sync() を呼ぶ。sync() では lister でローカルキャッシュから本物の object を取り、関連する同期操作を実行する。
連邦学習 pod 再作成の方案設計
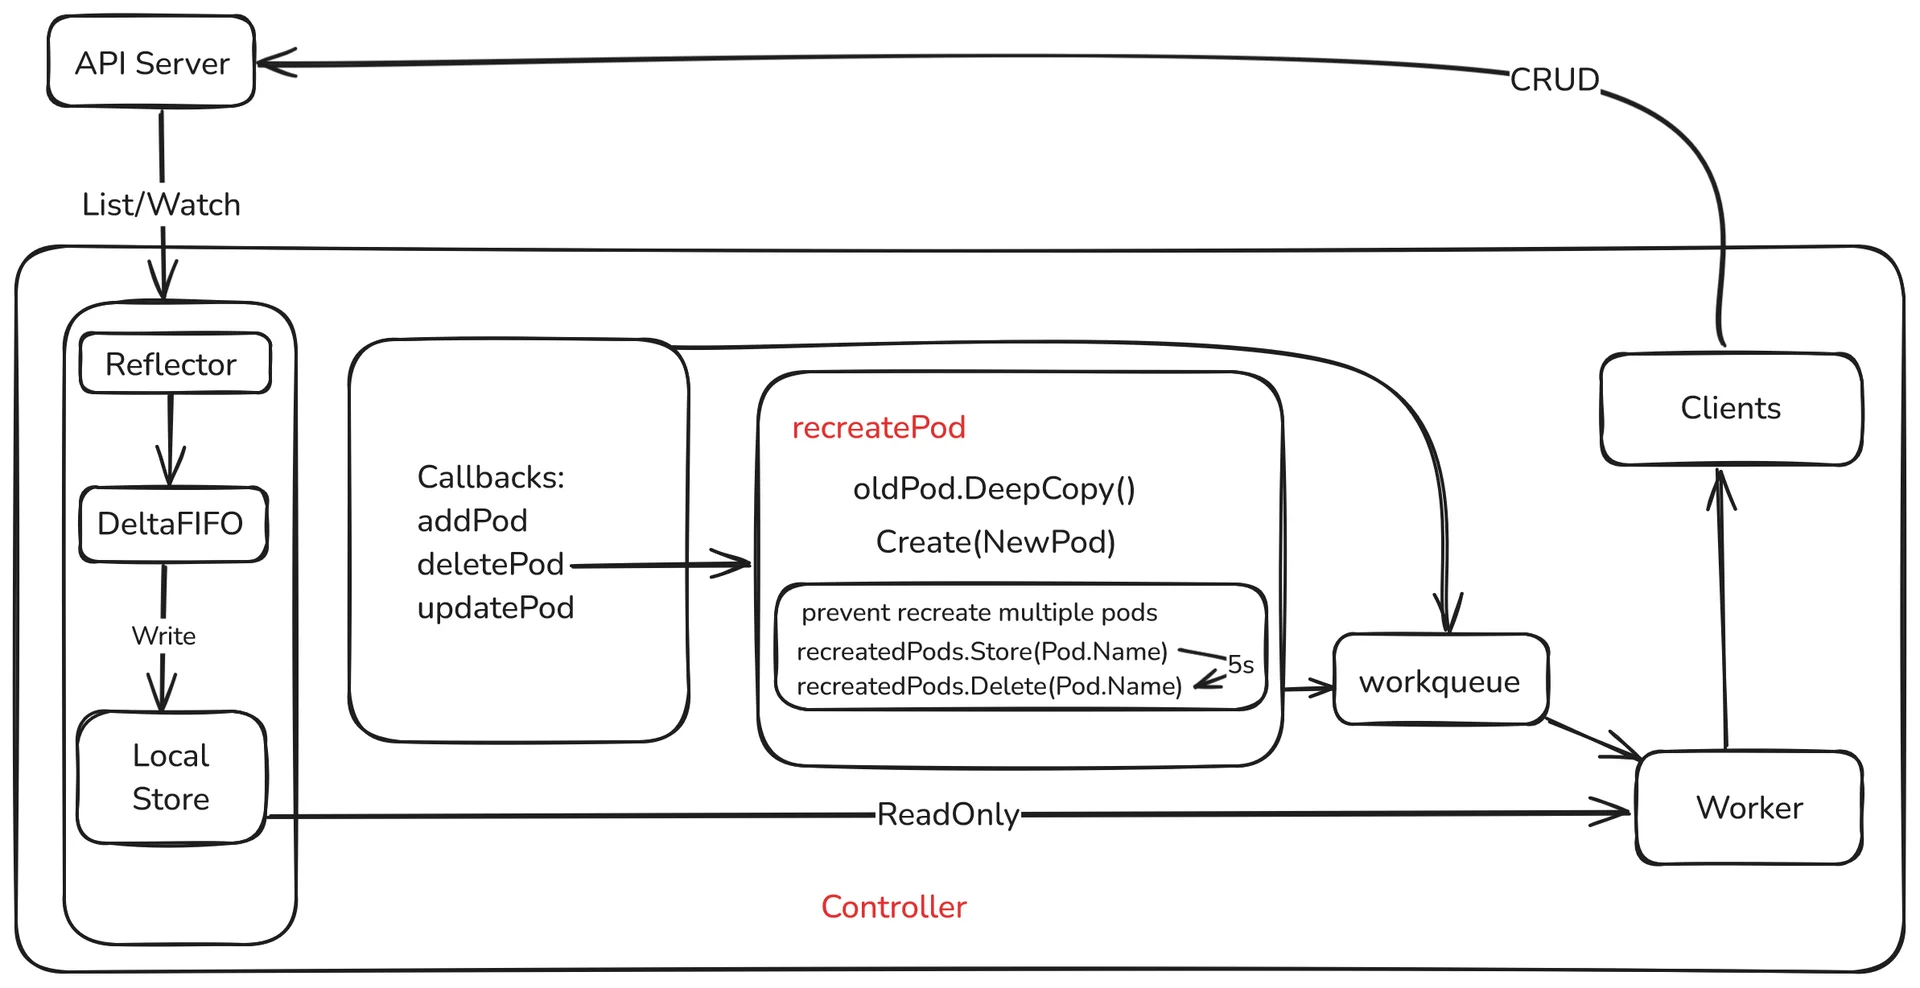
削除イベントを監視する。Informer が OwnerReference が FederatedLearning の削除を聞くと DeletePod を起動し、DeletePod が pod を再作成する。再作成後の Pod は元とほぼ同じで、設定と仕様は残し、resource version と UID などの識別はリセットして再生成する。
コード論理
- 再作成前の検査
- その pod が
FederatedLearningJobに所有されているか。 - すでに再作成済みか:
c.recreatedPods.Load(pod.Name)で見る。再作成済みなら繰り返さない。
- その pod が
// first check if the pod is owned by a FederatedLearningJob
controllerRef := metav1.GetControllerOf(pod)
if controllerRef == nil || controllerRef.Kind != Kind.Kind {
    return
}- Pod の再作成
pod.DeepCopy()で深いコピー。- 一意の識別(
ResourceVersion、UID)と状態フィールドをリセット。 c.kubeClient.CoreV1().Pods(pod.Namespace).Createで Kubernetes API を呼び新しい Pod を作る。- 成功したらログし、その Pod を再作成済みとマーク。
// Create a deep copy of the old pod
newPod := pod.DeepCopy()
// Reset the resource version and UID as they are unique to each object
newPod.ResourceVersion = ""
newPod.UID = ""
// Clear the status
newPod.Status = v1.PodStatus{}
// Remove the deletion timestamp
newPod.DeletionTimestamp = nil
// Remove the deletion grace period seconds
newPod.DeletionGracePeriodSeconds = nil
_, err := c.kubeClient.CoreV1().Pods(pod.Namespace).Create(context.TODO(), newPod, metav1.CreateOptions{})
if err != nil {
    return
}- 再作成済みをマークし、タイマで記録を消す:
c.recreatedPods.Store(pod.Name, true)で再作成済みとマーク。- 5秒後にマークを消すタイマ(
c.recreatedPods.Delete(pod.Name))。あとでまた削除されても再作成を起こせる。
// mark the pod as recreated
c.recreatedPods.Store(newPod.Name, true)
// set a timer to delete the record from the map after a while
go func() {
    time.Sleep(5 * time.Second)
    c.recreatedPods.Delete(pod.Name)
}()
Controller の構造に sync.Map 型の recreatedPods を足し、一つの削除イベントで pod が重複作成されないようにする。手動削除して pod が成功裏に作られたあと、名前が recreatedPods に入り、同じ削除イベントで deletePod が再呼び出しされても、名前が既にあるので重複削除・重複作成しない。タイマで 5s 後にマークを消し、あとでまた手動削除されたら再作成を起こせる。
type Controller struct{
//...
preventRecreation bool
//...
}
連合推論 pod 再作成の方案設計
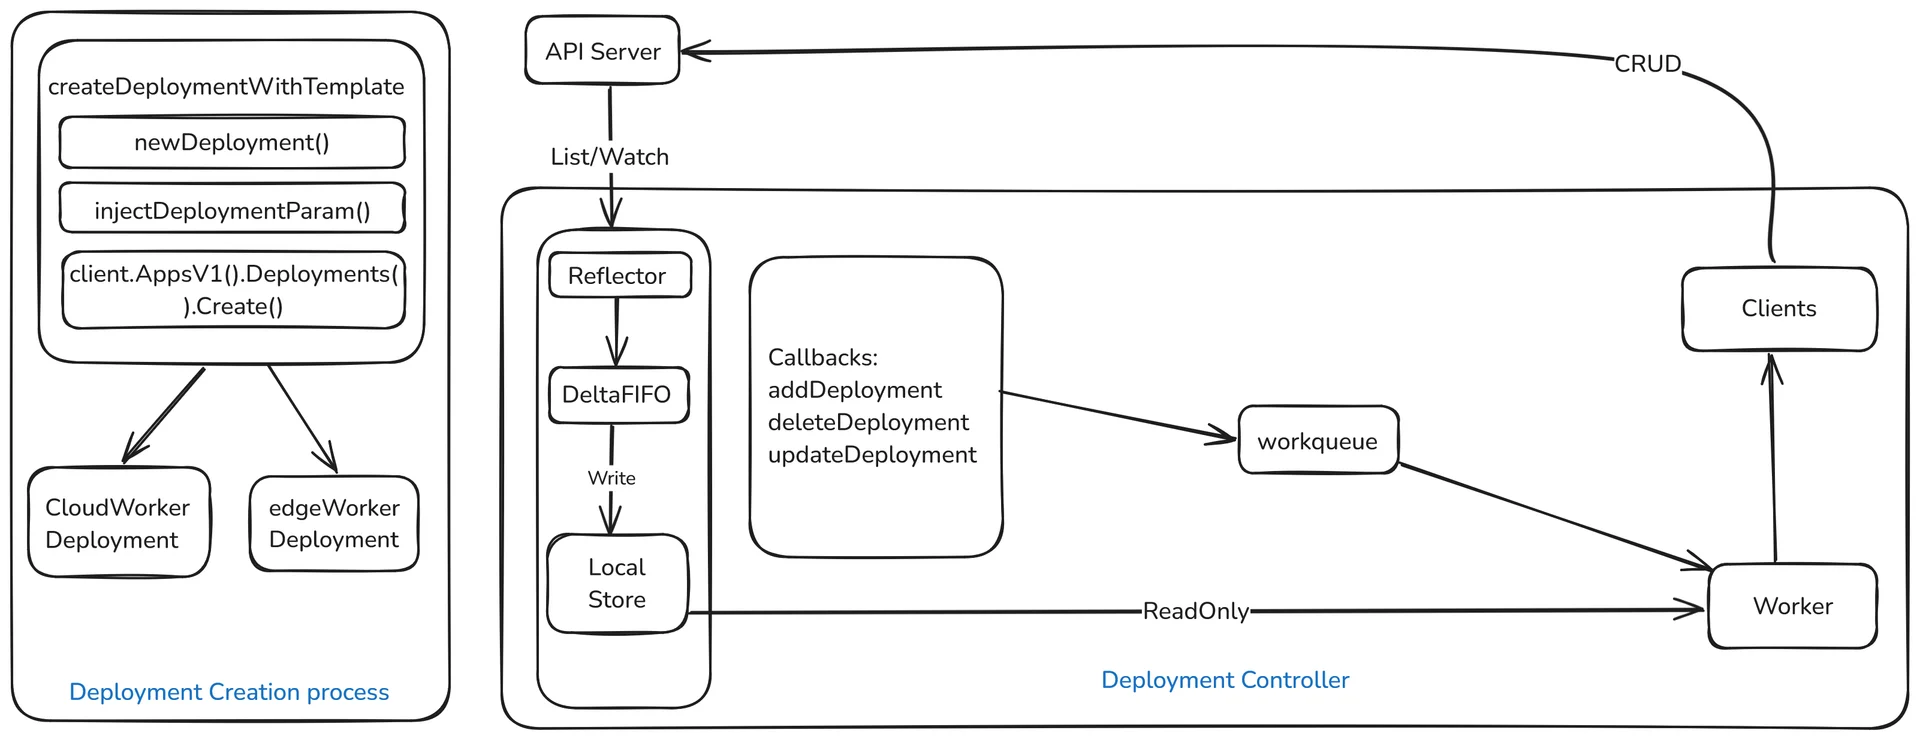
推論タスク自体はステートレス負荷なので、k8s のネイティブ deployment で pod 自己修復ができる。リソース変化の監視と処理の過程を一通り組む必要がある。
- informer 工場から
deployment informerを取る。 - informer にイベント処理関数を登録(
addDeployment、updateDeployment、deleteDeployment) - informer を起動し k8s api とデータを同期。
- イベント処理の前に、ローカルキャッシュと API Server の同期を待つ。
- クラスタの
Deploymentが変わると、Informerが対応するイベント処理関数を起こす。
連邦学習で CRD を変更して pod を更新
連邦学習コントローラが CRD 変更で pod を更新するフロー:
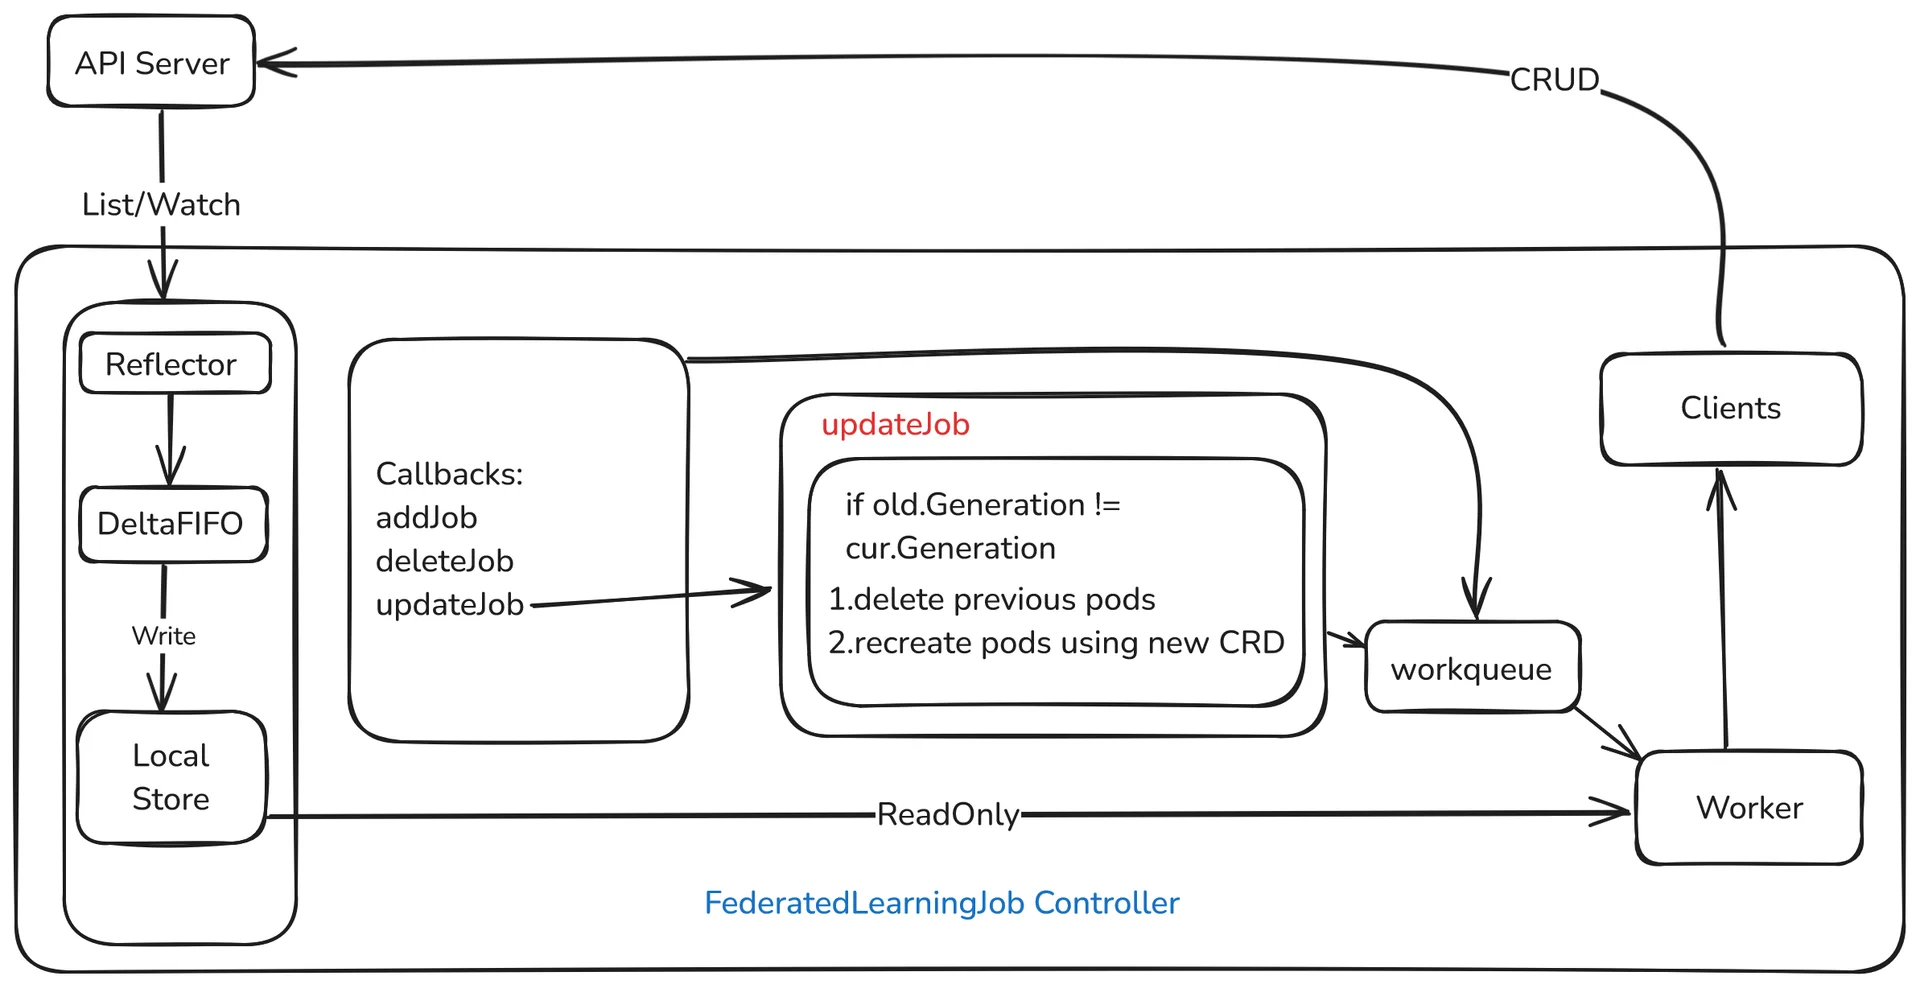
更新イベントを監視する。Informer が FederatedLearningJob の更新を聞いたとき、CRD に変更があれば元の pod を消し、新しいパラメータで pod を作る。
コード論理
updateJob を起動する。updateJob はまず更新が要るかを判断する。
oldとcurがsednav1.FederatedLearningJobに変換できなければ return。oldJobとcurJobのResourceVersionが同じなら変化なし、return。更新処理は不要。preventRecreationを true にし、更新中の Pod 再作成を防ぐ。
次に oldJob と curJob のパラメータを比較する。
old.Generationとcur.Generationを比較。CRD には Spec の Generation がある。自動生成で、crd オブジェクトを変更/作成するたびに変わる。作成時は 1、以後の変更で +1。spec 変更のときだけ Generation+1、status 変更では起きない。だから spec か status かを判断できる。不等ならFederatedLearningJobのパラメータが変わった。- 取得した Pod リストを走査し、各 Pod を削除。
- 更新後の
curJob.SpecでAggWorkerとTrainWorkerを再作成。 preventRecreationをfalseに戻し、あとの pod 自己修復を妨げない。
連合推論で CRD を変更して pod を更新
連合推論コントローラが CRD 変更で pod を更新するフロー:
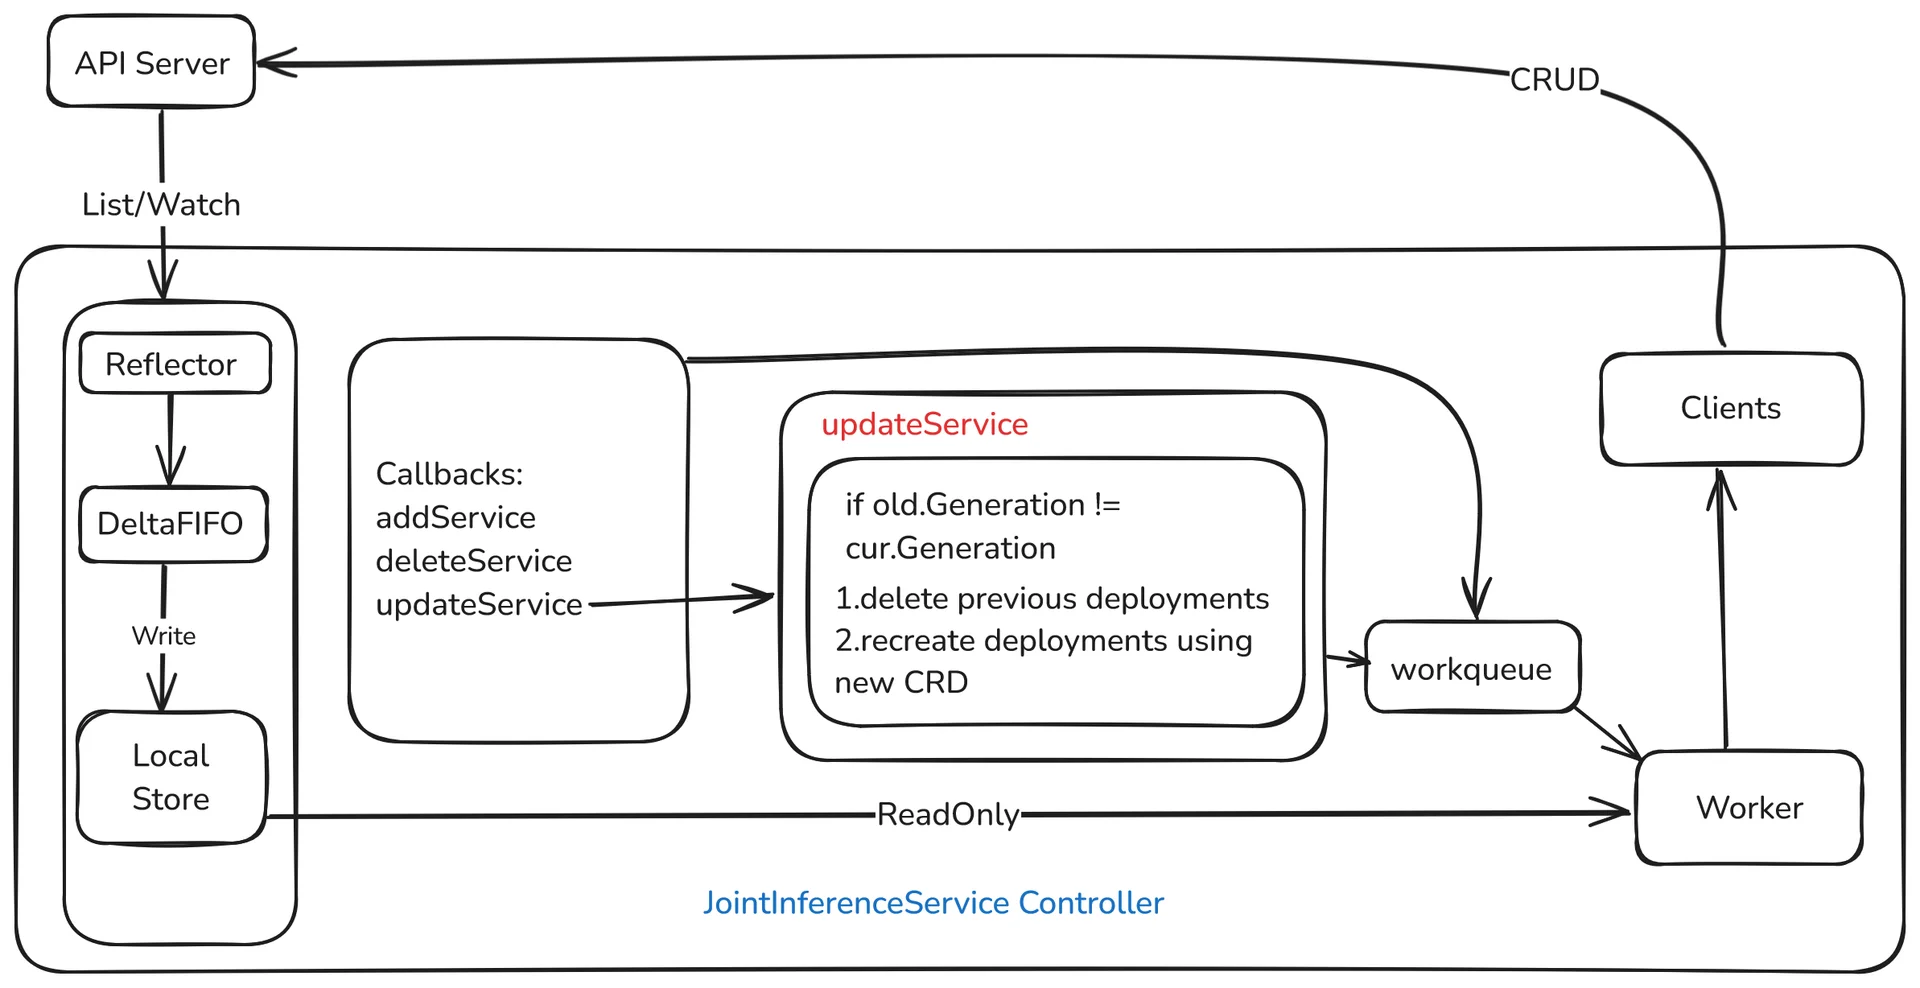
更新イベントを監視する。Informer が JointInferenceService の更新を聞いたとき、CRD に変更があれば元の pod を消し、新しいパラメータで pod を作る。
コード論理
連合推論の CRD 変更で pod を更新する論理は、連邦学習とほぼ同じ。
updateService を起動し、old.Generation と cur.Generation を比較。不等なら JointInferenceService のパラメータが変わった。
- Pod リストを走査し、各 Pod を削除。
- 更新後の
curService.SpecでcloudWorkerとedgeWorkerを再作成。
テスト
連邦学習ユニットテスト
e2e ではなくユニットテスト。変更後の二つの関数 deletePod() と updateJob() を重点的にテストする。
Test_deletePod()
fake.NewSimpleClientset()で模擬 k8s クライアント。fakeclientでテスト用 pod を作る。- コントローラを作り、
fakeclientを登録。 - テスト用 pod を
controller.deletePod()に渡し、fakeClient.CoreV1().Pods("default").Get(context.TODO(), "test-pod", metav1.GetOptions{})で再作成されたか見る。されていなければ失敗。
- 模擬クライアントを作る。
- コントローラを作る。
controller.deletePod()で存在しない pod を消す。- エラーが起きるか確認。
Test_updateJob()
- pod list 過程を mock。
- 模擬クライアントを作る。
- データセット、モデル、関連 job と pod リソースを作る。
- コントローラを初期化し、偽クライアント、テストジョブ、mock pod list、イベントブロードキャスタなど必要な依存を渡す。
- 新しい job を定義し、一部パラメータを更新(
TrainingWorkerのbatch_sizeを32から16へ)。 updateJobを呼び、旧 job を新 job に更新し、実環境のジョブ更新を模擬。- 更新結果を検証。更新後のパラメータが期待どおりならテスト通過。
連合推論ユニットテスト
Test_UpdateService()
- Sedna と Kubernetes の偽クライアントを作る。
- old service を作る。クラウド worker とエッジ worker の設定を含む。二種のモデルリソースを作る。
- old service に基づき deployment と pod を作る。
- コントローラを初期化し、偽クライアント、pod リスト、deployment リストを設定。
- コントローラの
sendToEdgeFuncは空関数(実際のエッジ通信はしない)。 - 旧連合推論サービスをコピーし、エッジ worker のハード例マイニングパラメータを
value1からvalue2に変え、Generationを増やす。 updateServiceを呼び、連合推論サービスの更新を起こす。- 偽クライアント経由で更新後の連合推論サービスが取れるかを検証。
- 更新後の HEM パラメータが
value1からvalue2になっているか確認し、サービス更新論理が正しく走ったことを保証する。