
KubeEdge-Sedna
Dépôt : https://github.com/kubeedge/sedna
PRs liées :
- initial proposal
- updated proposal
- JointInferenceService controller enhancement
- FederatedLearning controller enhancement
Je voulais attendre que la partie contrôleur soit vraiment au point avant de ranger ça, mais j’ai vu que les améliorations suivantes ne suivaient plus la même idée que le premier essai, donc je note par versions. v1, c’est surtout le contenu d’Open Source Promotion Plan. Ça différera de la proposal. En apprenant kubernetes, kubeedge et sedna, j’espère rentrer plus profond.
Besoins d’optimisation
- L’inférence conjointe et le federated learning n’arrivent pas à cascade-delete correctement. Sur
kubectl delete JointInferenceService/FederatedLearningJob **, les ressources enfants ne partent pas avec. - Sur
kubectl edit FederatedLearningJob/JointInferenceService **, mettre à jour la CR ne met pas à jour les pods enfants gérés. - Si on supprime un pod à la main ou par erreur, on veut qu’il soit recréé.
Cascade delete
Cascade delete dans kubernetes
Les Owner References donnent au control plane le lien entre objets. Via Owner Reference, kubernetes donne au control plane et aux autres clients API un moyen de nettoyer les ressources liées à la suppression. Dans la plupart des cas kubernetes gère Owner Reference tout seul. Le garbage collector fait le cascade delete.
La logique Kubernetes : tu supprimes une ressource, si d’autres ont dans Metadata un ownerReference vers elle, elles sont cascade-deleted. C’est configurable, défaut true.
Chaque ressource a dans metadata un champ ownerReferences, un tableau des owners. Quand un owner est supprimé, on l’ôte du tableau. Quand tous les owners sont partis, le GC récupère la ressource.
Savoir ça suffit à régler le problème. kubernetes gère le cascade delete ; un owner reference correct, et ça marche. Puisque ça ne marchait pas, l’owner reference n’était pas bien posé. Ensuite on cherche le code de création de job et de pod.
Relations owner reference pour l’inférence conjointe et le federated learning
JointInferenceService inférence conjointe
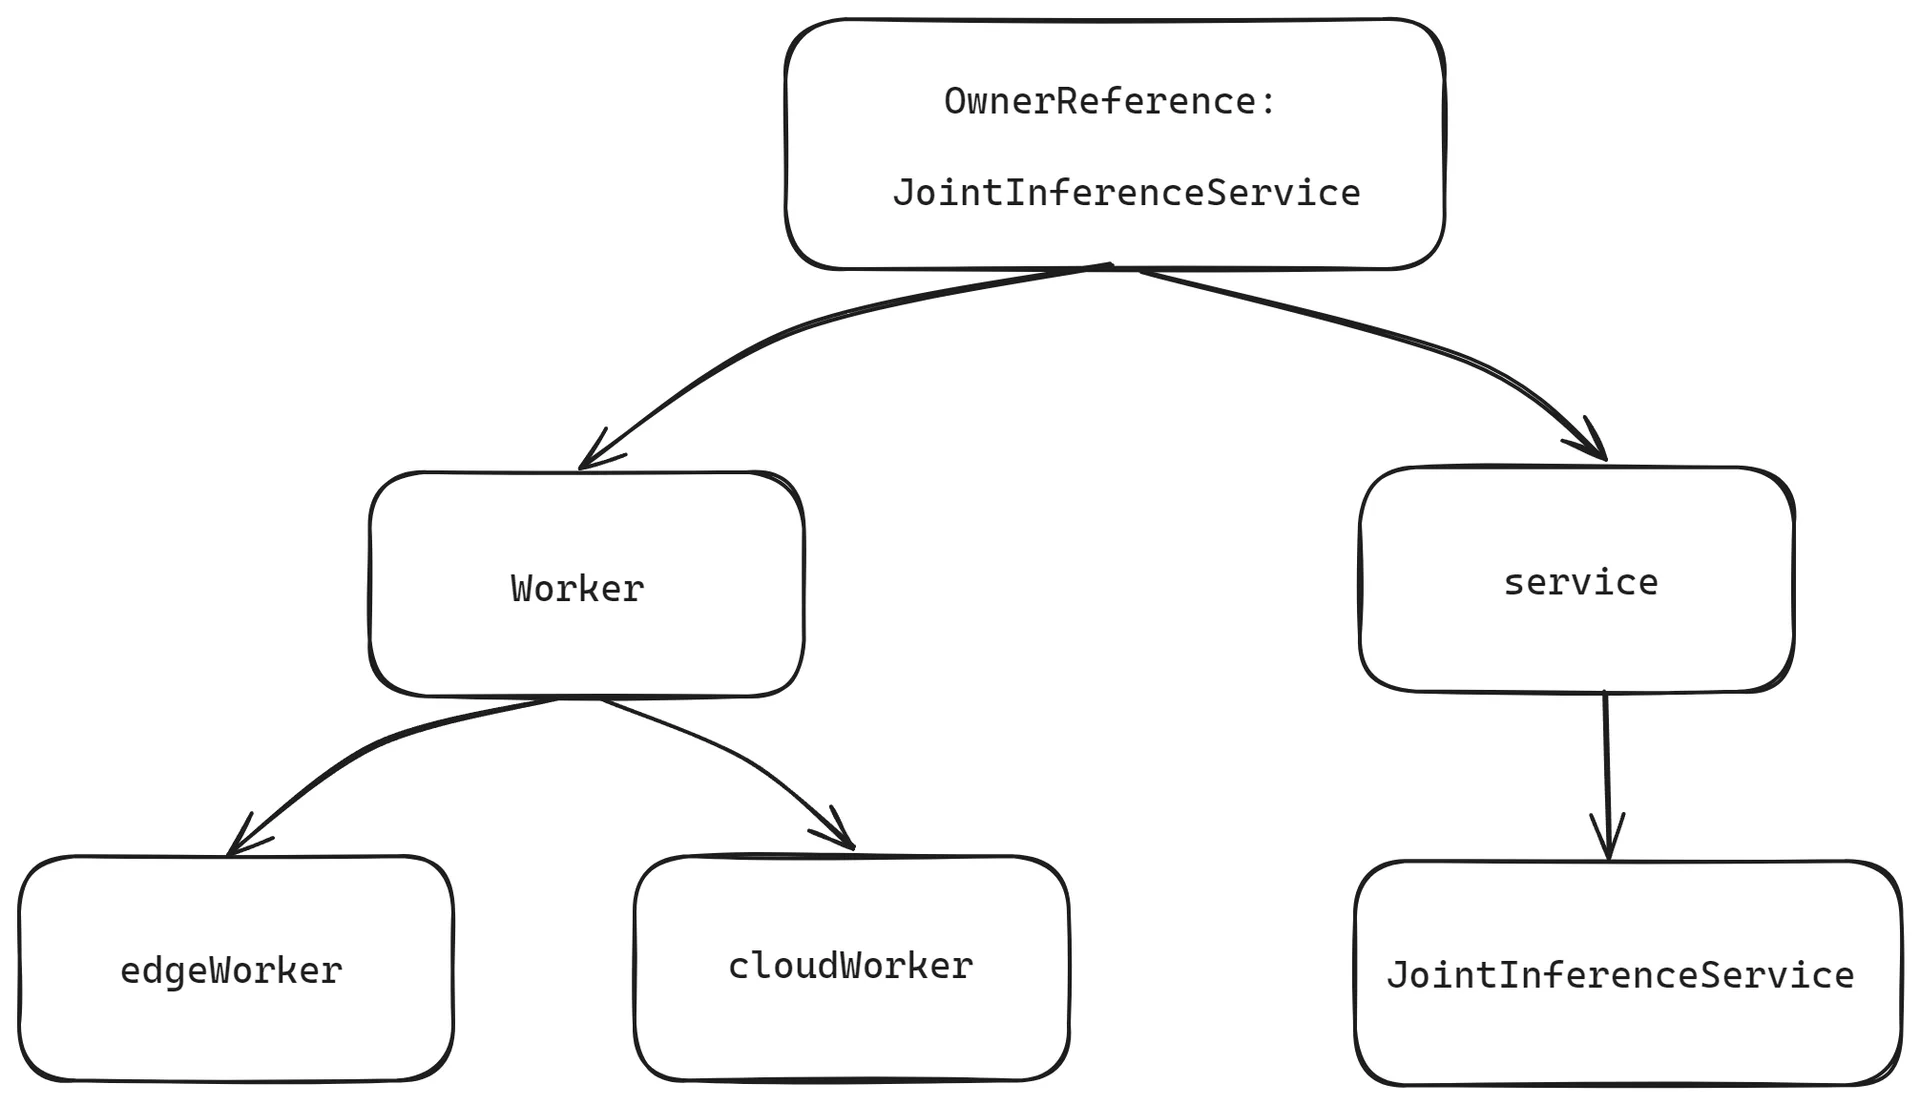
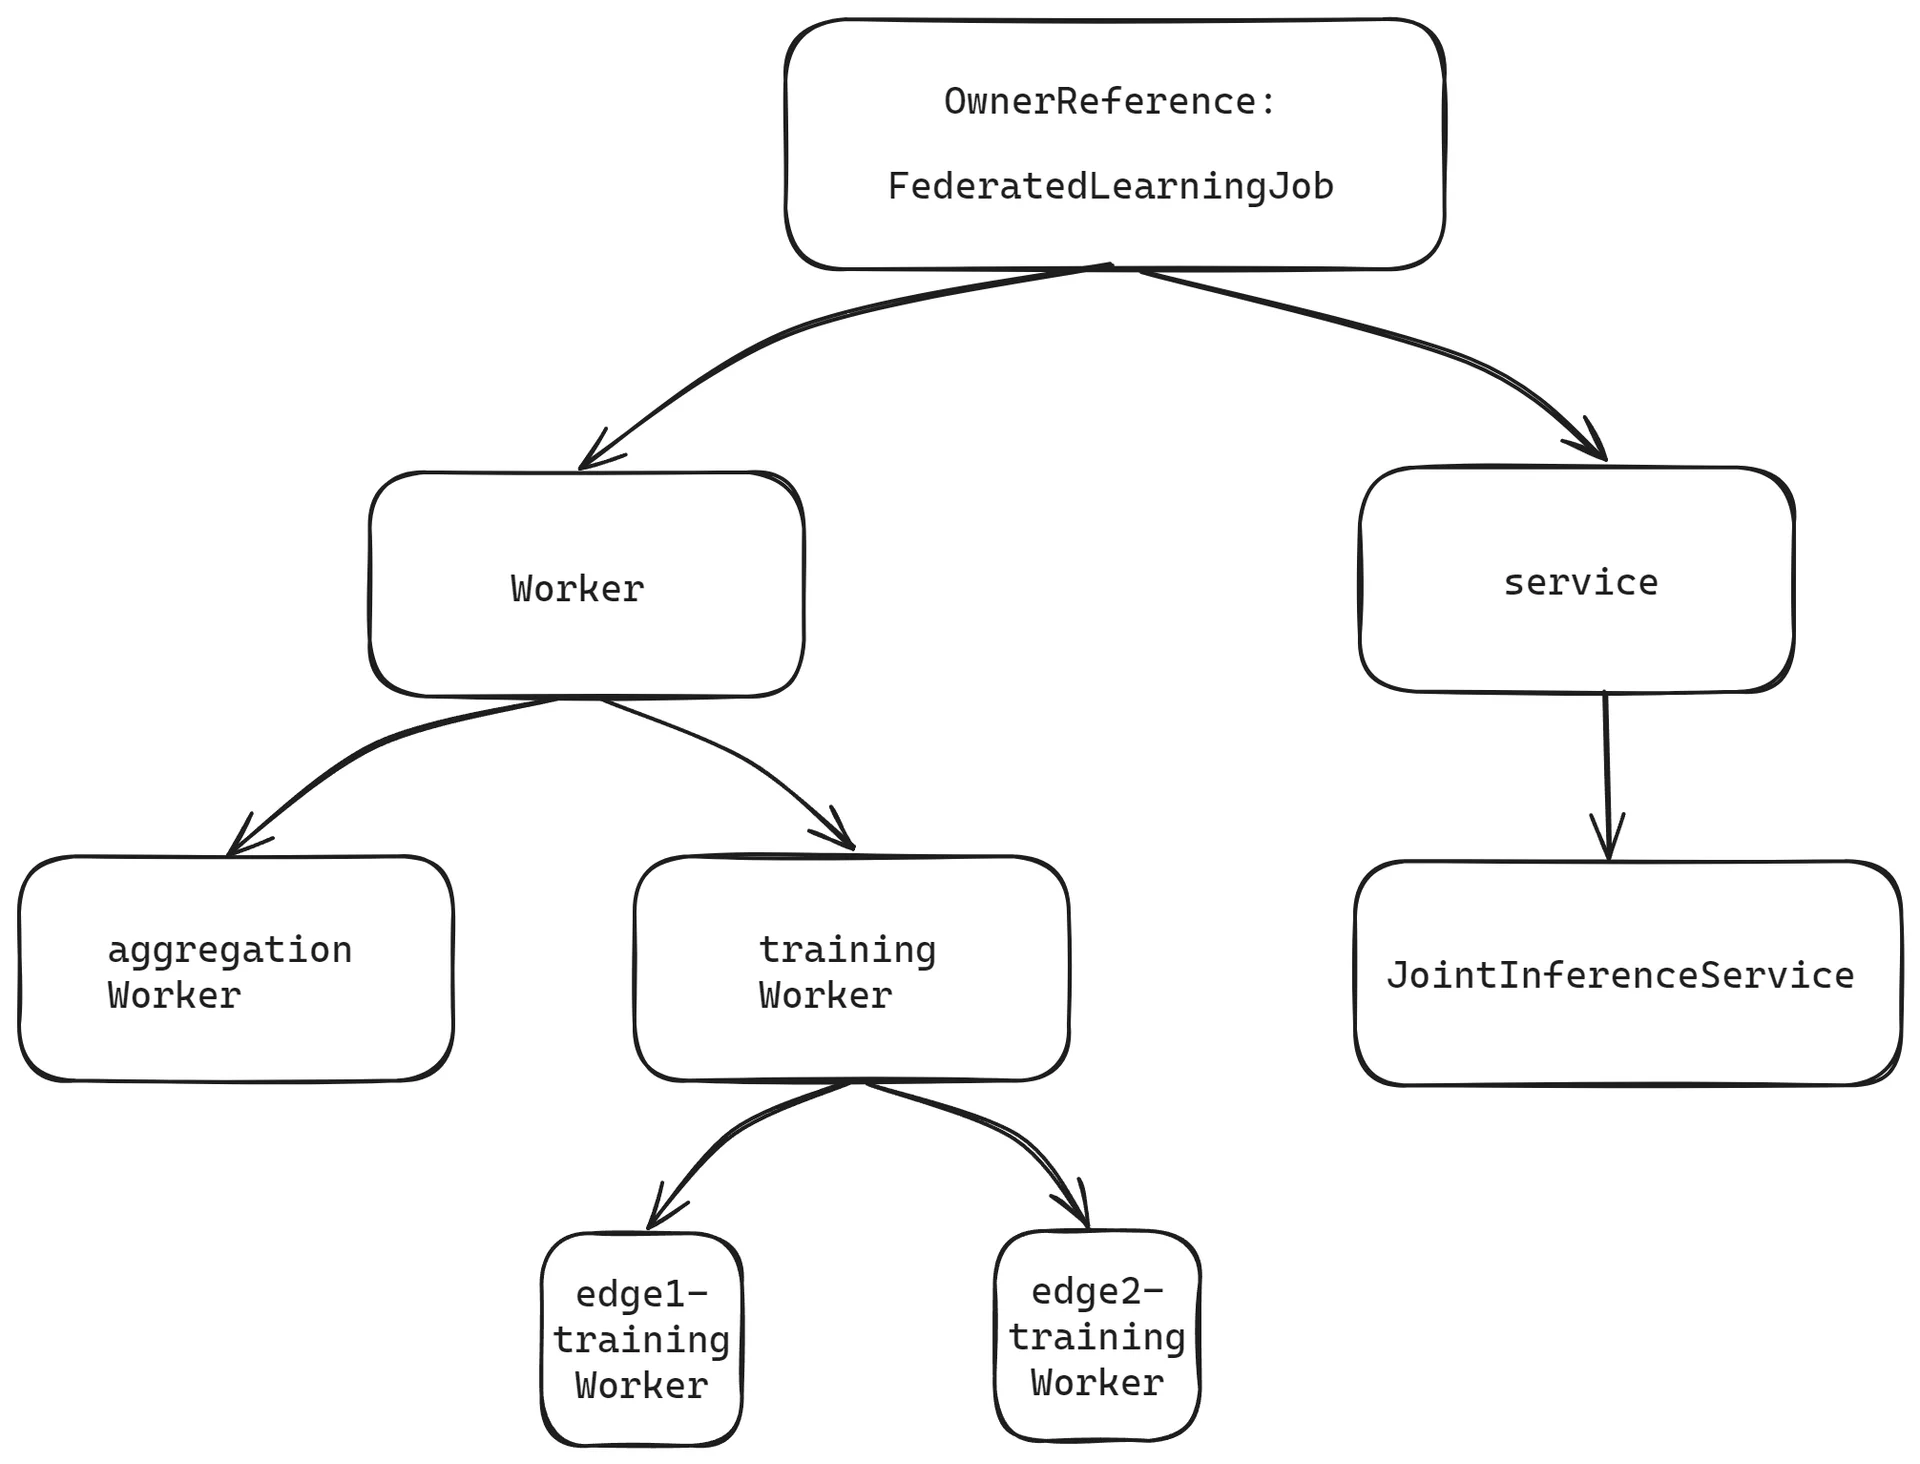
FederatedLearningJob federated learning
Comment le contrôleur d’inférence conjointe pose l’owner reference
Prenons le contrôleur d’inférence conjointe, et le chemin de Ownerreference.
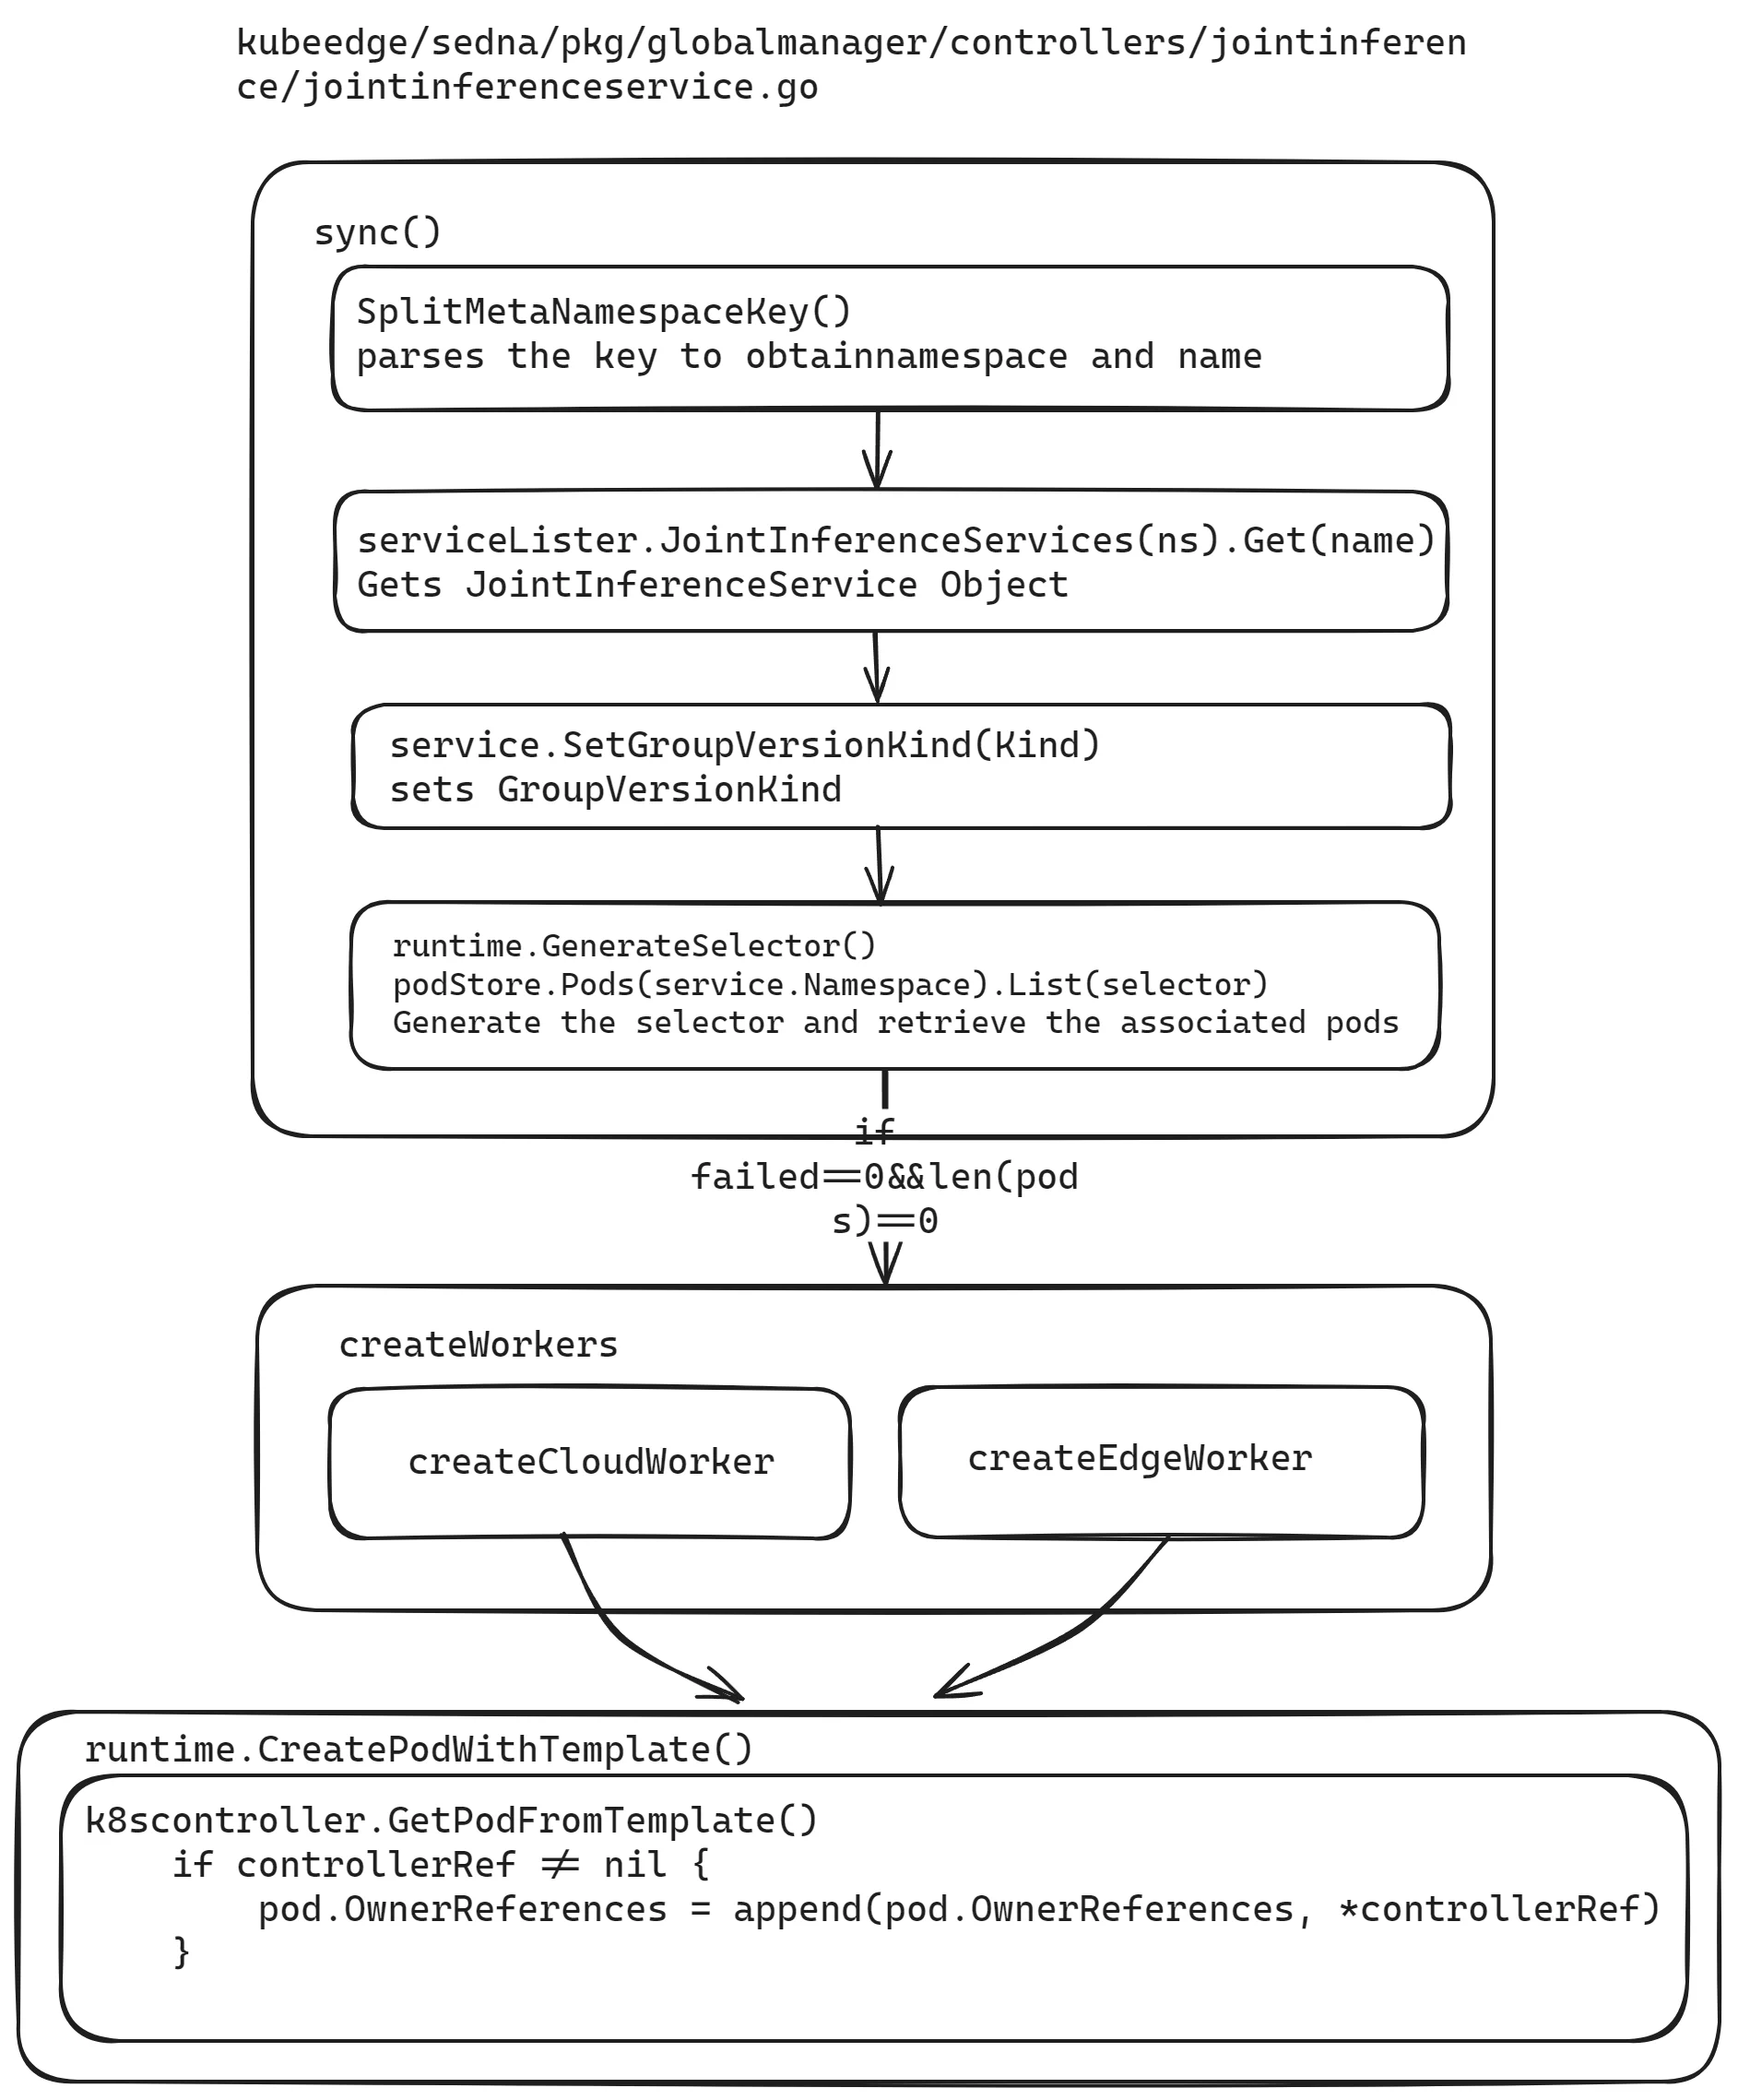
Tout le chemin de définition de l’owner reference est bon. Le problème, c’est la variable qu’on passe.
Dans pkg/globalmanager/controllers/jointinference/jointinferenceservice.go, on définit d’abord le controller name et le kind name de la CR. Ce qu’on passe à Ownerreference doit être le kind name, pas le nom du contrôleur.
// Name is this controller name
Name = "JointInference"

// KindName is the kind name of CR this controller controls
KindName = "JointInferenceService"
Le kind name de la CR est défini ici. À noter : l’ancien code passait Name (JointInference) ; il faut passer Kind Name (JointInferenceService).
// Kind contains the schema.GroupVersionKind for this controller type.
var Kind = sednav1.SchemeGroupVersion.WithKind(KindName)
run démarre le contrôleur. D’abord le nombre de workers, puis des threads de travail selon ce nombre, qui prennent sans cesse des tâches de la file.
for i := 0; i < workers; i++ { go wait.Until(c.worker, time.Second, stopCh) }Dans ce morceau de run, wait.Until lance une goroutine qui rappelle c.worker, une seconde d’écart, jusqu’à ce que stopCh se ferme.
// worker runs a worker thread that just dequeues items, processes them, and marks them done.
// It enforces that the sync is never invoked concurrently with the same key.
func (c *Controller) worker() {
    for c.processNextWorkItem() {
    }
}
worker appelle processNextWorkItem(), qui prend une tâche de la file, la traite, appelle sync pour la sync réelle, jusqu’à fermeture de la file.
ns, name, err := cache.SplitMetaNamespaceKey(key)
if err != nil {
    return false, err
}
if len(ns) == 0 || len(name) == 0 {
    return false, fmt.Errorf("invalid jointinference service key %q: either namespace or name is missing", key)
}
Dans sync, cache.SplitMetaNamespaceKey parse la key en namespace et name.
sharedService, err := c.serviceLister.JointInferenceServices(ns).Get(name)
if err != nil {
    if errors.IsNotFound(err) {
        klog.V(4).Infof("JointInferenceService has been deleted: %v", key)
        return true, nil
    }
    return false, err
}
service := *sharedService
On prend l’objet JointInferenceService depuis le lister.
service.SetGroupVersionKind(Kind)On pose GroupVersionKind.
selector, _ := runtime.GenerateSelector(&service)
pods, err := c.podStore.Pods(service.Namespace).List(selector)
if err != nil {
    return false, err
}
klog.V(4).Infof("list jointinference service %v/%v, %v pods: %v", service.Namespace, service.Name, len(pods), pods)
On génère un sélecteur et on liste les pods liés.
S’il n’y a pas de worker en échec, si le nombre de pods liés est 0, on appelle createWorkers pour créer le pod.
else {
        if len(pods) == 0 {
            active, manageServiceErr = c.createWorkers(&service)
        }
createWorkers appelle createCloudWorker et createEdgeWorker pour créer les pods cloud/edge.
Dans ces deux fonctions, runtime.CreatePodWithTemplate crée le pod, et k8scontroller.GetPodFromTemplate pose Ownerreference. Ce qui compte :
if controllerRef != nil {
    pod.OwnerReferences = append(pod.OwnerReferences, *controllerRef)
}
Recréation de Pod
La recréation auto d’un Pod en panne, c’est RestartPolicy.
Dans JointInferenceService, RestartPolicy n’est pas posé, donc défaut always. Pendant une tâche d’inférence conjointe, s’il y a un souci de programme — par ex. EdgeMesh mal configuré, l’edge n’atteint pas le port 5000 du cloud pour le plus gros modèle — le pod edge redémarre en boucle. Dans FederatedLearningJob, RestartPolicy est OnFailure.
Pour recréer un pod après suppression, il faut d’abord le mécanisme informer de kubernetes.
Le mécanisme informer de k8s
Kubernetes utilise Informer à la place du Controller pour parler à l’API Server. Toutes les ops du Controller passent par Informer, et Informer ne tape pas l’API Server à chaque fois. Informer fait ListAndWatch : au premier start, LIST pour tous les objets à jour, puis WATCH les changements, et garde les événements dans une file cache en lecture seule, pour les requêtes plus vite et moins de charge sur l’API Server.
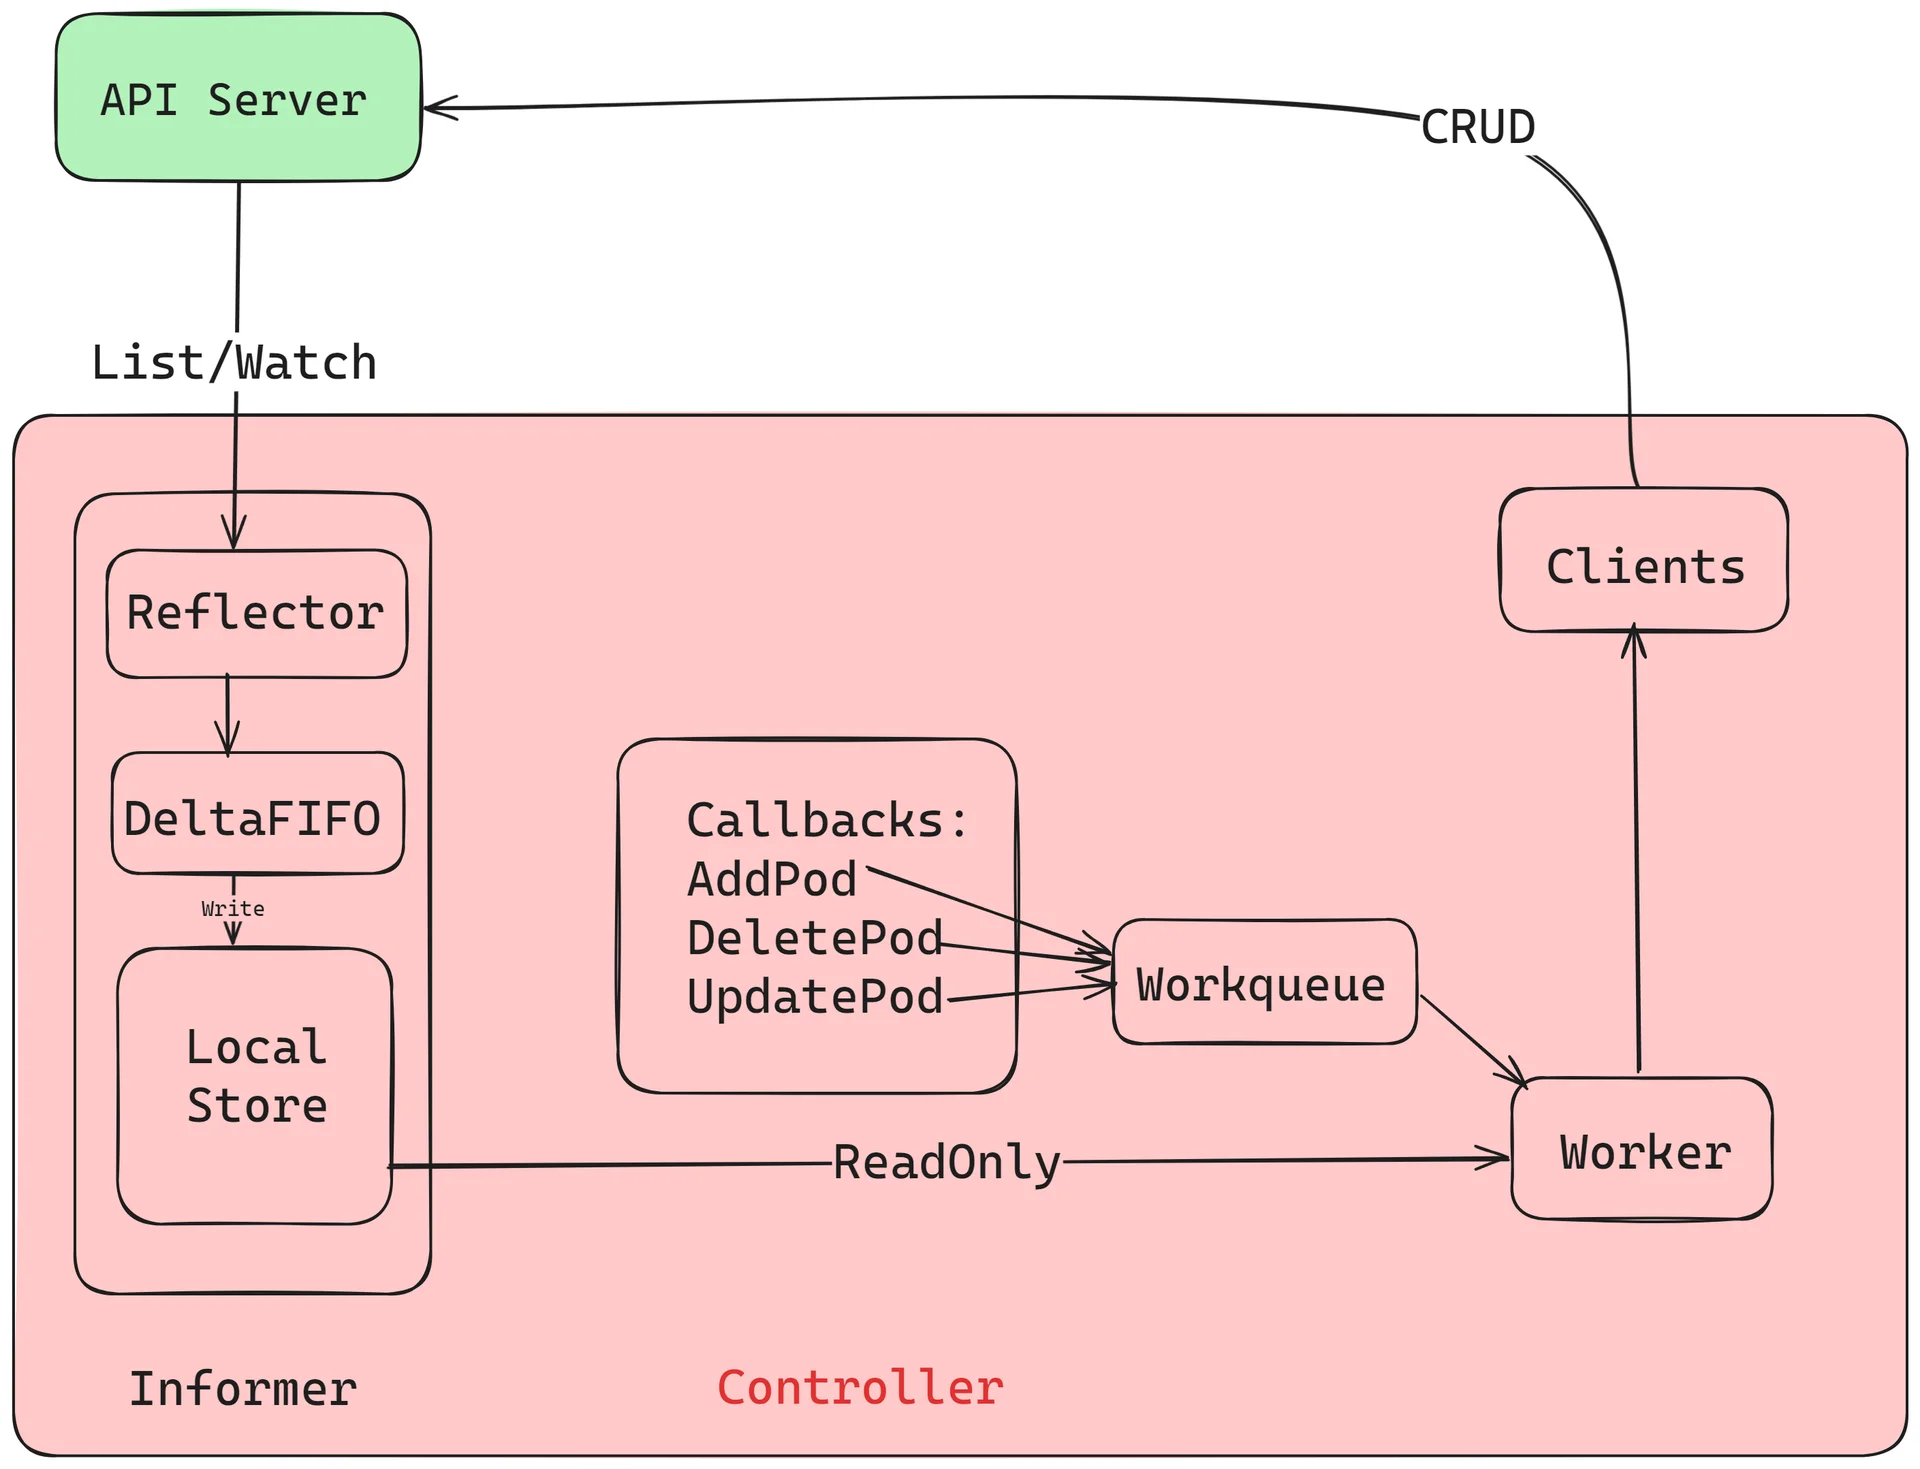
Rôle des pièces du schéma :
- Controller : porteur de l’Informer, peut créer un reflector et piloter processLoop. processLoop pop les données de DeltaFIFO, Indexer cache et indexe, puis dispatch au processor.
- Reflector : Informer ne va pas directement à k8s-api-server, un objet Reflector le fait. Reflector ListAndWatch la ressource kubernetes visée ; au changement, Added etc., l’objet va dans le cache local DeltaFIFO.
- DeltaFIFO : file FIFO des événements Watch — Added, Updated, Deleted.
- LocalStore : le cache de l’informer. Il cache les objets apiserver (certains encore dans DeltaFIFO). L’utilisateur interroge le cache, moins de pression sur apiserver. LocalStore n’est touché que par List/Get du Lister.
- WorkQueue : DeltaFIFO stocke l’événement, mute Store, puis pop vers WorkQueue. Le Controller voit l’événement WorkQueue et déclenche le callback du type.
Flux de l’informer
Informer list/watch apiserver. Le Reflector d’Informer établit la connexion. Reflector ListAndWatch : d’abord list toutes les instances, list donne le dernier resourceVersion, puis watch les changements après. Si ça casse en cours, reflector réécoute depuis ce resourceVersion. Création, suppression, update : Reflector reçoit une « notif d’événement ». L’événement + l’objet API = un Delta, dans DeltaFIFO.
- Informer lit les deltas de DeltaFIFO. Pour chacun, il regarde le type, puis crée ou met à jour le cache local (store).
- Si Added, Informer sauve l’objet API du delta dans le cache local via Indexer et indexe. Si delete, il l’ôte du cache local.
- DeltaFIFO pop l’événement au controller, qui appelle le ResourceEventHandler enregistré.
- Dans le ResourceEventHandler, on filtre un peu, puis on met l’Object qui nous intéresse dans la workqueue.
- Le Controller prend l’Object de la workqueue, lance un worker pour sa logique. En général : l’écart entre l’état du cluster et ce que l’utilisateur veut, puis dire à apiserver d’évoluer — créer des pods pour un deployment, scaler, etc.
- Dans le worker on peut lister la resource sans frapper apiserver tout le temps, parce que les changements apiserver se voient dans le cache local.
Trois ResourceEventHandler :
// ResourceEventHandlerFuncs is an adaptor to let you easily specify as many or
// as few of the notification functions as you want while still implementing
// ResourceEventHandler.
type ResourceEventHandlerFuncs struct {
    AddFunc    func(obj interface{})
    UpdateFunc func(oldObj, newObj interface{})
    DeleteFunc func(obj interface{})
}
La logique de ces trois est définie par l’utilisateur. Après enregistrement à l’init du controller, create/delete/update d’une instance de l’objet déclenche le handler correspondant.
Flux informer des contrôleurs d’inférence conjointe et de federated learning
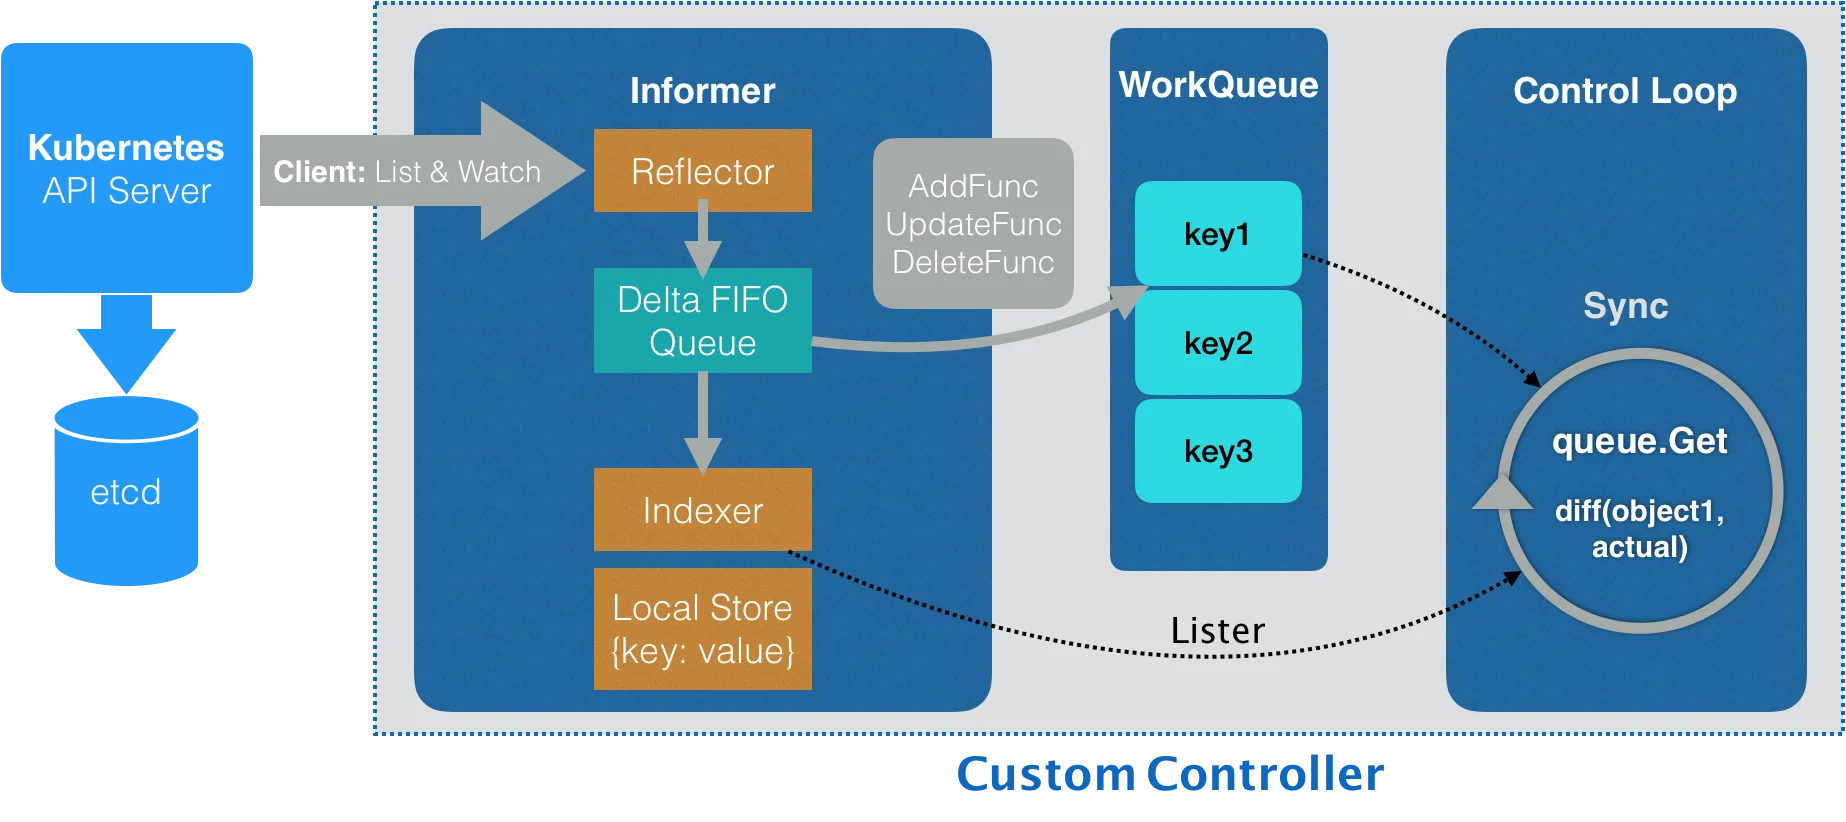
Exemple jointinferenceservice.go : New() crée un contrôleur JointInferenceService pour garder les pods liés en sync avec l’objet JointInferenceService. Dans New(), on init l’informer.
podInformer := cc.KubeInformerFactory.Core().V1().Pods()

serviceInformer := cc.SednaInformerFactory.Sedna().V1alpha1().JointInferenceServices()
Le service informer utilise un handler custom :
serviceInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
    AddFunc: func(obj interface{}) {
        jc.enqueueController(obj, true)
        jc.syncToEdge(watch.Added, obj)
    },
    UpdateFunc: func(old, cur interface{}) {
        jc.enqueueController(cur, true)
        jc.syncToEdge(watch.Added, cur)
    },

    DeleteFunc: func(obj interface{}) {
        jc.enqueueController(obj, true)
        jc.syncToEdge(watch.Deleted, obj)
    },
})
Le pod informer utilise un handler custom :
podInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
    AddFunc:    jc.addPod,
    UpdateFunc: jc.updatePod,
    DeleteFunc: jc.deletePod,
})
Ces EventHandler (addPod, updatePod, deletePod) ne font qu’enfiler l’objet lié ; pas d’autre traitement.
podInformer.Lister() crée un Lister() pour les Pods. podInformer.Informer().HasSynced vérifie si le cache Informer a sync.
jc.serviceLister = serviceInformer.Lister()
jc.serviceStoreSynced = serviceInformer.Informer().HasSynced
//...
jc.podStore = podInformer.Lister()
jc.podStoreSynced = podInformer.Informer().HasSynced
La sync depuis l’api server, pour le contrôleur jointinferenceservice, se fait dans Run(). Run() ouvre la main goroutine watch et sync.
if !cache.WaitForNamedCacheSync(Name, stopCh, c.podStoreSynced, c.serviceStoreSynced) {
    klog.Errorf("failed to wait for %s caches to sync", Name)
    return

}
Après start de l’Informer, on attend le cache local sync, puis on lance les workers. Sur un événement de changement, on prend l’Object, on fait une object key (namespace/name), on met la key dans la workerqueue.
worker() appelle c.processNextWorkItem().
func (c *Controller) worker() {
    for c.processNextWorkItem() {
    }
}
processNextWorkItem prend la key dans la workerqueue, appelle sync(). Dans sync(), le lister prend le vrai objet depuis le cache local, et on exécute la sync.
Design de recréation de pod federated learning
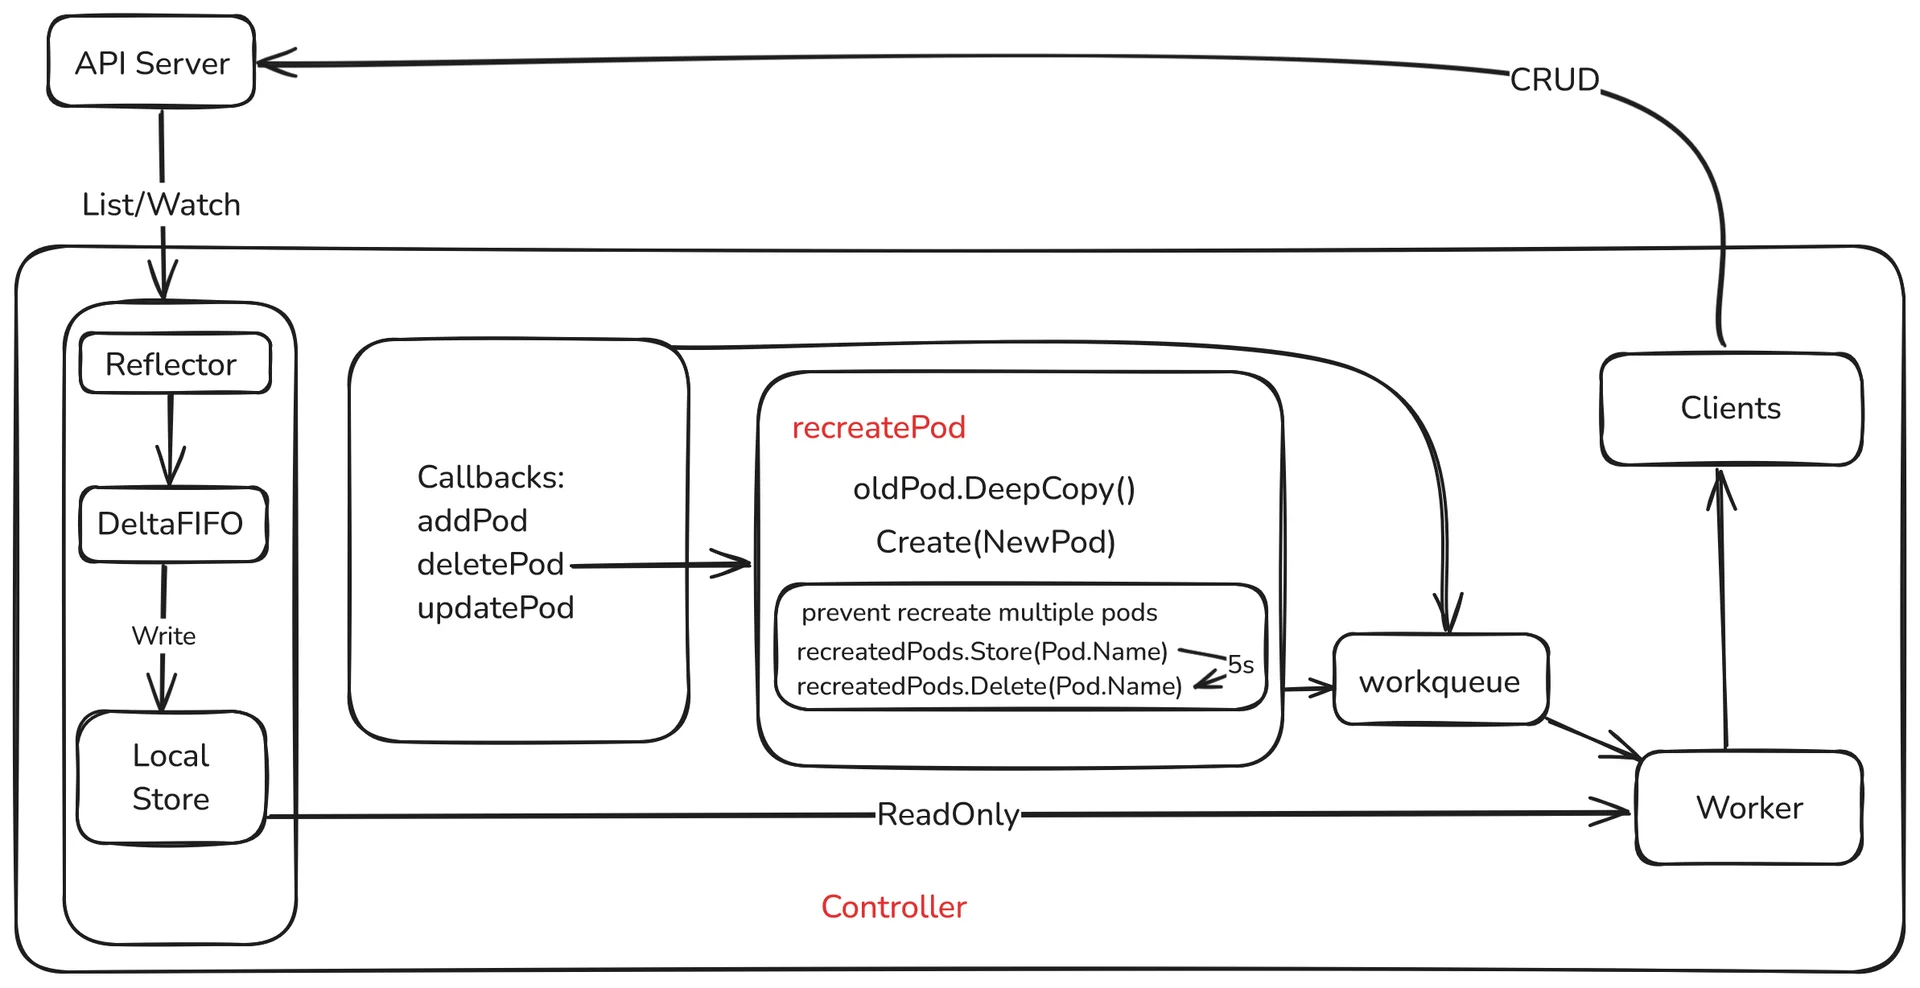
Écouter les deletes. Quand l’Informer voit un delete dont OwnerReference est FederatedLearning, lancer DeletePod, qui recrée le pod. Le Pod recréé est presque identique, config et spec gardées, resourceVersion et UID reset pour régénération.
Logique code
- Checks avant recréation
- Le pod est-il possédé par un
FederatedLearningJob. - A-t-il déjà été recréé :
c.recreatedPods.Load(pod.Name). Si oui, on ne recrée pas.
- Le pod est-il possédé par un
// first check if the pod is owned by a FederatedLearningJob
controllerRef := metav1.GetControllerOf(pod)
if controllerRef == nil || controllerRef.Kind != Kind.Kind {
    return
}- Recréer le Pod
pod.DeepCopy()pour une copie profonde.- Reset des ids uniques (
ResourceVersion,UID) et des champs status. c.kubeClient.CoreV1().Pods(pod.Namespace).Createpour créer le nouveau Pod via l’API Kubernetes.- Succès : log, marquer le Pod recréé.
// Create a deep copy of the old pod
newPod := pod.DeepCopy()
// Reset the resource version and UID as they are unique to each object
newPod.ResourceVersion = ""
newPod.UID = ""
// Clear the status
newPod.Status = v1.PodStatus{}
// Remove the deletion timestamp
newPod.DeletionTimestamp = nil
// Remove the deletion grace period seconds
newPod.DeletionGracePeriodSeconds = nil
_, err := c.kubeClient.CoreV1().Pods(pod.Namespace).Create(context.TODO(), newPod, metav1.CreateOptions{})
if err != nil {
    return
}- Marquer recréé et timer pour effacer :
c.recreatedPods.Store(pod.Name, true)marque recréé.- Un timer, 5 s plus tard, enlève la marque (
c.recreatedPods.Delete(pod.Name)), pour qu’une nouvelle suppression puisse retrigger.
// mark the pod as recreated
c.recreatedPods.Store(newPod.Name, true)
// set a timer to delete the record from the map after a while
go func() {
    time.Sleep(5 * time.Second)
    c.recreatedPods.Delete(pod.Name)
}()
On ajoute un sync.Map recreatedPods sur le Controller, pour éviter de recréer deux fois le même pod dans un delete. Après delete manuel et création OK, le nom entre dans recreatedPods. Si deletePod est rappelé pour le même événement, le nom y est déjà, donc pas de double delete / double create. Timer 5s pour effacer la marque, et un delete manuel plus tard peut retrigger.
type Controller struct{
//...
preventRecreation bool
//...
}
Design de recréation de pod inférence conjointe
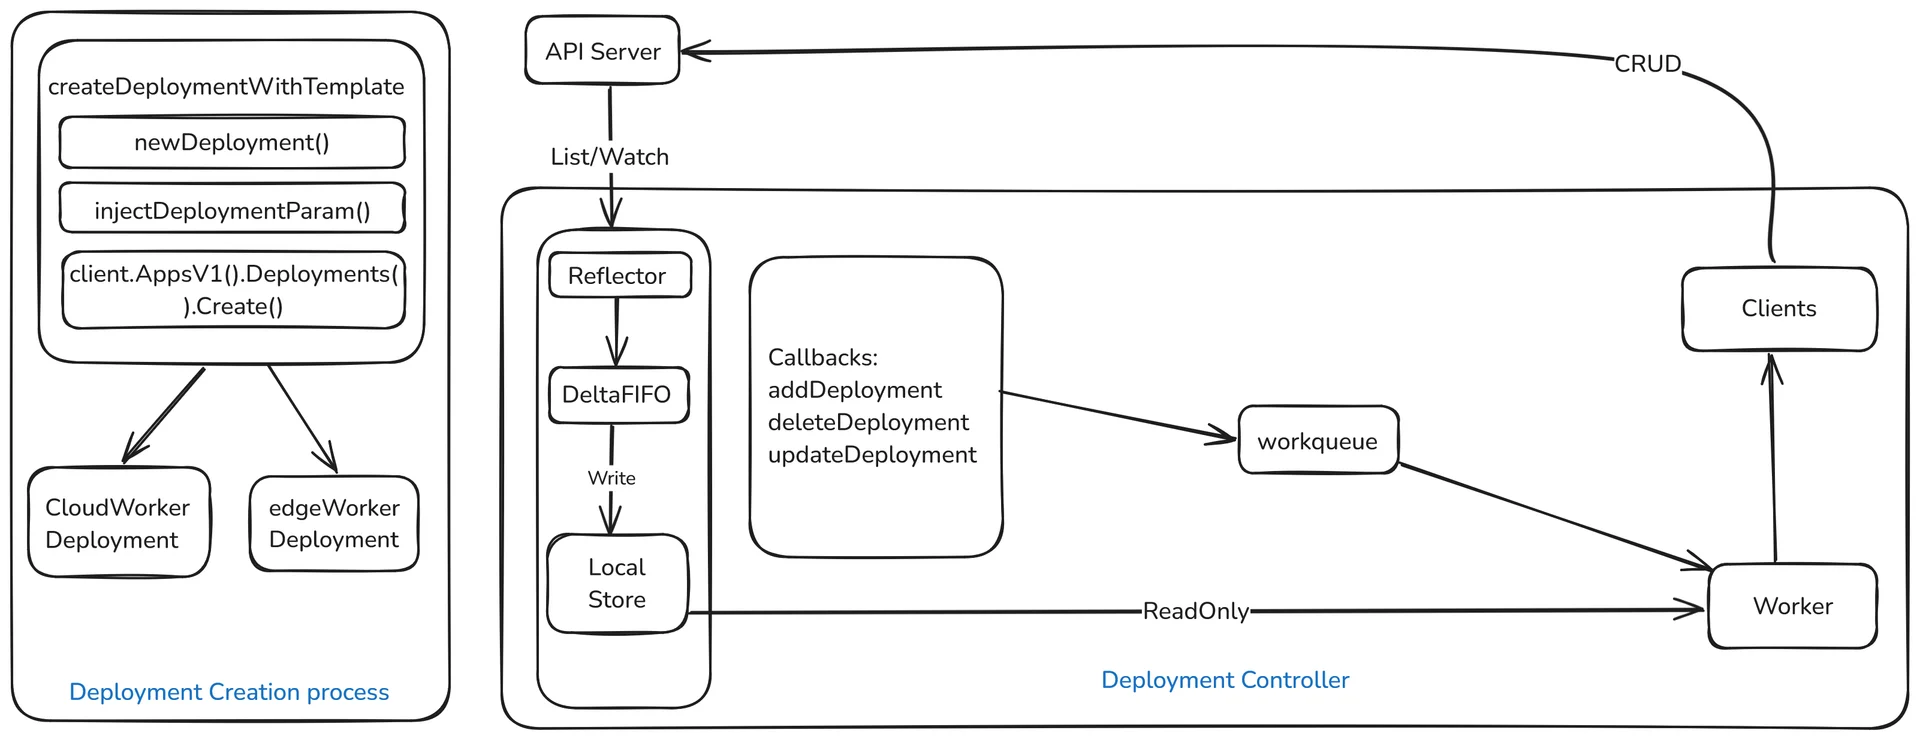
La tâche d’inférence est un workload stateless, donc on peut s’appuyer sur le deployment natif k8s pour l’auto-guérison du pod. Il faut un chemin complet de watch et de traitement des changements de ressources.
- Prendre un
deployment informerdans la factory. - Enregistrer les handlers (
addDeployment,updateDeployment,deleteDeployment). - Démarrer l’informer et syncer avec l’api k8s.
- Avant de traiter les événements, attendre que le cache local soit sync avec l’API Server.
- Quand un
Deploymentdu cluster change, l’Informerdéclenche le handler.
MAJ des pods quand on change la CRD federated learning
Flux du contrôleur federated learning qui met à jour les pods sur changement de CRD :
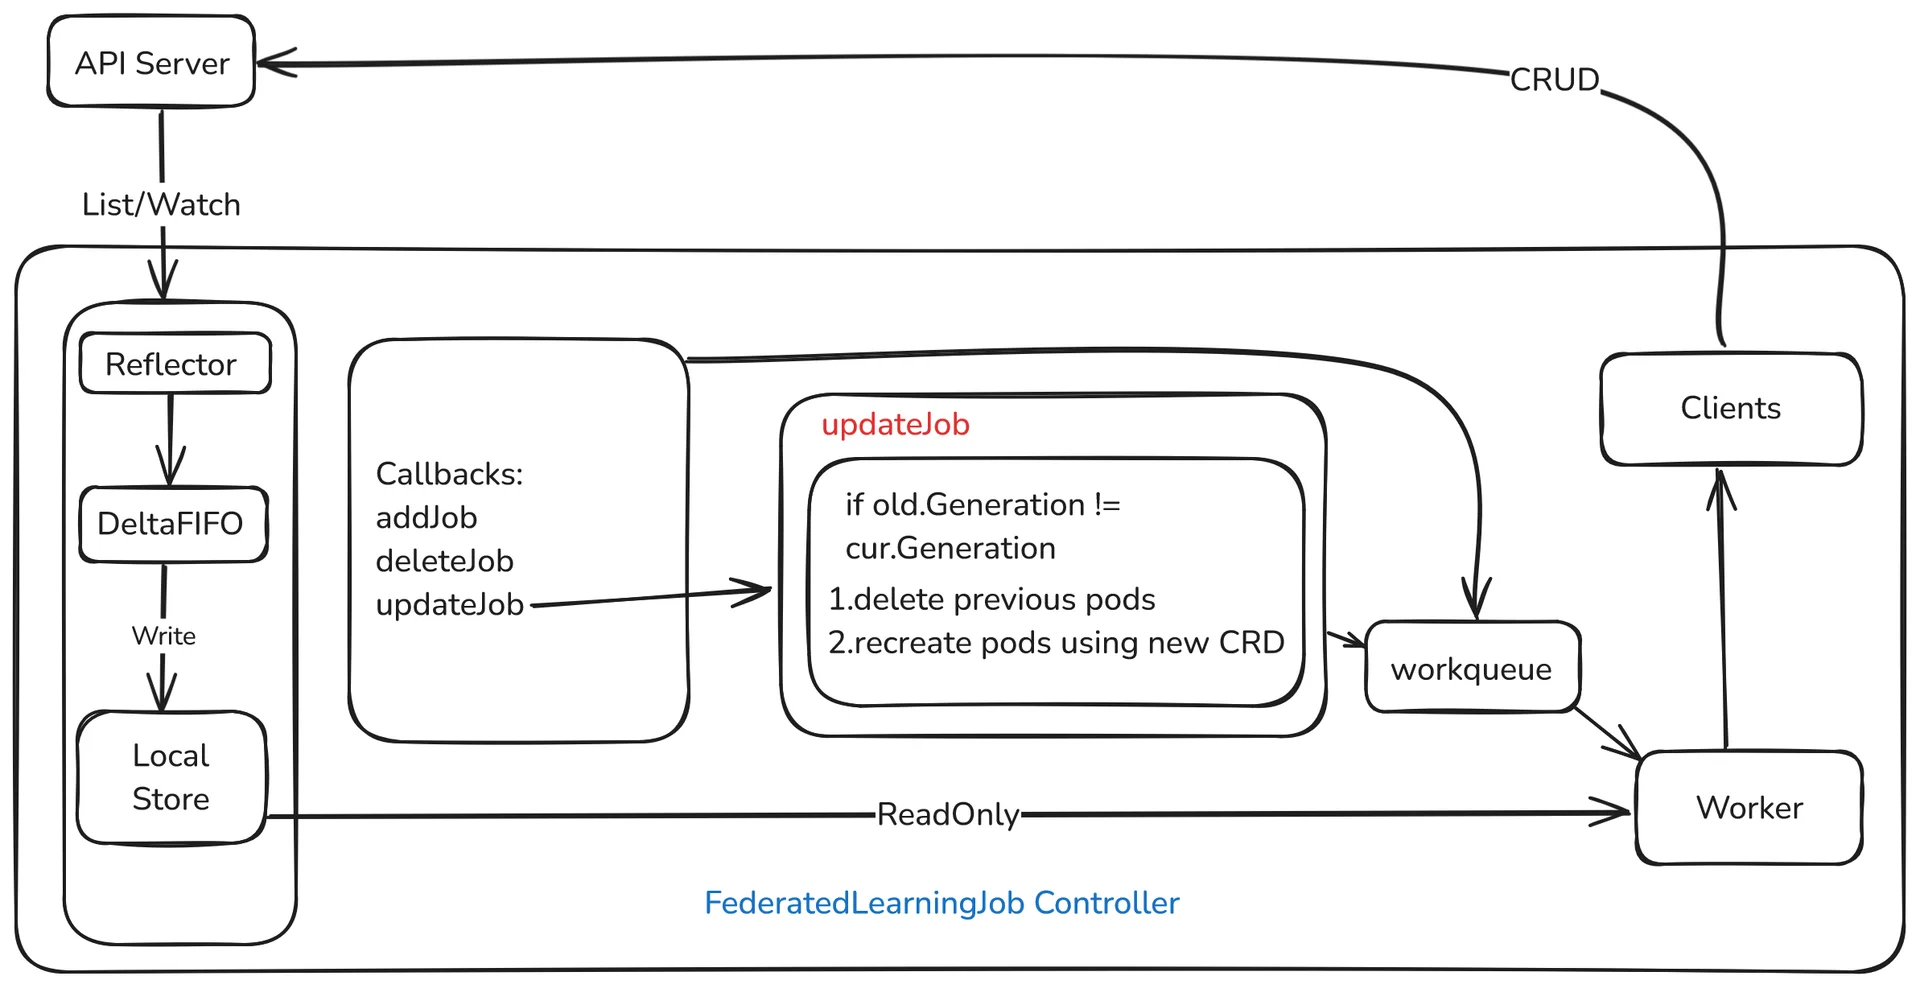
Écouter les updates. Quand l’Informer voit un update FederatedLearningJob, si la CRD a changé, supprimer les anciens pods et les recréer avec les nouveaux params.
Logique code
Lancer updateJob. updateJob décide d’abord s’il faut updater.
- Si
oldetcurne convertissent pas ensednav1.FederatedLearningJob, return. - Si
oldJobetcurJobont le mêmeResourceVersion, rien n’a changé, return. preventRecreationà true, pour ne pas recréer de Pod pendant l’update.
Puis comparer les params oldJob / curJob.
- Comparer
old.Generationetcur.Generation. Les CRD ont un champ Generation. Auto : chaque create/modif de l’objet crd le change. Create = 1, chaque modif +1. Seul un changement de spec bump Generation ; status non. Donc on distingue spec vs status. Si inégaux, les paramsFederatedLearningJobont changé. - Parcourir la liste de Pods, supprimer chaque Pod.
- Recréer
AggWorkeretTrainWorkerdepuiscurJob.Specà jour. - Remettre
preventRecreationàfalsepour ne pas bloquer l’auto-heal plus tard.
MAJ des pods quand on change la CRD inférence conjointe
Flux du contrôleur d’inférence conjointe qui met à jour les pods sur changement de CRD :
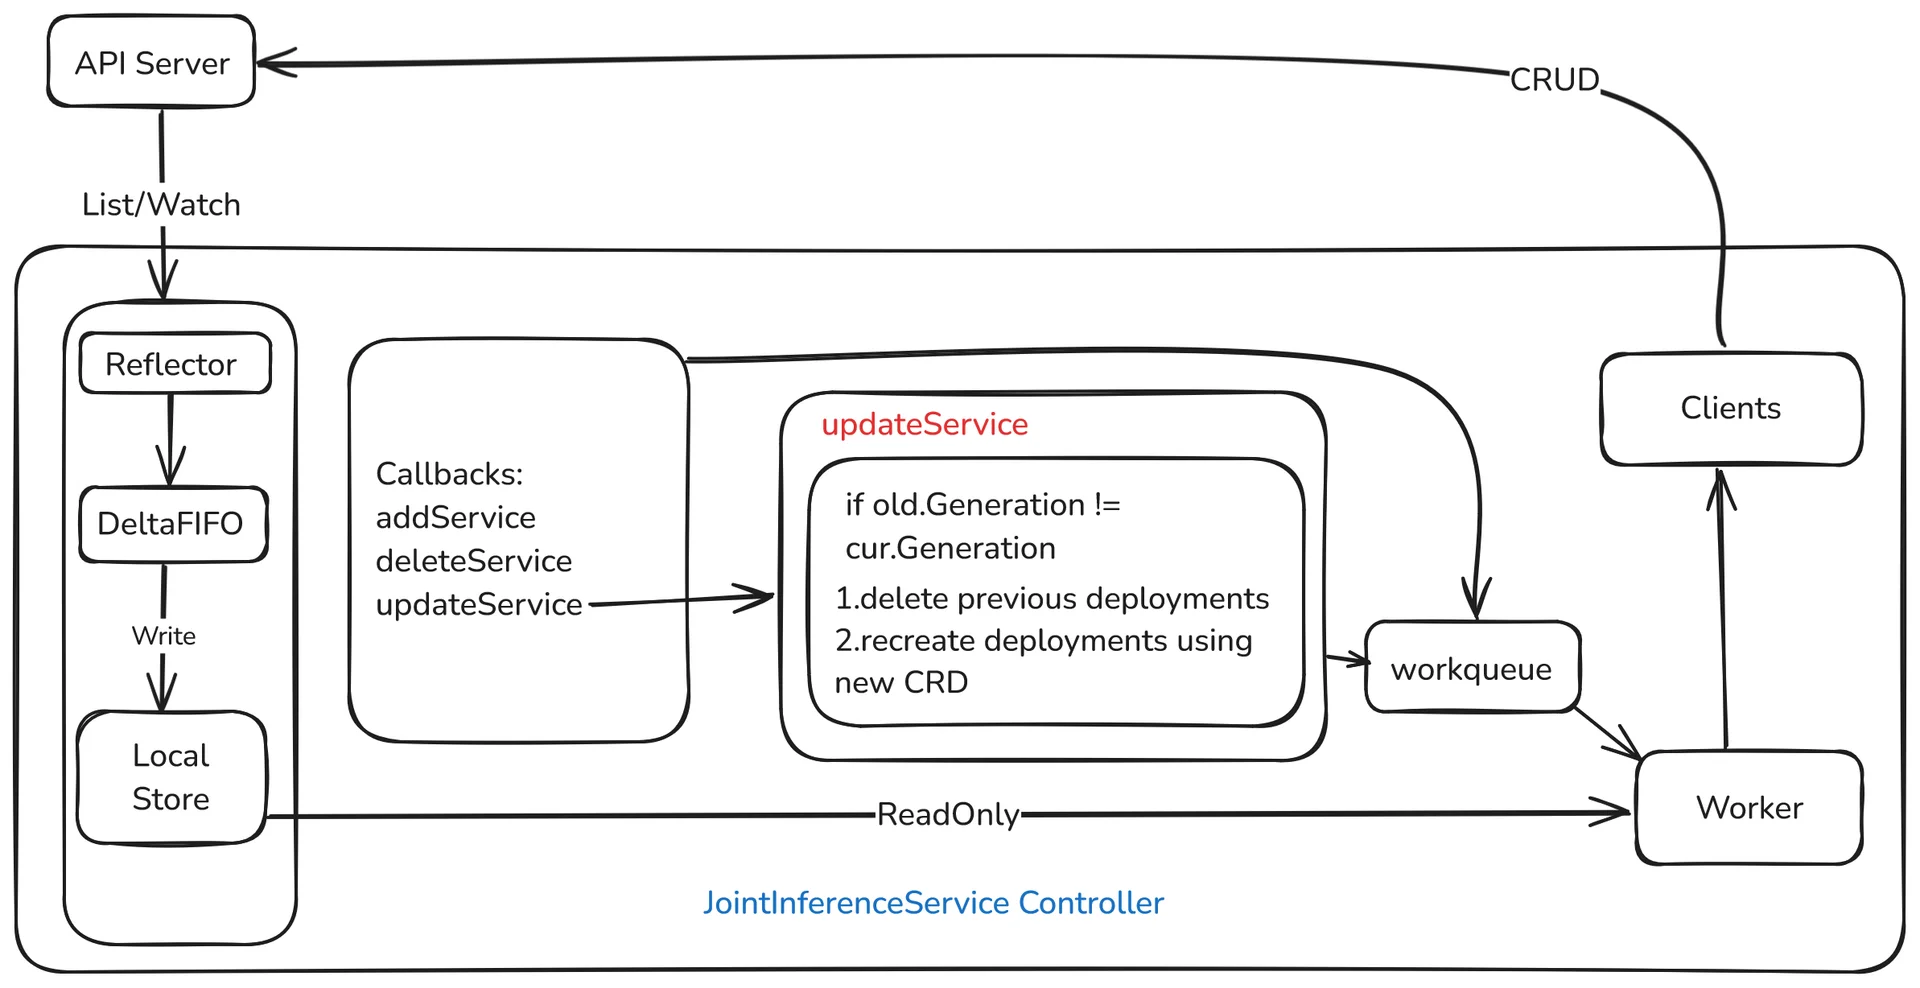
Écouter les updates. Quand l’Informer voit un update JointInferenceService, si la CRD a changé, supprimer les anciens pods et recréer avec les nouveaux params.
Logique code
Sur la MAJ de pods après changement de CRD, l’inférence conjointe est essentiellement la même que le federated learning.
Lancer updateService, comparer old.Generation et cur.Generation. Si inégaux, les params JointInferenceService ont changé.
- Parcourir la liste de Pods, supprimer chaque Pod.
- Recréer
cloudWorkeretedgeWorkerdepuiscurService.Specà jour.
Tests
Tests unitaires federated learning
Unitaires, pas e2e. Focus sur les deux fonctions changées, deletePod() et updateJob().
Test_deletePod()
fake.NewSimpleClientset()pour un client k8s fake.- Créer un pod de test via
fakeclient. - Créer un contrôleur, y enregistrer
fakeclient. - Passer le pod de test à
controller.deletePod(), puisfakeClient.CoreV1().Pods("default").Get(context.TODO(), "test-pod", metav1.GetOptions{})pour voir s’il a été recréé. Sinon, fail.
- Créer un client fake.
- Créer un contrôleur.
- Appeler
controller.deletePod()sur un pod absent. - Vérifier s’il y a une erreur.
Test_updateJob()
- Mock du list de pods.
- Créer un client fake.
- Créer dataset, modèle, job et pods liés.
- Init le contrôleur avec fake client, job de test, mock pod list, event broadcaster et deps.
- Définir un nouveau job, updater une partie des params (
batch_sizedeTrainingWorkerde32à16). - Appeler
updateJobpour passer de l’ancien job au nouveau, simuler une update réelle. - Vérifier le résultat : params à jour conformes, test OK.
Tests unitaires inférence conjointe
Test_UpdateService()
- Créer des clients fake Sedna et Kubernetes.
- Créer un old service, avec config cloud worker et edge worker. Créer deux ressources modèle.
- À partir de l’old service, créer deployment et pods.
- Init le contrôleur, fake clients, liste de pods, liste de deployments.
sendToEdgeFuncdu contrôleur = fonction vide (pas de comm edge réelle).- Copier l’ancien service d’inférence conjointe, changer le param hard-example-mining de l’edge worker de
value1àvalue2, bumpGeneration. - Appeler
updateServicepour déclencher l’update. - Le test vérifie qu’on récupère le service mis à jour via le fake client.
- Vérifier que le param HEM est passé de
value1àvalue2, donc que la logique d’update a bien tourné.