
Jeffrey Dean@Google and Sanjay Ghemawat@Google
需求
Google的業務量決定了需要計算的資料通常很大,必須把它們分布到成百上千的機器上計算,才能在合理的時間內完成。如何並行計算,分布資料,處理差錯成為問題。
為了解決這些問題,作者抽象出了一種簡單的計算,同時隱藏了並行的細節,容錯機制,資料分配和負載均衡。
作者設計的語言模型受到了Lisp中map和reduce原語的啟發。
程式設計模型
一組鍵值對作為計算的輸入,產生出一組鍵值對作為輸出。
MapReduce函式庫透過Map函式和Reduce函式來表達。
Map函式
Map函式,由使用者來編寫,以鍵值對作為輸入,產生一組鍵值對中間量。MapReduce函式庫聚集所有由同一個鍵產生的中間值,並把它們傳給Reduce函式
Reduce函式
Reduce函式,同樣由使用者編寫,接受一個中間鍵和一組那個鍵的值。它把這些值聚合成可能會更小的一組值。典型地,每次Reduce函式呼叫輸出0或1作為輸出值。中間值透過迭代器(iterator)提供給reduce函式。這允許我們處理一系列太大而不能放入記憶體中的值。
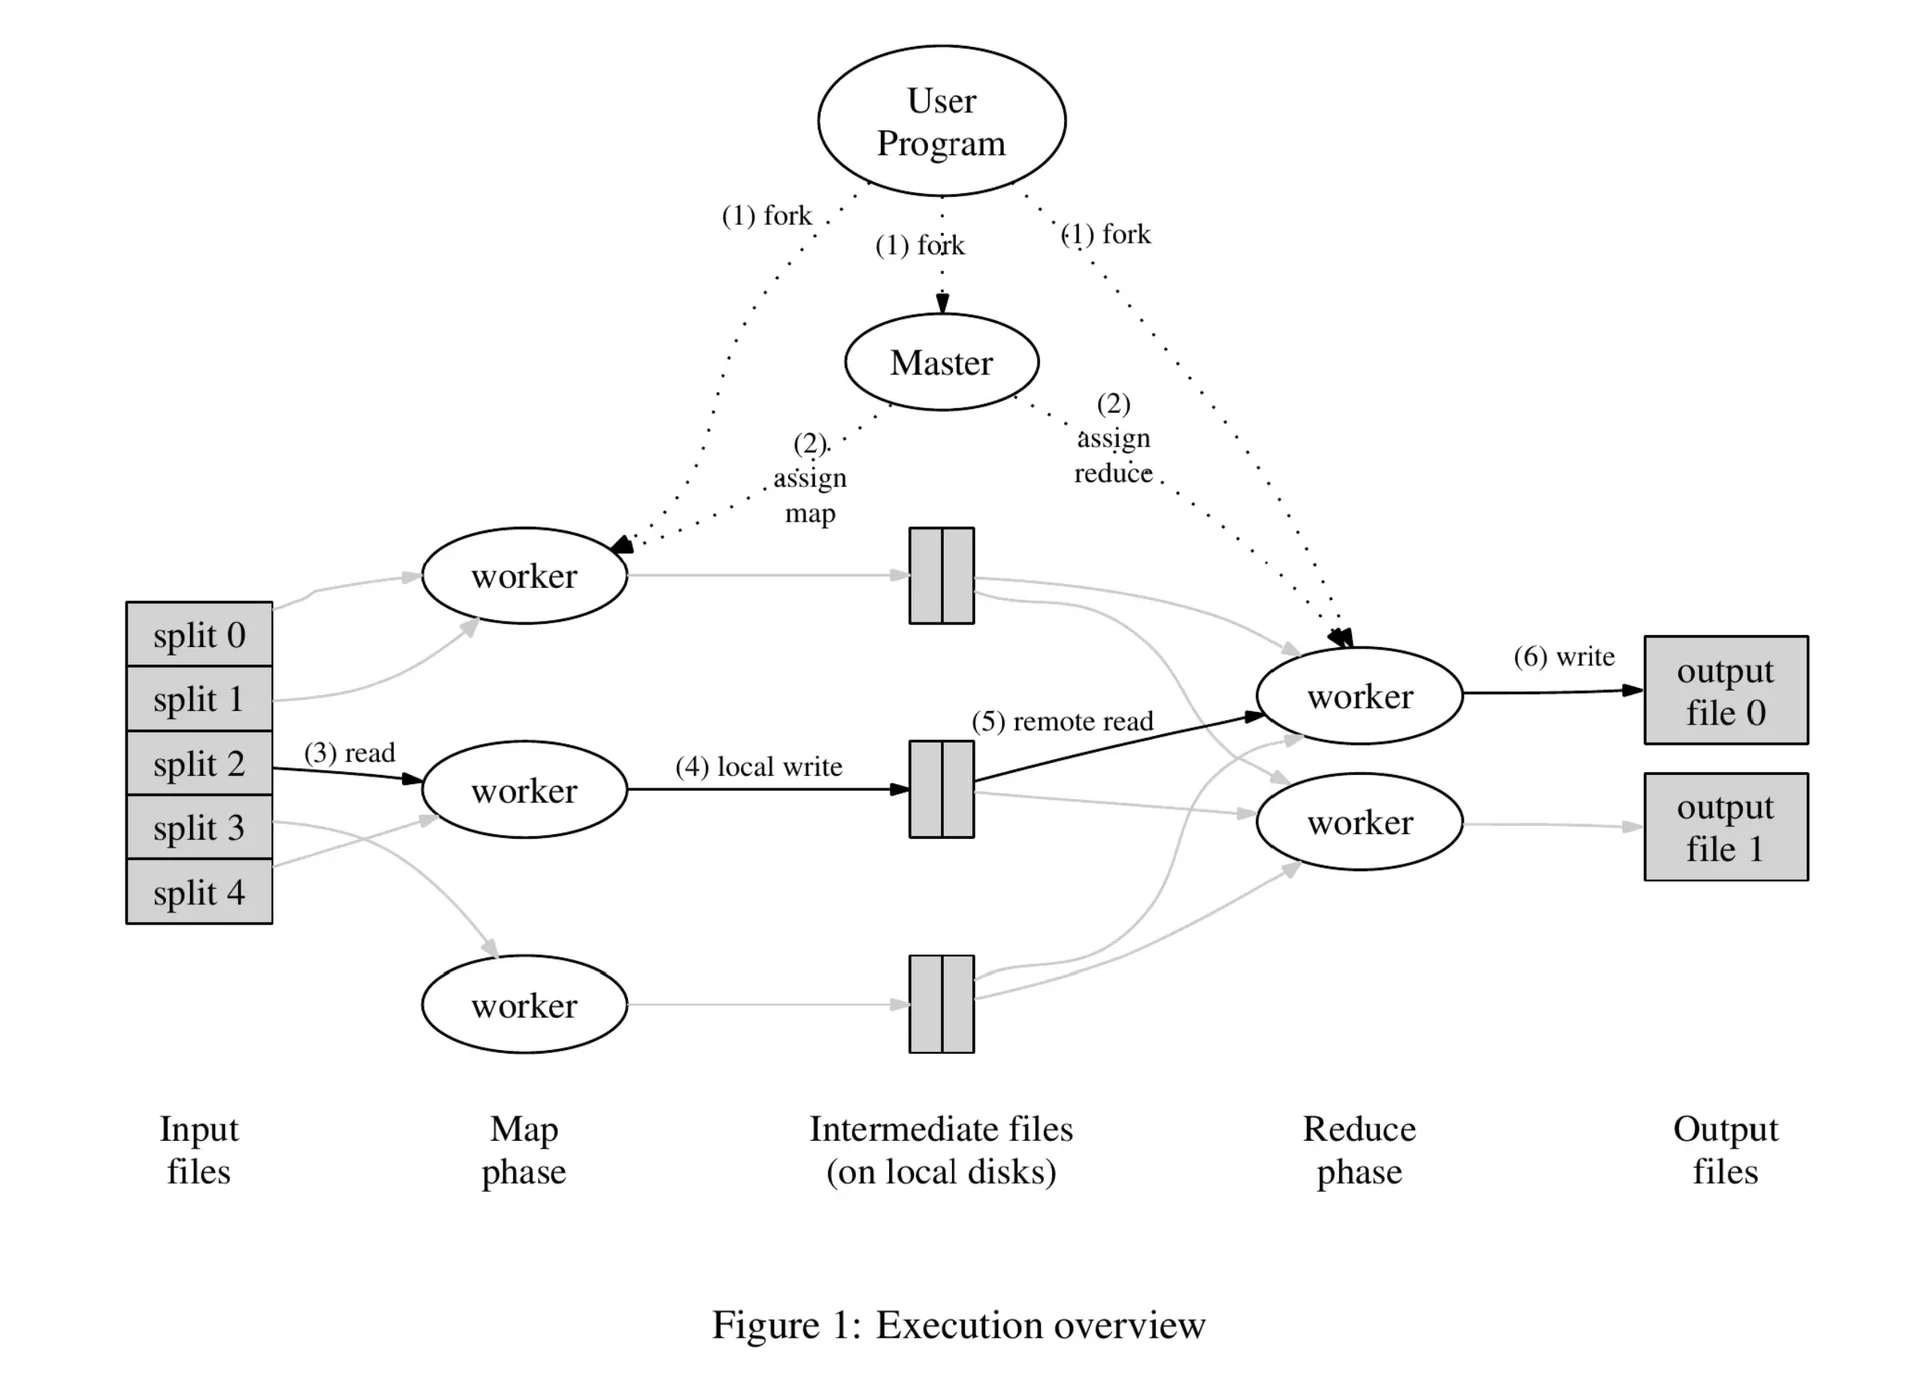
具體實作
Map函式呼叫被分配在很多不同的機器上,自動將輸入資料分割為M塊分割,輸入的分割可以被不同機器並行處理。中間鍵被分割為R塊後呼叫Reduce函式。R的大小(分割的數量)由使用者決定。
- MapReduce函式庫將輸入檔案首先分割為M塊,典型地每塊16MB或64MB。然後它啟用很多複製的原程式在一組機器上。
- 其中一個複製的程式是特殊的—主程式(the master)。剩下的是工作程式(workers),由主程式分配任務給它們。有M個map任務和R個reduce任務來分配。主程式挑選閒置程式,給它們分配一個map任務或一個reduce任務。
- 被分配map任務的工作程式讀取對應的輸入分片的內容,它將鍵值對解析出輸入資料,並把鍵值對傳給由使用者定義的map函式,map函式產生的中間鍵值對被快取入記憶體中。
- 定期地,快取的鍵值對被寫入本地磁碟中,透過分區功能劃分為 R 個區域。這些本地磁碟的緩衝鍵值的位址對被傳回主程式,由主程式來轉發這些位址給執行reduce函式的工作程式。
- 當一個執行reduce函式的工作程式被主程式告知這些位址時,它會使用遠端過程呼叫從map工作程式的本地磁碟讀取緩衝資料。當reduce工作程式讀取所有中間資料時,它會按中間鍵對其進行排序,以便將同一鍵的所有匹配項分組在一起。排序是必需的,因為通常許多不同的鍵對映到同一個歸約任務。如果中間資料量太大而無法放入記憶體,則使用外部排序。
- reduce工作程式遍歷排序的中間資料,對於遇到的每個唯一中間鍵,它將鍵和相應的中間值集傳遞給使用者的Reduce函式。Reduce函式的輸出將追加到此reduce分區的最終輸出檔案中。
- 當所有map任務和reduce任務完成,主程式(the master)喚醒使用者程式。此時,使用者程式中的MapReduce呼叫返回到使用者程式碼。
成功完成後,mapreduce執行的輸出將在R個輸出檔案中可用(每個reduce任務一個,檔名由使用者指定)。通常,使用者不需要將這些R輸出檔案合併到一個檔案中 - 他們通常將這些檔案作為輸入傳遞給另一個MapReduce呼叫,或者從另一個能夠處理分割為多個檔案的輸入的分散式應用程式中使用它們。
主資料結構
主節點保留多個資料結構。對於每個map任務和reduce任務,它儲存狀態(空閒、進行中或已完成)和工作電腦的標識(對於非空閒任務)。
主節點是從map任務傳播中間檔案區域的位置到reduce任務的管道。因此,對於每個已完成的map任務,master 儲存map任務生成的 R個中間檔案區域的位置和大小。map任務完成後,將收到對此位置和大小資訊的更新。資訊以增量方式推送給正在進行reduce任務的工作程式。
容錯
由於MapReduce函式庫旨在幫助使用數百或數千台機器處理大量資料,因此該函式庫必須優雅地容忍機器故障。
工作程式故障
Master 定期對每個 Worker 執行 ping 操作。如果在一定時間內沒有收到 Worker 的回應,Master 會將該 Worker 標記為失敗。工作人員完成的任何對映任務都會重置回其初始空閒狀態,因此有資格在其他工作人員上進行排程。同樣,發生故障的工作執行緒上正在進行的任何對映任務或減少任務也會重置為空閒狀態,並有資格重新安排。
已完成的對映任務會在發生故障時重新執行,因為它們的輸出儲存在故障電腦的本地磁碟上,因此無法存取。已完成的reduce任務不需要重新執行,因為它們的輸出儲存在全域檔案系統中。
當一個map任務先由worker A執行,然後由worker B執行(因為A失敗)時,所有執行reduce任務的worker會收到重新執行的通知。任何尚未從worker A讀取資料的reduce任務將從worker B讀取資料。
MapReduce 對大規模工作故障具有彈性。例如,在一次 MapReduce 操作期間,正在執行的叢集上的網路維護導致一次 80 台電腦組在幾分鐘內無法存取。 MapReduce master只是重新執行了無法存取的worker機器完成的工作,並繼續向前推進,最終完成MapReduce操作。
主程式故障
很容易讓主裝置寫入上述主資料結構的週期性檢查點。如果主任務終止,可以從最後一個檢查點狀態開始一個新的副本。然而,考慮到只有一個master,它發生故障的可能性不大;因此,如果主伺服器發生故障,我們當前的實作將中止 MapReduce 計算。客戶端可以檢查此情況並根據需要重試 MapReduce 操作。
出現故障時的語義
當使用者提供的map和reduce運算子是其輸入值的確定性函式時,我們的分散式實作產生的輸出與整個程式的無故障順序執行產生的輸出相同。
我們依靠map和reduce任務輸出的原子提交來實現此屬性。每個正在進行的任務將其輸出寫入私有臨時檔案。一個reduce 任務生成一個這樣的檔案,一個map 任務生成R 個這樣的檔案(每個reduce任務一個)。當map任務完成時,worker會向master傳送一條訊息,並在訊息中包含R個臨時檔案的名稱。如果master收到已經完成的map任務的完成訊息,它會忽略該訊息。否則,它將 R 檔案的名稱記錄在主資料結構中。
當reduce任務完成時,reduce工作執行緒自動將其臨時輸出檔案重新命名為最終輸出檔案。如果在多台機器上執行相同的reduce任務,則會對同一個最終輸出檔案執行多個重新命名呼叫。我們依靠底層檔案系統提供的原子重新命名操作來保證最終的檔案系統狀態僅包含一次執行reduce任務所產生的資料。
我們絕大多數的map和reduce運算子都是確定性的。
事實上,在這種情況下,我們的語義相當於順序執行,這使得程式設計師很容易推理他們的程式的行為。當map和/或reduce運算子不確定時,我們提供較弱但仍然合理的語義。在存在非確定性運算子的情況下,特定化簡任務的輸出R1相當於由非確定性程式的順序執行產生的R的輸出。然而,不同reduce任務R的輸出可以對應於由非確定性程式的不同順序執行產生的R的輸出。
地點
網路頻寬是我們的計算環境中相對稀缺的資源。我們利用輸入資料(由 GFS [8] 管理)儲存在組成叢集的電腦的本地磁碟上這一事實來節省網路頻寬。 GFS 將每個檔案劃分為64MB的塊,並將每個塊的多個副本(通常為 3 個副本)儲存在不同的機器上。MapReduce master考慮輸入檔案的位置資訊,並嘗試在包含相應輸入資料副本的電腦上安排對映任務。如果失敗,它會嘗試在該任務輸入資料的副本附近安排對映任務(例如,在與包含資料的機器位於同一網路交換機上的工作機器上)。當對叢集中很大一部分工作執行緒執行大型 MapReduce 操作時,大多數輸入資料都是在本地讀取的,並且不消耗網路頻寬。
任務粒度
M和R的大小存在限制。我們經常使用 2,000 台工作機器執行 M = 200, 000 和 R = 5, 000 的 MapReduce 計算。
備份任務
延長MapReduce操作總時間的常見原因之一是「落後者」:機器花費異常長的時間來完成計算中最後幾個map或reduce任務之一。掉隊者的出現可能有多種原因。例如,磁碟損壞的機器可能會頻繁遇到可糾正錯誤,從而將其讀取效能從30 MB/s降低到1 MB/s。叢集排程系統可能在機器上排程了其他任務,導致其由於CPU、記憶體、本地磁碟或網路頻寬的競爭而導致MapReduce程式碼執行速度變慢。我們最近遇到的一個問題是機器初始化程式碼中的一個錯誤,該錯誤導致處理器快取被停用:受影響的機器上的計算速度減慢了一百多倍。
我們有一個總體機制來緩解掉隊問題。當MapReduce操作接近完成時,主節點會安排剩餘正在進行的任務的備份執行。只要主執行或備份執行完成,任務就會標記為已完成。我們已經調整了這種機制,因此它通常會增加操作使用的計算資源不超過幾個百分點。我們發現這顯著減少了完成大型 MapReduce 操作的時間。
改進
分區功能
MapReduce的使用者指定他們想要的reduce任務/輸出檔案的數量(R)使用中間鍵上的分區函式對資料進行跨這些任務的分區。提供了使用雜湊的預設分區函式(例如「hash(key) mod R」)。這往往會產生相當平衡的分區。然而,在某些情況下,透過鍵的某些其他功能對資料進行分區很有用。例如,有時輸出鍵是 URL,我們希望單個主機的所有條目最終都在同一個輸出檔案中。為了支援這種情況,MapReduce 函式庫的使用者可以提供特殊的分區函式。例如,使用「hash(Hostname(urlkey)) mod R」作為分區函式會導致來自同一主機的所有 URL 最終出現在同一輸出檔案中。
排序保證
我們保證在給定的分區內,中間鍵/值對按遞增的鍵順序進行處理。這種順序保證可以輕鬆地為每個分區生成排序的輸出檔案,當輸出檔案格式需要支援按鍵進行高效的隨機存取查找,或者輸出的使用者發現對資料進行排序很方便時,這非常有用。
合路功能
在某些情況下,每個map任務產生的中間鍵存在顯著的重複,並且使用者指定的Reduce函式是可交換的和關聯的。由於詞頻往往遵循 Zipf 分布,因此每個對映任務將生成數百或數千條形式的記錄。所有這些計數都將透過網路傳送到單個reduce 任務,然後由Reduce函式加在一起以生成一個數字。我們允許使用者指定一個可選的組合器函式,該函式在透過網路傳送資料之前對該資料進行部分合併。
Combiner函式在每台執行map任務的機器上執行。通常,相同的程式碼用於實作組合器和化簡函式。 reduce 函式和組合器函式之間的唯一區別是 MapReduce 函式庫如何處理函式的輸出。化簡函式的輸出被寫入最終的輸出檔案。組合器函式的輸出被寫入中間檔案,該中間檔案將被傳送到reduce 任務。
部分組合顯著加速了某些類別的MapReduce操作。
輸入和輸出類型
MapReduce函式庫支援讀取多種不同格式的輸入資料。
副作用
在某些情況下,MapReduce 使用者發現生成輔助檔案作為其map和/或reduce運算子的附加輸出很方便。我們依靠應用程式編寫者來使此類副作用原子化和冪等。通常,應用程式會寫入臨時檔案,並在檔案完全生成後自動重新命名該檔案。
我們不支援單個任務生成的多個輸出檔案的原子兩階段提交。因此,生成具有跨檔案一致性要求的多個輸出檔案的任務應該是確定性的。這種限制在實踐中從來都不是問題。
跳過不良記錄
有時,使用者程式碼中存在錯誤,導致 Map 或 Reduce 函式在某些記錄上確定性崩潰。此類錯誤會阻止 MapReduce 操作完成。通常的做法是修復錯誤,但有時這是不可行的;也許該錯誤存在於第三方函式庫中,而該函式庫的原始碼不可用。此外,有時忽略一些記錄是可以接受的,例如在對大型資料集進行統計分析時。我們提供了一種可選的執行模式,其中 MapReduce 函式庫偵測哪些記錄導致確定性崩潰並跳過這些記錄以取得進展。
每個工作行程都安裝一個訊號處理程式來捕獲分段違規和匯流排錯誤。在呼叫使用者Map或Reduce操作之前,MapReduce函式庫將參數的序號儲存在全域變數中。如果使用者程式碼產生訊號,訊號處理程式向 MapReduce 主節點傳送包含序號的「最後一口氣」UDP 資料包。當Master在某一特定記錄上發現多個故障時,表明在下一次重新執行相應的Map或Reduce任務時應跳過該記錄。
本地執行
Map 或Reduce 函式中的除錯問題可能很棘手,因為實際計算發生在分散式系統中,通常在數千台機器上,工作分配決策由主機動態做出。為了幫助促進除錯、分析和小規模測試,我們開發了 MapReduce 函式庫的替代實作,它可以在本地電腦上按順序執行 MapReduce 操作的所有工作。向使用者提供控制項,以便將計算限制於特定的地圖任務。使用者使用特殊標誌呼叫他們的程式,然後可以輕鬆使用他們認為有用的任何除錯或測試工具(例如 gdb)。
狀態資訊
主站執行一個內部 HTTP 伺服器並匯出一組狀態頁面供人類使用。狀態頁面顯示計算的進度,例如已完成多少任務、正在進行多少任務、輸入位元組、中間資料位元組、輸出位元組、處理速率等。這些頁面還包含指向每個任務生成的標準錯誤和標準輸出檔案。使用者可以使用此資料來預測計算將花費多長時間,以及是否應將更多資源新增到計算中。這些頁面還可用於確定計算何時比預期慢得多。
此外,頂級狀態頁面還顯示哪些工作執行緒失敗了,以及失敗時他們正在處理哪些map和reduce任務。當嘗試診斷使用者程式碼中的錯誤時,此資訊非常有用。