
Jeffrey Dean@Google and Sanjay Ghemawat@Google
需要
Googleの業務量は、計算すべきデータが通常とても大きいことを決める。合理的な時間で終えるには、何百、何千台のマシンに分散して計算しなければならない。どう並列計算し、データを分配し、誤りを扱うかが問題になる。
これらの問題を解くため、著者は単純な計算を抽象化し、並列の細部、耐障害、データ分配、負荷分散を隠した。
著者が設計したプログラミングモデルは、Lispのmapとreduceプリミティブに着想を得ている。
プログラミングモデル
一組のキー値ペアが計算の入力、一組のキー値ペアが出力。
MapReduceライブラリはMap関数とReduce関数でこれを表す。
Map関数
Map関数はユーザーが書く。キー値ペアを入力とし、一組の中間キー値ペアを出す。MapReduceライブラリは同じキーから出た中間値を集め、Reduce関数に渡す。
Reduce関数
Reduce関数もユーザーが書く。中間キーと、そのキーの値の組を受け取る。これらの値をより小さい組に集約する。典型的には、Reduceの各呼び出しは0または1個の出力値を出す。中間値はイテレータ(iterator)経由でreduceに渡される。メモリに載らないほど大きな値の列を扱える。
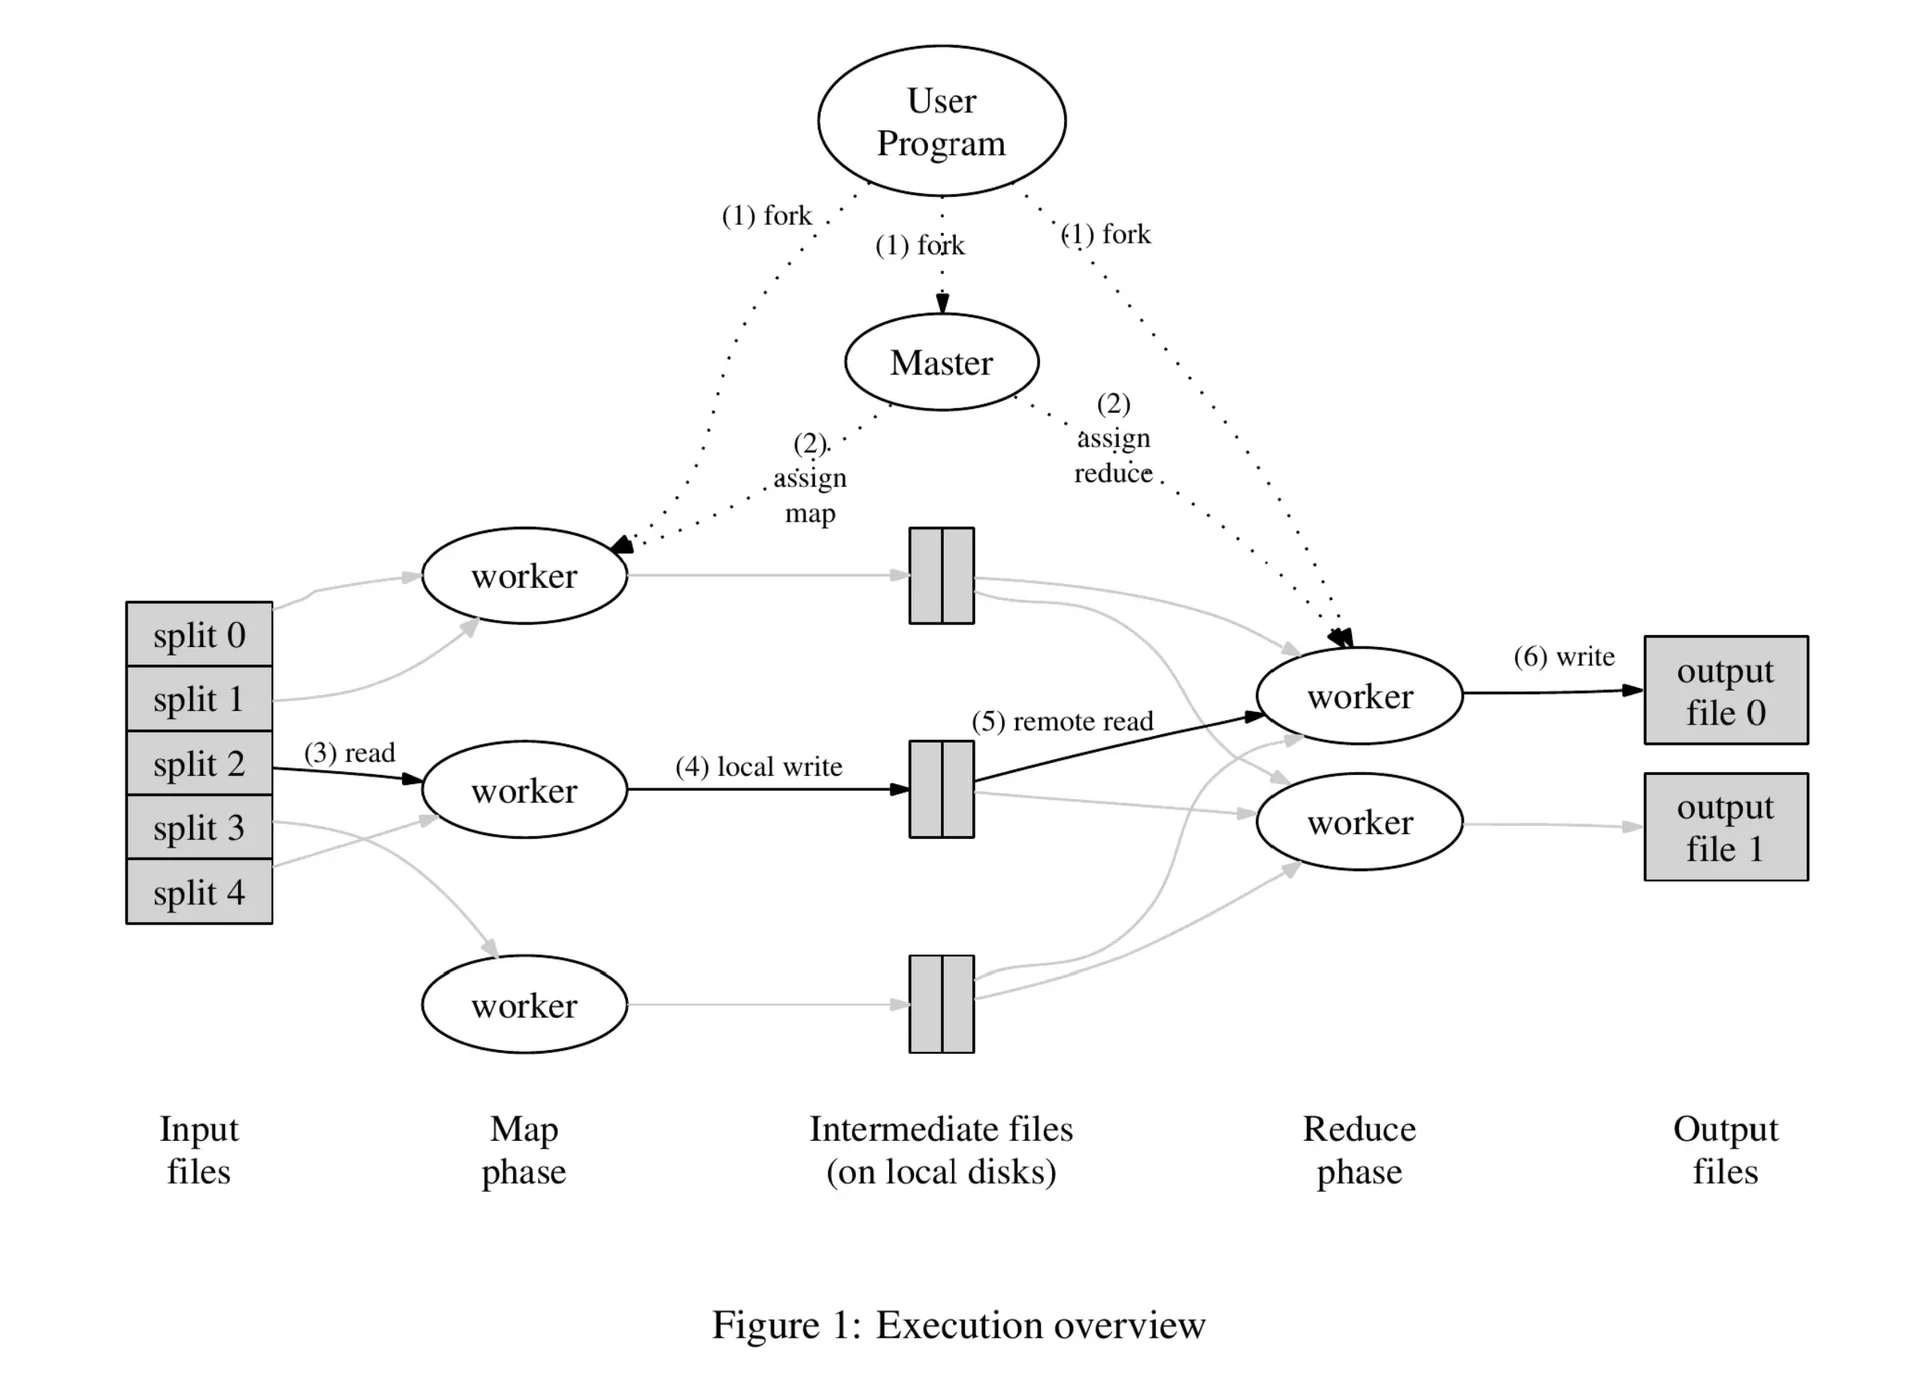
具体的な実装
Map関数の呼び出しは多くのマシンに割り当てられ、入力は自動的にM個の分割になる。入力分割は異なるマシンで並列に処理できる。中間キーはR個に分割されたあとReduceが呼ばれる。Rの大きさ(分割数)はユーザーが決める。
- MapReduceライブラリはまず入力ファイルをM個に分割する。典型的には各16MBまたは64MB。それからユーザープログラムの多くの複製を一組のマシンで起動する。
- 複製のうち一つは特別——主プログラム(the master)。残りはワーカー(workers)で、masterがタスクを割り当てる。割り当てるmapタスクはM個、reduceタスクはR個。masterは暇なプログラムを選び、mapかreduceを一つ割り当てる。
- mapタスクを割り当てられたワーカーは対応する入力シャードを読む。入力からキー値ペアを解析し、ユーザー定義のmap関数に渡す。mapが出した中間キー値ペアはメモリにキャッシュされる。
- 定期的に、キャッシュされたキー値ペアはローカルディスクに書かれ、パーティション機能でR領域に分けられる。これらのローカルディスク上のバッファ位置はmasterに戻り、masterがreduceを走らせているワーカーに転送する。
- reduceを実行するワーカーがmasterからこれらのアドレスを知らされると、RPCでmapワーカーのローカルディスクからバッファを読む。すべての中間データを読んだら、中間キーでソートし、同じキーの一致をまとめる。ソートは必要だ。多くの異なるキーが同じreduceタスクにマップされるのが普通だから。中間データがメモリに入らなければ外部ソートを使う。
- reduceワーカーはソート済み中間データを走査し、出会う各一意の中間キーについて、キーと対応する中間値の集合をユーザーのReduceに渡す。Reduceの出力はこのreduceパーティションの最終出力ファイルに追記される。
- すべてのmapとreduceが終わると、masterがユーザープログラムを起こす。このときユーザープログラム中のMapReduce呼び出しはユーザーコードに戻る。
成功後、mapreduce実行の出力はR個の出力ファイルで使える(reduceタスクごとに一つ、ファイル名はユーザー指定)。通常ユーザーはこれらRファイルを一つにマージしない——別のMapReduce呼び出しの入力にするか、複数ファイルに分割された入力を扱える別の分散アプリから使う。
主データ構造
masterは複数のデータ構造を持つ。各map/reduceタスクについて、状態(アイドル、進行中、完了)と、非アイドルならワーカーマシンの識別を保存する。
masterは、mapタスクが作った中間ファイル領域の位置をreduceタスクへ伝えるパイプだ。だから完了した各mapについて、masterはそのmapが生成したR個の中間領域の位置とサイズを持つ。map完了後、この位置とサイズの更新を受け取る。情報は進行中のreduceワーカーへ増分的にプッシュされる。
耐障害
MapReduceライブラリは数百、数千台で大量データを扱う助けなので、マシン故障を優雅に耐えなければならない。
ワーカー故障
Masterは定期的に各Workerをpingする。一定時間応答がなければ、そのWorkerを失敗とマークする。そのワーカーが完了したmapタスクは初期のアイドルに戻り、他のワーカーでスケジュール可能になる。故障ワーカー上の進行中のmap/reduceもアイドルに戻り、再スケジュール可能。
完了済みmapは故障時に再実行される。出力が故障マシンのローカルディスクにあり、アクセスできないからだ。完了済みreduceは再実行不要。出力はグローバルファイルシステムにある。
mapタスクがまずworker A、次にworker B(A失敗のため)で実行されると、reduceを実行中の全workerに再実行が通知される。まだAから読んでいないreduceはBから読む。
MapReduceは大規模ワーカー故障に耐える。あるMapReduce操作中、稼働クラスタのネットワーク保守で80台のグループが数分到達不能になった。MapReduce masterは到達不能ワーカーが終えた仕事を再実行し、前に進み、操作を完了した。
マスター故障
上記の主データ構造の周期チェックポイントをmasterに書かせるのは簡単だ。masterタスクが死ねば、最後のチェックポイントから新しい複製を始められる。しかしmasterは一つだけなので故障の可能性は低い。したがってmasterが故障したら、現在の実装はMapReduce計算を中止する。クライアントはこの状況を検査し、必要ならリトライできる。
故障時の意味論
ユーザー提供のmapとreduce演算子が入力の決定性関数なら、分散実装の出力は、プログラム全体の無故障な逐次実行の出力と同じ。
この性質はmap/reduceタスク出力の原子コミットに頼る。進行中の各タスクは出力を私有の一時ファイルに書く。reduceはそういうファイルを一つ、mapはR個(reduceごとに一つ)。map完了時、workerはR個の一時ファイル名を含むメッセージをmasterに送る。すでに完了したmapの完了メッセージなら、masterは無視する。そうでなければRファイル名を主データ構造に記録する。
reduce完了時、reduceワーカーは一時出力ファイルを最終出力ファイルへ原子的にリネームする。同じreduceが複数マシンで走れば、同じ最終出力へのリネームが複数回呼ばれる。下層ファイルシステムの原子リネームに頼り、最終FS状態にはそのreduceの一回の実行のデータだけが含まれることを保証する。
我々のmap/reduce演算子の圧倒的多数は決定的だ。
この場合、意味論は逐次実行と等価で、プログラマはプログラムの振る舞いを推理しやすい。mapおよび/またはreduceが非決定的なら、より弱いが依然妥当な意味論を提供する。非決定的演算子があるとき、特定のreduceタスクの出力R1は、非決定的プログラムのある逐次実行が生むRの出力に相当する。しかし異なるreduceタスクRの出力は、非決定的プログラムの異なる逐次実行に対応しうる。
局所性
ネットワーク帯域は計算環境で比較的乏しい資源だ。入力データ(GFS [8] が管理)がクラスタを構成するマシンのローカルディスクにあることを使い、帯域を節約する。GFSは各ファイルを64MBチャンクに分け、各チャンクの複数複製(通常3)を異なるマシンに置く。MapReduce masterは入力ファイルの位置情報を考え、対応する入力複製を持つマシンでmapタスクをスケジュールしようとする。失敗すれば、そのタスク入力の複製の近く(例えばデータを持つマシンと同じネットワークスイッチ上のワーカー)でスケジュールしようとする。クラスタの大部分のワーカーで大きなMapReduceを走らせると、入力のほとんどはローカルに読まれ、ネットワーク帯域を消費しない。
タスク粒度
MとRの大きさには制限がある。我々はよく2,000台のワーカーで M = 200,000、R = 5,000 のMapReduce計算を実行する。
バックアップタスク
MapReduce操作の総時間を延ばすよくある原因の一つが「遅れ」(straggler)だ:計算の最後のいくつかのmap/reduceの一つに異常に長い時間がかかるマシン。遅れの理由はいろいろある。例えばディスクが壊れたマシンは訂正可能エラーに頻繁に遭い、読み取りが30 MB/sから1 MB/sに落ちる。クラスタスケジューラが他のタスクを載せ、CPU・メモリ・ローカルディスク・ネットワーク競合でMapReduceコードが遅くなる。最近出会った問題は、マシン初期化コードのバグでプロセッサキャッシュが無効になったこと:影響を受けたマシンの計算は百倍以上遅くなった。
遅れを緩和する全体的な仕組みがある。MapReduce操作が完了に近づくと、masterは残りの進行中タスクのバックアップ実行をスケジュールする。主実行かバックアップ実行が終われば、タスクは完了とマークされる。この仕組みは調整済みで、通常、操作が使う計算資源を数パーセント以上は増やさない。大規模MapReduceの完了時間をはっきり減らすことが分かった。
改良
パーティション機能
MapReduceのユーザーは欲しいreduceタスク/出力ファイル数(R)を指定し、中間キー上のパーティション関数でこれらのタスクにデータを分ける。ハッシュを使うデフォルト(例えば hash(key) mod R)がある。かなり均衡した分割になりやすい。しかしキーの別の関数で分けると便利な場合もある。例えば出力キーがURLで、同一ホストの全エントリを同じ出力ファイルにしたい。これを支えるため、ユーザーは特別なパーティション関数を提供できる。hash(Hostname(urlkey)) mod R を使うと、同一ホストの全URLが同じ出力ファイルに入る。
順序保証
与えられたパーティション内で、中間キー/値ペアは増加するキー順で処理されると保証する。この順序保証で、パーティションごとにソート済み出力ファイルを簡単に作れる。出力形式がキーによる効率的なランダムアクセスを要する場合や、出力の利用者がデータのソートを便利と感じるときに有用だ。
コンバイナ機能
各mapが出す中間キーに顕著な重複があり、ユーザー指定のReduceが可換かつ結合的な場合がある。単語頻度はZipf分布に従いがちなので、各mapタスクはその形のレコードを数百、数千出す。これらのカウントはすべてネットワークで単一のreduceへ送られ、Reduceが足して一つの数にする。ユーザーは任意のコンバイナ関数を指定でき、ネットワーク送信前にデータを部分的にマージする。
Combinerはmapタスクを実行する各マシンで走る。通常、コンバイナとreduceは同じコードで実装する。違いはMapReduceライブラリが関数の出力をどう扱うかだけ。reduceの出力は最終出力ファイルへ。コンバイナの出力は中間ファイルへ書かれ、reduceタスクへ送られる。
部分結合は一部の種類のMapReduce操作をはっきり速くする。
入力と出力の型
MapReduceライブラリは多様な形式の入力データを読む。
副作用
MapReduceユーザーが、mapおよび/またはreduce演算子の追加出力として補助ファイルを出すと便利な場合がある。そうした副作用を原子的かつ冪等にするのはアプリケーション作者に頼る。通常、アプリは一時ファイルを書き、ファイルが完全に生成されたら原子的にリネームする。
単一タスクが生成する複数出力ファイルの原子的二相コミットは支えない。したがってファイル間の一貫性が要る複数出力を出すタスクは決定的であるべきだ。この制限は実践では問題になったことがない。
不良レコードのスキップ
ユーザーコードのバグで、MapまたはReduceがあるレコードで決定的にクラッシュすることがある。そうした誤りはMapReduce操作の完了を阻む。普通はバグを直すが、実行不能なこともある。サードパーティライブラリにあり、ソースが無いのかもしれない。また、大きなデータセットの統計分析など、いくつかのレコードを無視してよい場合もある。任意の実行モードを提供し、MapReduceライブラリが決定的クラッシュを起こすレコードを検出し、それらをスキップして前進する。
各ワーカープロセスはセグメンテーション違反とバスエラーを捉えるシグナルハンドラを入れる。ユーザーのMap/Reduceを呼ぶ前、ライブラリは引数のシーケンス番号をグローバル変数に置く。ユーザーコードがシグナルを出せば、ハンドラはシーケンス番号を含む「最後の息」UDPパケットをMapReduce masterに送る。Masterがある特定レコードで複数の故障を見ると、次回の該当Map/Reduce再実行でそのレコードをスキップすべきだと示す。
ローカル実行
MapまたはReduceのデバッグは厄介になりうる。実際の計算は分散システム、しばしば数千台で起き、仕事の割り当てはmasterが動的に決めるからだ。デバッグ、プロファイリング、小規模テストのため、ローカルマシンでMapReduce操作の全仕事を逐次実行する代替実装を作った。特定のmapタスクに計算を制限するコントロールをユーザーに出す。特別なフラグでプログラムを呼び、gdbなど有用と思う任意のデバッグ/テストツールを簡単に使える。
状態情報
masterは内部HTTPサーバを走らせ、人間向けの状態ページ一式をエクスポートする。状態ページは計算の進捗を示す:完了タスク数、進行中タスク数、入力バイト、中間データバイト、出力バイト、処理速度など。各タスクが生成した標準エラーと標準出力ファイルへのリンクもある。ユーザーはこのデータで、計算がどれだけかかるか、もっと資源を足すべきかを予測できる。計算が想定よりずっと遅いときを判断するのにも使える。
さらにトップの状態ページは、どのワーカーが失敗したか、失敗時にどのmap/reduceを処理していたかを示す。ユーザーコードの誤りを診断しようとするときに非常に有用だ。