
Jeffrey Dean@Google and Sanjay Ghemawat@Google
Le besoin
Le volume de Google décide que les données à calculer sont en général énormes. Il faut les répartir sur des centaines ou des milliers de machines pour finir en un temps raisonnable. Comment paralléliser, distribuer les données, gérer les fautes, ça devient le problème.
Pour ça, les auteurs extraient un calcul simple, et cachent les détails du parallèle, la tolérance aux pannes, la distribution des données et l’équilibrage de charge.
Le modèle de programmation qu’ils ont conçu s’inspire des primitives map et reduce de Lisp.
Modèle de programmation
Un ensemble de paires clé/valeur en entrée du calcul, un ensemble de paires clé/valeur en sortie.
La bibliothèque MapReduce l’exprime par une fonction Map et une fonction Reduce.
Fonction Map
Map, écrite par l’utilisateur, prend une paire clé/valeur et produit un ensemble de paires intermédiaires. La bibliothèque MapReduce rassemble toutes les valeurs intermédiaires du même clé et les passe à Reduce.
Fonction Reduce
Reduce, aussi écrite par l’utilisateur, reçoit une clé intermédiaire et un ensemble de valeurs pour cette clé. Elle agrège ces valeurs en un ensemble éventuellement plus petit. Typiquement, chaque appel Reduce écrit 0 ou 1 valeur de sortie. Les valeurs intermédiaires arrivent à reduce via un itérateur (iterator). Ça permet de traiter une série trop grande pour tenir en mémoire.
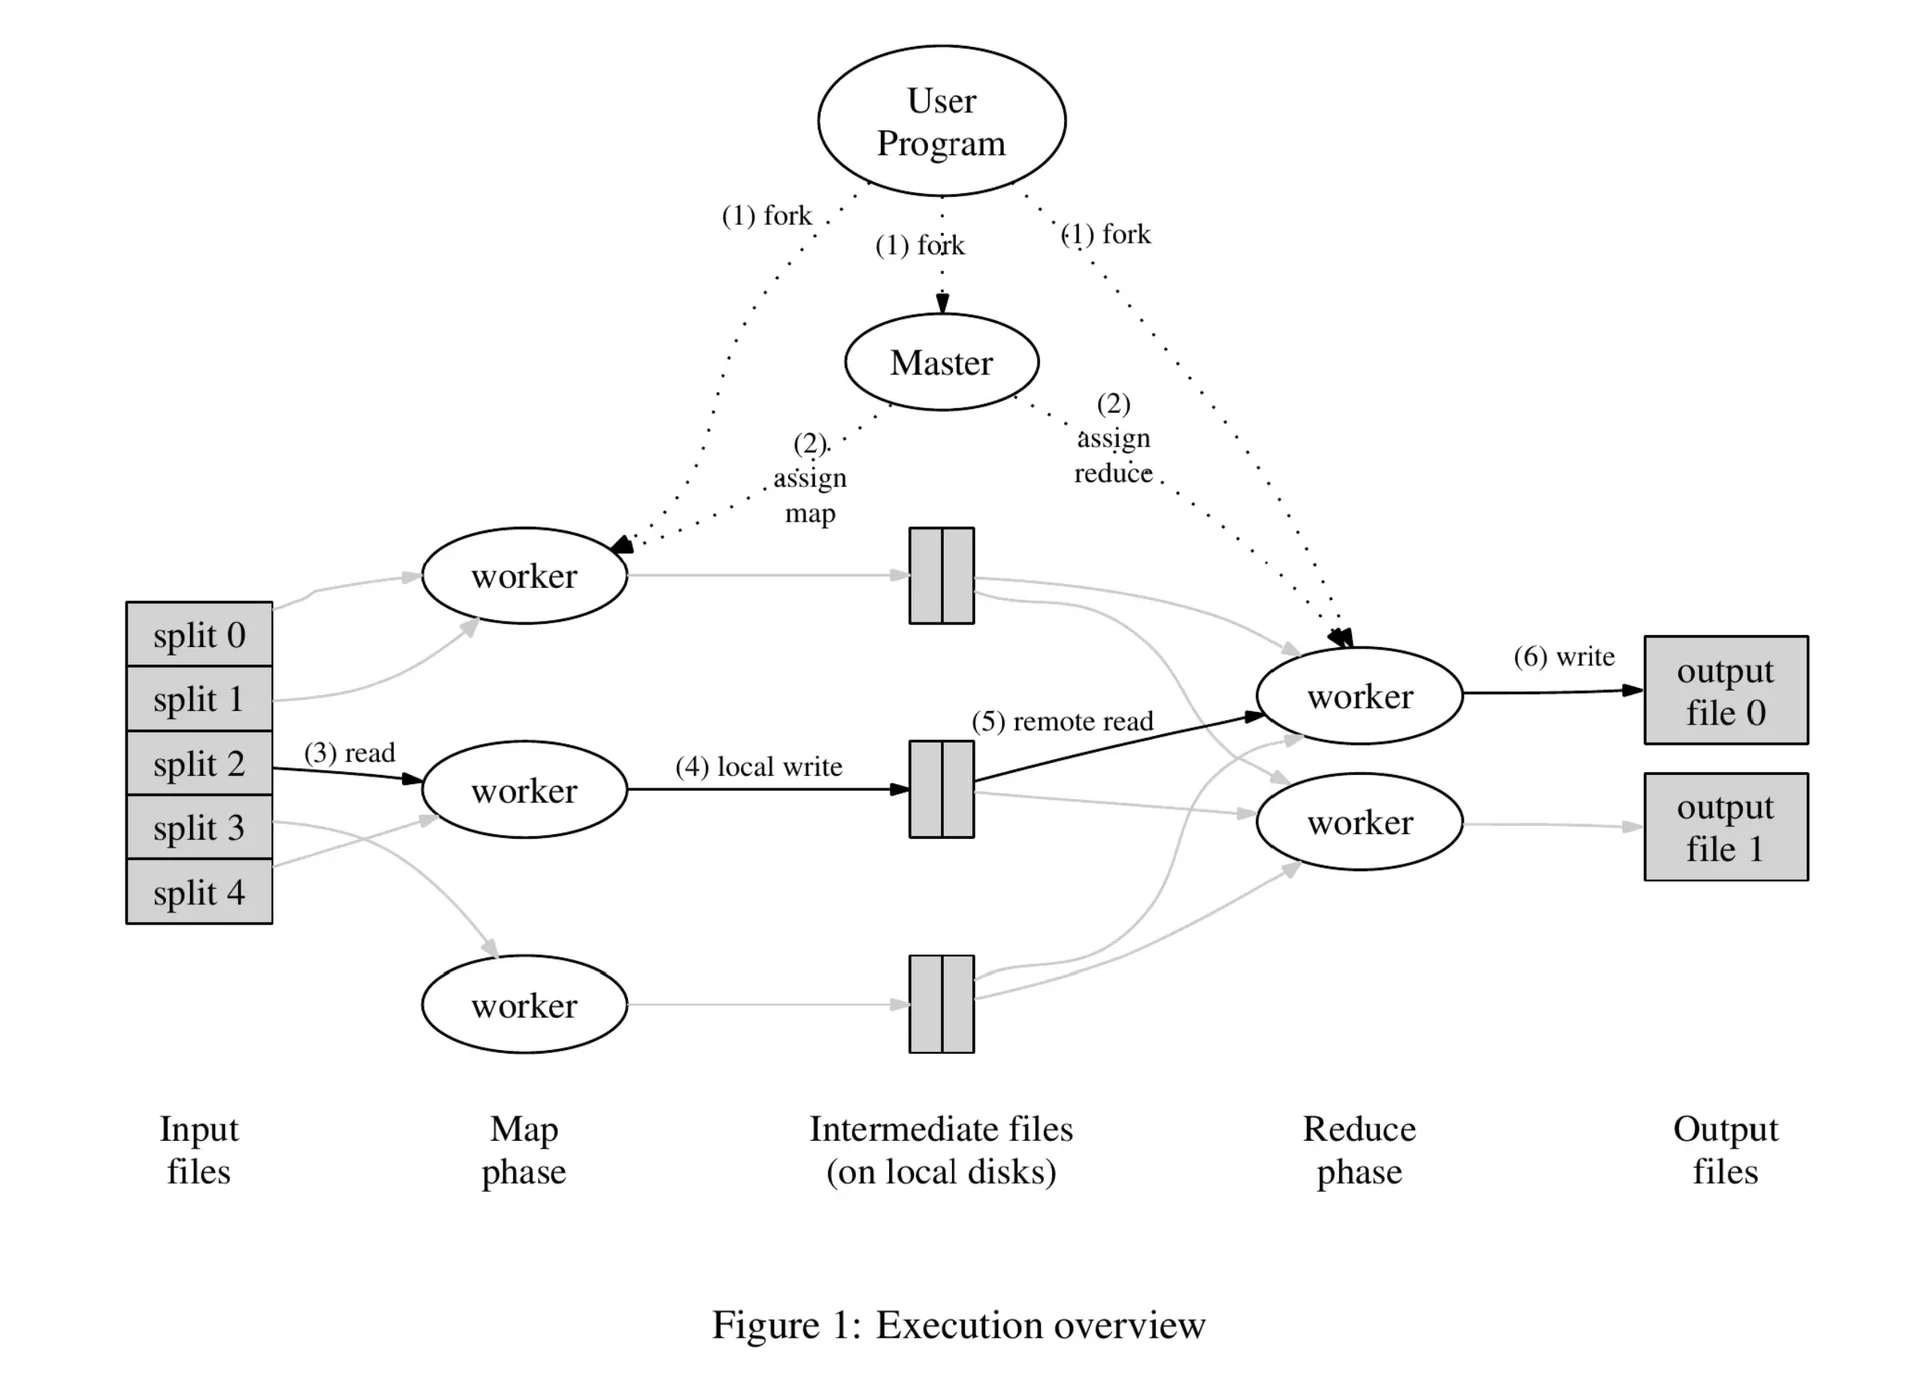
Implémentation
Les appels Map sont répartis sur beaucoup de machines. L’entrée est automatiquement coupée en M morceaux, que des machines différentes peuvent traiter en parallèle. Les clés intermédiaires sont coupées en R morceaux, puis Reduce est appelé. R (le nombre de partitions) est choisi par l’utilisateur.
- La bibliothèque MapReduce coupe d’abord les fichiers d’entrée en M blocs, typiquement 16 Mo ou 64 Mo. Puis elle lance beaucoup de copies du programme utilisateur sur un ensemble de machines.
- Une copie est spéciale — le master. Le reste, ce sont les workers ; le master leur assigne des tâches. Il y a M tâches map et R tâches reduce à assigner. Le master prend un programme idle, lui donne un map ou un reduce.
- Un worker assigné à un map lit le split d’entrée correspondant, parse les paires clé/valeur, les passe à la map définie par l’utilisateur. Les paires intermédiaires de map sont bufferisées en mémoire.
- Périodiquement, les paires bufferisées sont écrites sur le disque local, découpées en R régions par la fonction de partition. Les adresses de ces buffers sur disque local reviennent au master, qui les transmet aux workers qui font reduce.
- Quand un worker reduce est informé de ces adresses, il lit les buffers depuis les disques locaux des map workers par RPC. Une fois toutes les données intermédiaires lues, il trie par clé intermédiaire pour grouper les occurrences de la même clé. Le tri est obligatoire : beaucoup de clés différentes mappent souvent vers la même tâche reduce. Si les données intermédiaires sont trop grosses pour la mémoire, un tri externe.
- Le worker reduce parcourt les données triées. Pour chaque clé intermédiaire unique, il passe la clé et l’ensemble de valeurs au Reduce utilisateur. La sortie de Reduce est appendue au fichier de sortie final de cette partition reduce.
- Quand tous les map et reduce sont finis, le master réveille le programme utilisateur. À ce moment, l’appel MapReduce dans le programme utilisateur revient au code utilisateur.
Après un succès, la sortie de l’exécution mapreduce est disponible dans R fichiers (un par reduce, noms choisis par l’utilisateur). En général l’utilisateur ne fusionne pas ces R fichiers — il les passe en entrée d’un autre appel MapReduce, ou les utilise depuis une autre appli distribuée capable de gérer une entrée partitionnée en plusieurs fichiers.
Structures de données du master
Le nœud master garde plusieurs structures. Pour chaque tâche map et reduce, il stocke l’état (idle, en cours, ou terminé) et l’identité de la machine worker (pour les tâches non idle).
Le master est le tuyau qui propage les emplacements des régions de fichiers intermédiaires des map vers les reduce. Donc pour chaque map terminé, le master stocke emplacement et taille des R régions intermédiaires générées. Après un map fini, il reçoit une mise à jour de ces infos. L’info est poussée de façon incrémentale aux workers en train de reduce.
Tolérance aux pannes
Comme la bibliothèque MapReduce vise à traiter d’énormes données sur des centaines ou des milliers de machines, elle doit tolérer élégamment les pannes.
Panne d’un worker
Le master ping chaque worker régulièrement. S’il n’a pas de réponse dans un délai, il marque le worker comme failed. Tout map terminé par ce worker est remis idle, donc replanifiable ailleurs. De même, tout map ou reduce en cours sur le worker en panne est remis idle et replanifiable.
Les map terminés sont réexécutés en cas de panne, parce que leur sortie est sur le disque local de la machine morte, donc inaccessible. Les reduce terminés n’ont pas besoin d’être réexécutés : leur sortie est dans le système de fichiers global.
Quand un map est d’abord exécuté par worker A, puis par worker B (parce que A a fail), tous les workers reduce reçoivent la notif de réexécution. Tout reduce qui n’a pas encore lu chez A lira chez B.
MapReduce tient face à des pannes de workers à grande échelle. Exemple : pendant une opération MapReduce, une maintenance réseau sur le cluster a rendu un groupe de 80 machines injoignable pendant quelques minutes. Le master a simplement réexécuté le travail de ces workers injoignables, a continué, et a fini l’opération.
Panne du master
C’est facile de faire écrire au master des checkpoints périodiques des structures ci-dessus. Si la tâche master meurt, une nouvelle copie peut partir du dernier checkpoint. Mais il n’y a qu’un master, donc une panne est peu probable ; si le master tombe, l’implémentation actuelle abort le calcul MapReduce. Le client peut détecter ça et retry si besoin.
Sémantique en cas de panne
Quand map et reduce fournis par l’utilisateur sont des fonctions déterministes de leurs entrées, l’implémentation distribuée produit la même sortie qu’une exécution séquentielle sans faute du programme entier.
On s’appuie sur le commit atomique des sorties map/reduce. Chaque tâche en cours écrit sa sortie dans des fichiers temporaires privés. Un reduce produit un tel fichier, un map en produit R (un par reduce). Quand un map finit, le worker envoie au master un message avec les noms des R fichiers temp. Si le master reçoit un message de completion pour un map déjà fini, il l’ignore. Sinon il enregistre les R noms dans les structures master.
Quand un reduce finit, le worker reduce renomme atomiquement son fichier temp en fichier de sortie final. Si le même reduce tourne sur plusieurs machines, il y a plusieurs appels rename sur le même fichier final. On s’appuie sur le rename atomique du système de fichiers sous-jacent pour que l’état final du FS ne contienne que les données d’une seule exécution de ce reduce.
La grande majorité de nos opérateurs map et reduce sont déterministes.
Dans ce cas, notre sémantique équivaut à une exécution séquentielle, ce qui rend facile de raisonner sur le comportement du programme. Quand map et/ou reduce sont non déterministes, on donne une sémantique plus faible mais encore raisonnable. En présence d’opérateurs non déterministes, la sortie R1 d’un reduce particulier équivaut à la sortie de R produite par une exécution séquentielle du programme non déterministe. Les sorties de reduce différents peuvent toutefois correspondre à des exécutions séquentielles différentes de ce programme.
Localité
La bande passante réseau est une ressource relativement rare dans notre environnement. On économise en utilisant le fait que les données d’entrée (gérées par GFS [8]) sont stockées sur les disques locaux des machines du cluster. GFS coupe chaque fichier en chunks de 64 Mo et stocke plusieurs réplicas de chaque chunk (typiquement 3) sur des machines différentes. Le master MapReduce tient compte de la localisation des fichiers d’entrée et essaie de planifier un map sur une machine qui a déjà une copie de l’entrée correspondante. Si ça échoue, il essaie près d’une copie (par ex. un worker sur le même switch que la machine qui a les données). Quand un gros MapReduce tourne sur une grande fraction des workers du cluster, la plupart de l’entrée se lit en local, sans consommer de bande passante.
Granularité des tâches
Il y a des limites sur M et R. On exécute souvent des calculs MapReduce avec M = 200 000 et R = 5 000 sur 2 000 machines workers.
Tâches backup
Une cause fréquente qui allonge le temps total d’un MapReduce, ce sont les « stragglers » : une machine qui met un temps anormalement long à finir un des derniers map ou reduce. Plusieurs raisons possibles. Une machine au disque abîmé peut rencontrer souvent des erreurs corrigeables, et passer de 30 Mo/s à 1 Mo/s en lecture. Le scheduler du cluster a pu poser d’autres tâches sur la machine, d’où contention CPU, mémoire, disque local ou réseau. Un bug récent dans le code d’init machine désactivait le cache processeur : le calcul sur les machines touchées ralentissait de plus de cent fois.
On a un mécanisme général pour atténuer les stragglers. Quand l’opération MapReduce approche de la fin, le master planifie des exécutions backup des tâches encore en cours. Dès que l’exécution principale ou la backup finit, la tâche est marquée complete. On a réglé ça pour que ça n’ajoute en général que quelques pourcents de ressources. On a vu que ça réduit nettement le temps de finir de gros MapReduce.
Raffinements
Fonction de partition
Les utilisateurs MapReduce spécifient le nombre de reduce / fichiers de sortie voulu (R). Les données sont partitionnées entre ces tâches par une fonction de partition sur la clé intermédiaire. Une partition par défaut avec hash est fournie (ex. hash(key) mod R). Ça tend à donner des partitions assez équilibrées. Parfois partitionner par une autre fonction de la clé est utile. Exemple : la clé de sortie est une URL, et on veut toutes les entrées d’un même host dans le même fichier. Pour ça, l’utilisateur peut fournir une fonction spéciale. hash(Hostname(urlkey)) mod R met toutes les URL du même host dans le même fichier de sortie.
Garanties d’ordre
On garantit que, dans une partition donnée, les paires intermédiaires sont traitées par clé croissante. Cette garantie d’ordre rend facile de produire un fichier de sortie trié par partition, utile quand le format de sortie a besoin d’accès aléatoire efficace par clé, ou quand l’utilisateur de la sortie trouve pratique que les données soient triées.
Fonction combiner
Parfois il y a beaucoup de répétition des clés intermédiaires produites par chaque map, et le Reduce utilisateur est commutatif et associatif. Les fréquences de mots suivent souvent une Zipf, donc chaque map produit des centaines ou des milliers d’enregistrements de cette forme. Tous ces comptes partiraient sur le réseau vers un seul reduce, puis Reduce les additionnerait en un nombre. On laisse l’utilisateur spécifier un combiner optionnel, qui fusionne partiellement ces données avant l’envoi réseau.
Le combiner tourne sur chaque machine qui exécute un map. En général le même code implémente combiner et reduce. La seule différence, c’est comment la bibliothèque MapReduce traite la sortie. La sortie de reduce va dans le fichier final. La sortie du combiner va dans un fichier intermédiaire envoyé à une tâche reduce.
Le combinage partiel accélère nettement certaines classes d’opérations MapReduce.
Types d’entrée et de sortie
La bibliothèque MapReduce sait lire beaucoup de formats d’entrée.
Effets de bord
Parfois les utilisateurs trouvent pratique de produire des fichiers auxiliaires comme sortie extra de leurs opérateurs map et/ou reduce. On compte sur l’auteur de l’appli pour rendre ces side effects atomiques et idempotents. Typiquement l’appli écrit un fichier temp et le renomme atomiquement une fois le fichier entièrement généré.
On ne supporte pas un commit atomique en deux phases de plusieurs fichiers de sortie d’une seule tâche. Donc une tâche qui produit plusieurs fichiers avec une exigence de cohérence entre fichiers devrait être déterministe. Cette limite n’a jamais été un problème en pratique.
Sauter les mauvais enregistrements
Parfois un bug dans le code utilisateur fait crasher Map ou Reduce de façon déterministe sur certains records. Ça empêche l’opération MapReduce de finir. D’habitude on corrige le bug, mais parfois ce n’est pas faisable ; le bug est peut-être dans une lib tierce sans source. Et parfois ignorer quelques records est acceptable, par ex. une analyse statistique sur un gros dataset. On fournit un mode d’exécution optionnel où la bibliothèque détecte quels records causent un crash déterministe et les saute pour avancer.
Chaque processus worker installe un handler de signal pour les violations de segmentation et les bus errors. Avant d’appeler Map ou Reduce utilisateur, la bibliothèque stocke le numéro de séquence de l’argument dans une variable globale. Si le code utilisateur lève un signal, le handler envoie au master un paquet UDP « dernier souffle » avec le numéro de séquence. Quand le master voit plusieurs pannes sur un record donné, il indique qu’il faudra sauter ce record à la prochaine réexécution de ce Map ou Reduce.
Exécution locale
Déboguer Map ou Reduce peut être pénible, parce que le vrai calcul se passe dans un système distribué, souvent sur des milliers de machines, avec l’assignation du travail décidée dynamiquement par le master. Pour aider debug, profiling et tests à petite échelle, on a développé une implémentation alternative de la bibliothèque qui exécute tout le travail d’une opération MapReduce séquentiellement sur la machine locale. L’utilisateur a des contrôles pour limiter le calcul à des map tasks particuliers. Il lance le programme avec un flag spécial, puis peut utiliser n’importe quel outil de debug ou de test utile (gdb, par ex.).
Infos d’état
Le master fait tourner un serveur HTTP interne et exporte un ensemble de pages d’état pour les humains. Les pages montrent la progression : combien de tâches finies, combien en cours, octets d’entrée, octets intermédiaires, octets de sortie, débit, etc. Elles ont aussi des liens vers stderr et stdout de chaque tâche. L’utilisateur peut s’en servir pour prédire combien de temps ça va prendre, et s’il faut ajouter des ressources. Les pages servent aussi à voir quand un calcul est beaucoup plus lent que prévu.
La page d’état top-level montre aussi quels workers ont fail, et quels map/reduce ils traitaient à ce moment. Très utile pour diagnostiquer des bugs dans le code utilisateur.