
原文作者:jaypume
原公開課影片:https://www.bilibili.com/video/BV1hg4y1b78L
原文地址:https://github.com/jaypume/article/blob/main/sedna/邊雲協同AI框架Sedna原始碼解析/README.MD
轉載供自己學習使用,方便查閱。
KubeEdge-Sedna概述
Sedna是在KubeEdge SIG AI中孵化的一個邊雲協同AI專案。得益於KubeEdge提供的邊雲協同能力,Sedna可以實現跨邊雲的協同訓練和協同推理能力,如聯合推理、增量學習、聯邦學習、終身學習等。Sedna支援目前廣泛使用的AI框架,如TensorFlow/Pytorch/MindSpore等,現有AI類應用可以無縫遷移到Sedna, 快速實現邊雲協同的訓練和推理,可在降低成本、提升模型效能、保護資料隱私等方面獲得提升。
專案主頁:
https://github.com/kubeedge/sedna
文件參考:
整體架構
Sedna的邊雲協同基於KubeEdge提供的如下能力實現
- 跨邊雲應用統一編排
- Router: 管理面雲邊高可靠訊息通道
- EdgeMesh: 資料面跨邊雲微服務發現和流量治理
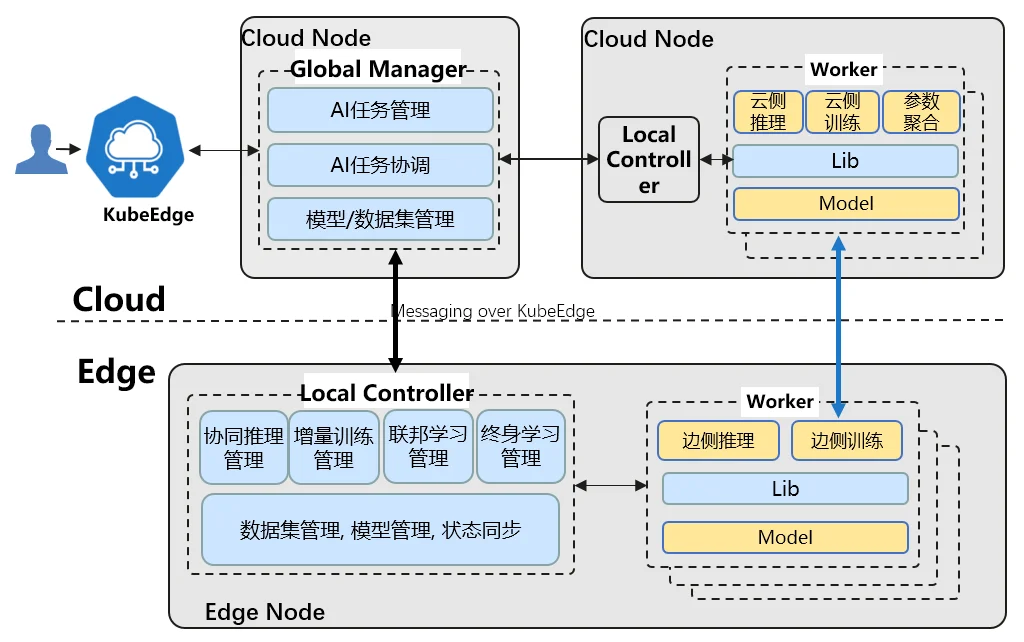
基本元件:
- GlobalManager
- 統一邊雲協同AI任務管理
- 跨邊雲協同管理與協同
- 中心配置管理
- LocalController
- 邊雲協同AI任務的本地流程控制
- 本地通用管理: 模型,資料集,狀態同步等
- Lib
- 面向AI開發者和應用開發者,暴露邊雲協同AI功能給應用
- Worker
- 執行訓練或推理任務, 基於現有AI框架開發的訓練/推理程式
- 不同特性對應不同的worker組,worker可部署在邊上或雲上,並進行協同
工程目錄
| 目錄 | 說明 |
|---|---|
| .github | Sedna github CICD流水線配置。 |
| LICENSES | Sedna Licenses以及相關vendor Licenses。 |
| build | GM/LC等管理面構建的Dockersfile;生成的CRD定義yaml檔案;CRD樣例yaml檔案; |
| cmd | GM/LC管裡面的啟動函式。 |
| components | 監控和圖形化展示的元件。 |
| docs | proposals和安裝文件。 |
| examples | 協同推理、增量學習、終身學習、聯邦學習的使用樣例。 |
| hack | 面向開發者的程式碼生成工具、及其他開發會用到的指令碼。 |
| lib | Sedna Library,用於開發邊雲協同AI應用的Python依賴庫。 |
| pkg | API定義;生成的CRD的client-go程式碼;Sedna GM/LC 管裡面的核心程式碼。 |
| scripts | 面向使用者的安裝指令碼。 |
| test | E2E測試程式碼及測試工具。 |
| vendor | 依賴的第三方專案原始碼。 |
Sedna管理面原始碼解析(Go)
GM: Global Manager
GM,一個K8S operator
operator是什麼?
An Operator is an application-specific controller that extends the Kubernetes API to create, configure and manage instances of complex stateful applications on behalf of a Kubernetes user. It builds upon the basic Kubernetes resource and controller concepts, but also includes domain or application-specific knowledge to automate common tasks better managed by computers. 1
對於Sedna,Sedna控制了邊雲協同AI應用中,如何配置worker部署啟動參數、如何協同、如何流轉等,那麼我們可以這麼定義:Sedna GM是“邊雲協同AI應用“這個特定領域的控制器。
The following components form the three main parts of an operator:
- API: The data that describes the operand’s configuration. The API includes:
- Custom resource definition (CRD), which defines a schema of settings available for configuring the operand.
- Programmatic API, which defines the same data schema as the CRD and is implemented using the operator’s programming language, such as Go.
- Custom resource (CR), which specifies values for the settings defined by the CRD; these values describe the configuration of an operand.
- Controller: The brains of the operator. The controller creates managed resources based on the description in the custom resource; controllers are implemented using the operator’s programming language, such as Go. 2
透過上面Redhat的定義,我們可以看到組成一個k8s operator幾個重要的概念包括 CRD、API、CR和Controller。
下面是Sedna GM Operator的示意圖:
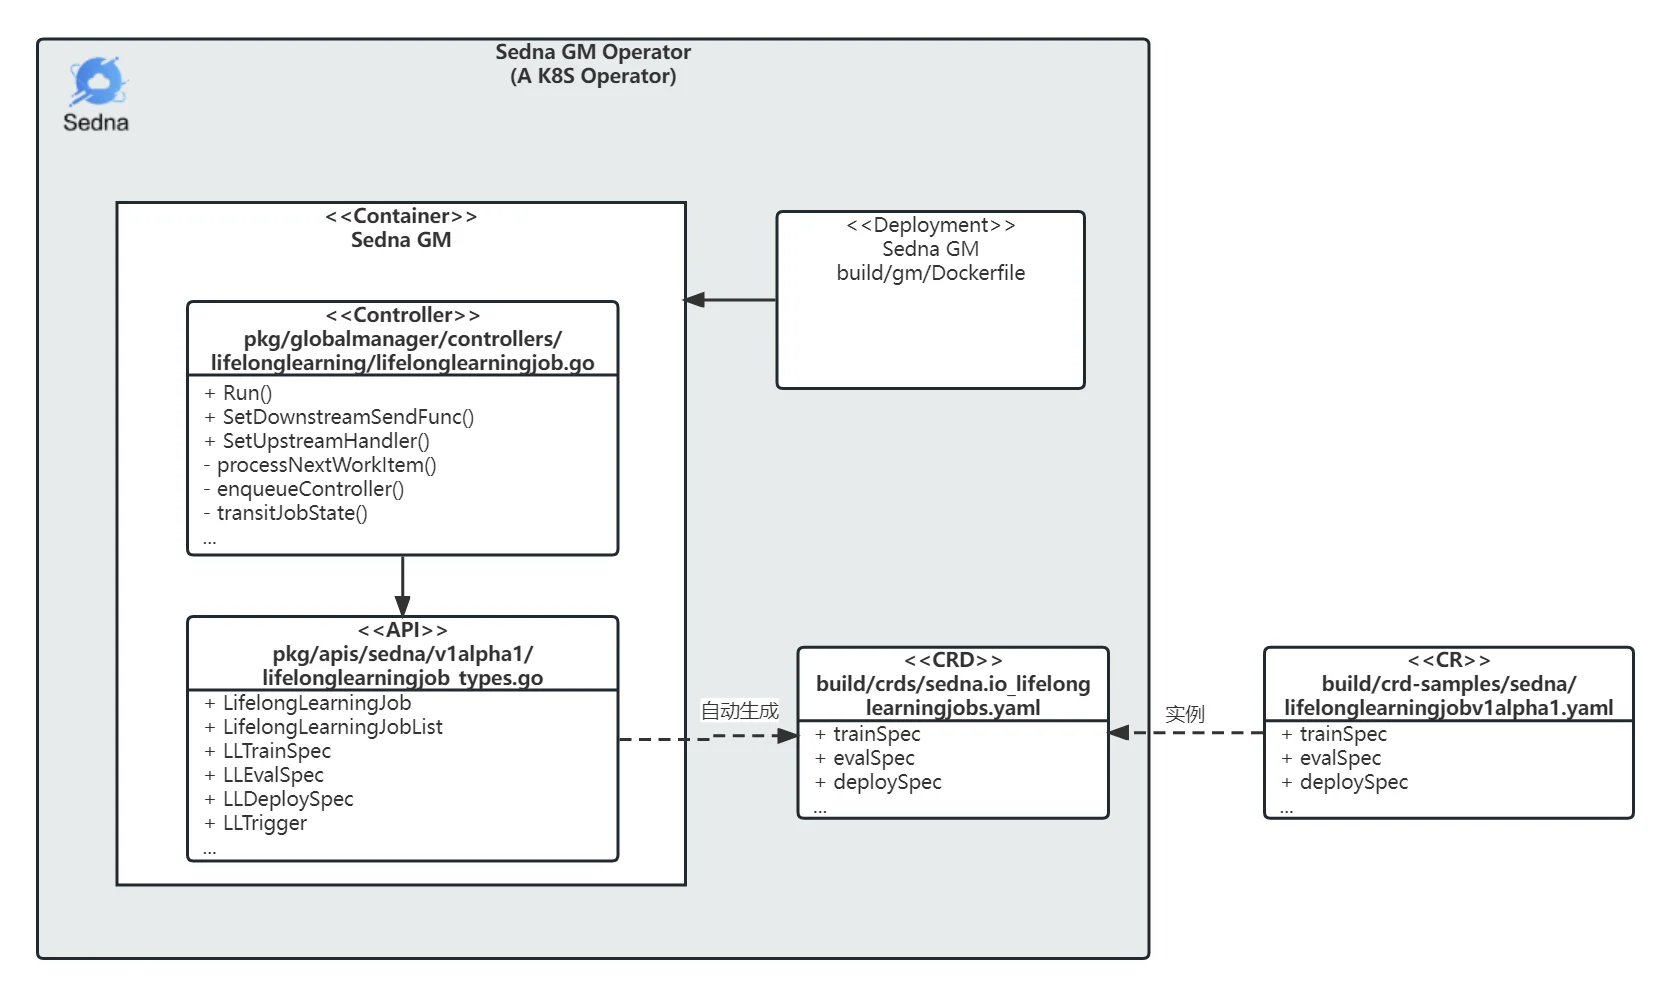
接下來的章節會按照組成K8S operator的幾個元件來展開說明,包括CR、CRD、API、Controller,其中Controller是主要的控制邏輯模組。
CR
Sedna本身支援邊雲協同推理、增量學習、終身學習、聯邦學習,為了方便解讀程式碼,本文結合終身學習具體特性和樣例來分析。其他三個特性的程式碼實現存在共通之處,可以類比參考。
CR樣例
這裡貼了一段終身學習CR樣例,可以基於這個CR透過kubectl來建立對應的終身學習資源物件,詳細使用步驟可以參考這裡。其中關鍵的欄位解釋如下:
- dataset:指定資料集物件名稱,資料集也是一個CR資源。
- trainSpec:終身學習中,訓練worker的啟動參數,包括映象和環境變數等容器配置。
- trigger:終身學習中,啟動訓練worker的觸發條件。
- evalSpec:終身學習中,評估work的啟動參數,包括映象和環境變數等容器配置。
- deploySpec:終身學習中,推理work的啟動參數,包括映象和環境變數等容器配置。
- outputDir:終身學習中,訓練生成的模型檔案輸出路徑。
build/crd-samples/sedna/lifelonglearningjobv1alpha1.yaml
apiVersion: sedna.io/v1alpha1
kind: LifelongLearningJob
metadata:
  name: atcii-classifier-demo
spec:
  dataset:
    name: "lifelong-dataset"
    trainProb: 0.8
  trainSpec:
    template:
      spec:
        nodeName:  "edge-node"
        containers:
          - image: kubeedge/sedna-example-lifelong-learning-atcii-classifier:v0.3.0
            name:  train-worker
            imagePullPolicy: IfNotPresent
            args: ["train.py"]
            env:
              - name: "early_stopping_rounds"
                value: "100"
              - name: "metric_name"
                value: "mlogloss"
    trigger:
      checkPeriodSeconds: 60
      timer:
        start: 02:00
        end: 24:00
      condition:
        operator: ">"
        threshold: 500
        metric: num_of_samples
  evalSpec:
    template:
      spec:
        nodeName:  "edge-node"
        containers:
          - image: kubeedge/sedna-example-lifelong-learning-atcii-classifier:v0.3.0
            name:  eval-worker
            imagePullPolicy: IfNotPresent
            args: ["eval.py"]
            env:
              - name: "metrics"
                value: "precision_score"
              - name: "metric_param"
                value: "{'average': 'micro'}"
              - name: "model_threshold"
                value: "0.5"
  deploySpec:
    template:
      spec:
        nodeName:  "edge-node"
        containers:
        - image: kubeedge/sedna-example-lifelong-learning-atcii-classifier:v0.3.0
          name:  infer-worker
          imagePullPolicy: IfNotPresent
          args: ["inference.py"]
          env:
          - name: "UT_SAVED_URL"
            value: "/ut_saved_url"
          - name: "infer_dataset_url"
            value: "/data/testData.csv"
          volumeMounts:
          - name: utdir
            mountPath: /ut_saved_url
          - name: inferdata
            mountPath: /data/
          resources:
            limits:
              memory: 2Gi
        volumes:
          - name: utdir
            hostPath:
              path: /lifelong/unseen_task/
              type: DirectoryOrCreate
          - name: inferdata
            hostPath:
              path:  /data/
              type: DirectoryOrCreate
  outputDir: "/output"
CRD
CRD可以看作是CR的模板,在k8s叢集能建立對應CR之前需要將對應的CRD在k8s叢集中進行宣告。CRD對應的yaml檔案可以手動編寫或自動生成,對於一些相對複雜的CRD定義建議採用透過k8s相關工具生成。比如Sedna這裡使用的是kubebuilder的controller-gen進行自動生成與更新,Sedna專案提供了封裝好的指令碼,直接透過make crds命令即可生成和更新對應build/crds/目錄下的CRD檔案。相關shell指令碼可以參考這個檔案Makefile中的crds: controller-gen。
想要完成一個CRD定義,最重要的是需要指定group、version和kind,通常簡稱為GVK。而CR資源物件本身稱為Resource,相較於物件導向中的概念,Resouce類比為Object,Kind類比於Class,也就可以說Resource是Kind的實例。下表展示了終身學習CRD和CR對應的GVR和GVK:
| Group | Version | Resource | Kind | |
|---|---|---|---|---|
| CRD | apiextensions.k8s.io | v1 | lifelonglearningjobs.sedna.io | CustomResourceDefinition |
| CR | sedna.io | v1alpha1 | lifelonglearningjob | LifelongLearningJob |
在K8S叢集中資源是以REST URI的形式來組織的,組織的路徑如下:
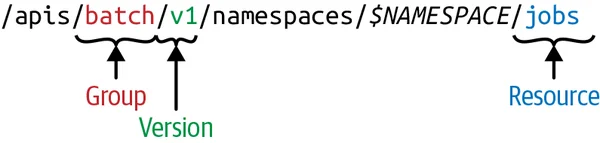
瞭解了上述的規則後,我們可以快速的拼接好要管理的k8s資源物件的REST URI地址,這為某些不能依賴k8s client(kubectl, client-go等)的情況下訪問叢集資源提供了簡便的方式。比如:
透過Rest介面檢視終身學習CRD描述:
curl -k --cert ./client.crt --key ./client.key https://127.0.0.1:5443/apis/apiextensions.k8s.io/v1beta1/customresourcedefinitions/lifelonglearningjobs.sedna.io透過Rest介面檢視終身學習CR列表:
curl -k --cert ./client.crt --key ./client.key https://127.0.0.1:5443/apis/sedna.io/v1alpha1/lifelonglearningjobs比如如果某些程式語言沒有官方的k8s client SDK, 那麼可以統一採用如上Rest介面形式進行封裝。
下面是Sedna 終身學習CRD定義,一些需要關注的欄位如下:
apiVersion: apiextensions.k8s.io/v1,當前所有的CRD都擴展自apiextensions.k8s.io/v1這個Version。kind: CustomResourceDefinition,當前所有的CRD都繼承自CustomResourceDefinition這個Kind。spec.group: sedna.io,自定義資源的Group名稱為sedna.io。spec.names.kind: LifelongLearningJob, 自定義資源新增加的型別,這裡是LifelongLearningJob。spec.names.shortNames: - ll,在使用kubectl可以使用這個縮寫”ll“查詢到LifelongLearningJob資源。
build/crds/sedna.io_lifelonglearningjobs.yaml
apiVersion: apiextensions.k8s.io/v1
kind: CustomResourceDefinition
metadata:
  annotations:
    controller-gen.kubebuilder.io/version: v0.4.1
  creationTimestamp: null
  name: lifelonglearningjobs.sedna.io
spec:
  group: sedna.io
  names:
    kind: LifelongLearningJob
    listKind: LifelongLearningJobList
    plural: lifelonglearningjobs
    shortNames:
    - ll
    singular: lifelonglearningjob
  scope: Namespaced
  versions:
  - name: v1alpha1
...
status:
  acceptedNames:
    kind: ""
    plural: ""
  conditions: []
  storedVersions: []
API
上面提到我們的CRD是自動生成的,那生成這些CRD所需要的API基礎定義在哪裡呢?
pkg/apis/sedna/v1alpha1/lifelonglearningjob_types.go
package v1alpha1

import (
v1 "k8s.io/api/core/v1"
metav1 "k8s.io/apimachinery/pkg/apis/meta/v1"
)

// 这里展示了
// +genclient
// +k8s:deepcopy-gen:interfaces=k8s.io/apimachinery/pkg/runtime.Object
// +kubebuilder:resource:shortName=ll
// +kubebuilder:subresource:status

// 整体的LifelongLearningJob的API定义,主要包含Spec和Status定义,分别代表期望状态和实际状态。
type LifelongLearningJob struct {
metav1.TypeMeta   `json:",inline"`
metav1.ObjectMeta `json:"metadata"`
Spec              LLJobSpec   `json:"spec"`
Status            LLJobStatus `json:"status,omitempty"`
}

// 在创建LifelongLearningJob时候需要配置的参数;如果需要扩展终身学习字段的接口,可以在这里修改。
type LLJobSpec struct {
Dataset    LLDataset    `json:"dataset"`
TrainSpec  LLTrainSpec  `json:"trainSpec"`
EvalSpec   LLEvalSpec   `json:"evalSpec"`
DeploySpec LLDeploySpec `json:"deploySpec"`

// the credential referer for OutputDir
CredentialName string `json:"credentialName,omitempty"`
OutputDir      string `json:"outputDir"`
}

type LLDataset struct {
Name      string  `json:"name"`
TrainProb float64 `json:"trainProb"`
}

// 剩下还有一些结构体定义省略了。
上面的程式碼片段中,補充了額外的說明,需要注意的有如下幾點:
// +kubebuilder...:註釋是給kubebuilder等程式碼自動生成工具的配置參數,會被這些工具解析。type LifelongLearningJob struct{...}:定義了終身學習CRD整體API,主要包含Spec和Status定義,分別代表期望狀態和實際狀態。type LLJobSpec struct {...}:在建立LifelongLearningJob CR時需要配置的參數;如果需要擴展終身學習欄位的介面,可以在這裡修改。
其他協同推理、增量學習、聯邦學習相關的API定義都可以在pkg/apis/sedna/v1alpha1/這個目錄下找到。
更新client-go程式碼
一旦新增或者更新了*_types.go中的定義,則需要執行如下命令進行client-go程式碼更新:
bash hack/update-codegen.sh生成的程式碼位於pkg/client:
➜  pkg tree client -L 2
client
├── clientset
│   └── versioned
├── informers
│   └── externalversions
└── listers
    └── sedna
client-go中的程式碼會在後面的Contrller邏輯中用到。
更新CRD定義
一旦新增或者更新了*_types.go中的定義,則需要執行如下命令進行CRD程式碼更新:
make crds生成的CRD定義yaml檔案位於build/crds。更新這些定義之後,也需要同步在K8s叢集中重新kubectl apply一下,以將新的CRD在叢集中生效。
Controller
終身學習最主要的控制邏輯在這個pkg/globalmanager/controllers/lifelonglearning/lifelonglearningjob.go檔案裡面,包括訓練評估Worker什麼時候觸發、Worker參數如何同步到邊緣等。
在進入到終身學習的控制邏輯之前,整體的呼叫流程可以參考下面虛擬碼:
cmd/sedna-gm/sedna-gm.go/main() 【1】
pkg/globalmanager/controllers/manager.go/New() 【2】读取GM配置文件。
pkg/globalmanager/controllers/manager.go/Start() 【3】启动GM进程。
    - clientset.NewForConfig():【4】调用client-go生成了Sedna CRD client。
    - NewUpstreamController():【5】创建UpstreamController,每个GM进程有一个UpstreamController
    - uc.Run(stopCh):启动一个for循环协程,来处理
        - pkg/globalmanager/controllers/upstream.go/syncEdgeUpdate()
    - NewRegistry():【6】注册所有controller。
        - f.SetDownstreamSendFunc()【7】
            -> pkg/globalmanager/controllers/lifelonglearning/downstream.go
        - f.SetUpstreamHandler()【8】
            -> pkg/globalmanager/controllers/lifelonglearning/upstream.go/updateFromEdge()
        - f.Run()【9】
    - ws.ListenAndServe() 【10】
下面為了講解Sedna LifelongLeraningJob Controller的控制邏輯,也按照上面1~10的標號來講解:
【1】main函式入口
sedna-gm.go是GM模組的啟動入口,主要包括日誌初始化配置、app.NewControllerCommand()中執行了參數的解析、啟動GM對應的controller。
cmd/sedna-gm/sedna-gm.go
func main() {
   rand.Seed(time.Now().UnixNano())

   command := app.NewControllerCommand()
   logs.InitLogs()
   defer logs.FlushLogs()

   if err := command.Execute(); err != nil {
      os.Exit(1)
   }
}
【2】GM系統配置載入
GM載入系統配置,包括K8S叢集配置、啟動監聽的Websocket地址埠、KB服務的地址等。
pkg/globalmanager/controllers/manager.go
// New creates the controller manager
func New(cc *config.ControllerConfig) *Manager {
   config.InitConfigure(cc)
   return &Manager{
      Config: cc,
   }
}
pkg/globalmanager/config/config.go
// ControllerConfig indicates the config of controller
type ControllerConfig struct {
   // KubeAPIConfig indicates the kubernetes cluster info which controller will connected
   KubeConfig string `json:"kubeConfig,omitempty"`

   // Master indicates the address of the Kubernetes API server. Overrides any value in KubeConfig.
   // such as https://127.0.0.1:8443
   // default ""
   Master string `json:"master"`
   // Namespace indicates which namespace the controller listening to.
   // default ""
   Namespace string `json:"namespace,omitempty"`

   // websocket server config
   // Since the current limit of kubeedge(1.5), GM needs to build the websocket channel for communicating between GM and LCs.
   WebSocket WebSocket `json:"websocket,omitempty"`

   // lc config to info the worker
   LC LCConfig `json:"localController,omitempty"`

   // kb config to info the worker
   KB KBConfig `json:"knowledgeBaseServer,omitempty"`

   // period config min resync period
   // default 30s
   MinResyncPeriodSeconds int64 `json:"minResyncPeriodSeconds,omitempty"`
}
【3】GM整體初始化
GM整體初始化的步驟如下,包括初始化Sedna CRD client、繫結並啟動邊雲訊息通訊處理函式、啟動各個特定對應的controller、啟動websock開始監聽訊息。
pkg/globalmanager/controllers/manager.go
// Start starts the controllers it has managed
func (m *Manager) Start() error {
   ...
   // 初始化Sedna CRD client,Controller会监听Sedna CR 增删改查的变化,并执行对应的处理逻辑。
   sednaClient, err := clientset.NewForConfig(kubecfg)

   ...
   sednaInformerFactory := sednainformers.NewSharedInformerFactoryWithOptions(sednaClient, genResyncPeriod(minResyncPeriod), sednainformers.WithNamespace(namespace))

   // 初始化UpstreamController,用于处理边缘LC上传的消息
   uc, _ := NewUpstreamController(context)
   downstreamSendFunc := messagelayer.NewContextMessageLayer().SendResourceObject
   stopCh := make(chan struct{})
   go uc.Run(stopCh)

   // 针对每个特性(协同推理、终身学习等),绑定对应的消息处理函数
   for name, factory := range NewRegistry() {
      ...
      f.SetDownstreamSendFunc(downstreamSendFunc)
      f.SetUpstreamHandler(uc.Add)
      ...
      // 启动各个特性对应controller
      go f.Run(stopCh)
   }

   ...

   // 启动整体GM的websocket,默认监听在0.0.0.0:9000这个端口地址
   ws := websocket.NewServer(addr)
   ...
}
【4】CRD client初始化
clientset.NewForConfig()呼叫的原始函式位於pkg/client/clientset/versioned/clientset.go,前面提到這裡是由client-go工具根據Sedna CRD定義自動生成的程式碼,透過go語言呼叫CRD定義的資源物件的增刪改查。
下面程式碼是LifelongLearningJob Controller初始化的函式,其中就依賴client-go生成的CRD client程式碼。主要做了這麼幾件事:
- 獲取LifelongLearningJob的Informer。Informer可以看作是controller的K8S api-server的”本地快取“,用來減少api-server的資料讀取壓力。
- 配置LifelongLearningJob Controller的參數或成員變數,包括k8s client、sedna client、GM controller通用配置。
- 繫結LifelongLearningJob CRD資源的Add、Update、Delete對應事件的回撥函式。
pkg/globalmanager/controllers/lifelonglearning/lifelonglearningjob.go
// New creates a new LifelongLearningJob controller that keeps the relevant pods
// in sync with their corresponding LifelongLearningJob objects.
func New(cc *runtime.ControllerContext) (runtime.FeatureControllerI, error) {
   cfg := cc.Config

   podInformer := cc.KubeInformerFactory.Core().V1().Pods()

   // 获取LifelongLearningJob的Informer
   jobInformer := cc.SednaInformerFactory.Sedna().V1alpha1().LifelongLearningJobs()

   eventBroadcaster := record.NewBroadcaster()
   eventBroadcaster.StartRecordingToSink(&v1core.EventSinkImpl{Interface: cc.KubeClient.CoreV1().Events("")})

   // 配置LifelongLearningJob Controller的参数
   jc := &Controller{
      kubeClient: cc.KubeClient,
      client:     cc.SednaClient.SednaV1alpha1(),
      queue:      workqueue.NewNamedRateLimitingQueue(workqueue.NewItemExponentialFailureRateLimiter(runtime.DefaultBackOff, runtime.MaxBackOff), Name),
      cfg:        cfg,
   }

   // 绑定LifelongLearningJob CRD资源的Add、Update、Delete对应事件的回调函数。
   jobInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
      AddFunc: func(obj interface{}) {
         jc.enqueueController(obj, true)
         jc.syncToEdge(watch.Added, obj)
      },
      UpdateFunc: func(old, cur interface{}) {
         jc.enqueueController(cur, true)
         jc.syncToEdge(watch.Added, cur)
      },
      DeleteFunc: func(obj interface{}) {
         jc.enqueueController(obj, true)
         jc.syncToEdge(watch.Deleted, obj)
      },
   })
   jc.jobLister = jobInformer.Lister()
   jc.jobStoreSynced = jobInformer.Informer().HasSynced

   // 绑定Pod对应的增删改对应事件的回调函数。
   podInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
      AddFunc:    jc.addPod,
      UpdateFunc: jc.updatePod,
      DeleteFunc: jc.deletePod,
   })
   jc.podStore = podInformer.Lister()
   jc.podStoreSynced = podInformer.Informer().HasSynced

   return jc, nil
}
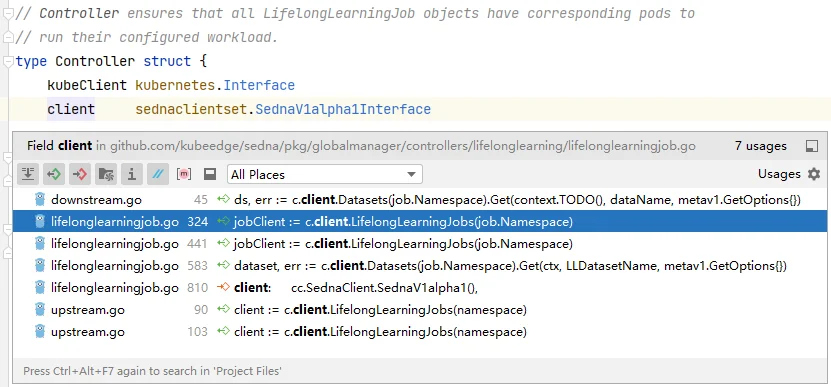
下面截圖也展示了Sedna CRD client在其他模組的一些引用。
【5】訊息處理初始化
uc.Run()裡面會初始化UpstreamController,UpstreamController用來處理邊緣傳送過來的所有訊息。
for迴圈持續的監聽context.upstreamChannel, 一旦有訊息則透過uc.updateHandlers[kind]根據kind型別獲取對應的handler,並呼叫此handler回撥函式進行訊息處理。uc.updateHandlers是一個map,裡面儲存了協同推理、增量學習、聯邦學習、終身學習對應的updateHandlers.
pkg/globalmanager/controllers/upstream.go
// syncEdgeUpdate receives the updates from edge and syncs these to k8s.
func (uc *UpstreamController) syncEdgeUpdate() {
   for {
      select {
      case <-uc.messageLayer.Done():
         klog.Info("Stop sedna upstream loop")
         return
      default:
      }

      update, err := uc.messageLayer.ReceiveResourceUpdate()
  ...

      handler, ok := uc.updateHandlers[kind]
      if ok {
         err := handler(name, namespace, operation, update.Content)
         ...
      }
   }
}ReceiveFromEdge提供一個阻塞的通道,來接收來自邊緣節點LC傳送的訊息,訊息的型別為nodeMessage。
pkg/globalmanager/messagelayer/ws/context.go
// ReceiveResourceUpdate receives and handles the update
func (cml *ContextMessageLayer) ReceiveResourceUpdate() (*ResourceUpdateSpec, error) {
   nodeName, msg, err := wsContext.ReceiveFromEdge()
   ...
}
【6】Controller註冊
NewRegistry()函式註冊了所有特性初始化函式,如果想擴展新的邊雲協同特性,需要在這裡新增對應的New函式。
pkg/globalmanager/controllers/registry.go
func NewRegistry() Registry {
   return Registry{
      ji.Name:      ji.New,
      fe.Name:      fe.New,
      fl.Name:      fl.New,
      il.Name:      il.New,
      ll.Name:      ll.New,
      reid.Name:    reid.New,
      va.Name:      va.New,
      dataset.Name: dataset.New,
      objs.Name:    objs.New,
   }
}
【7】雲端訊息同步到邊緣
f.SetDownstreamSendFunc()繫結了各個特性對應的邊緣同步訊息函式syncToEdge()。
對於終身學習來說,其同步訊息的步驟主要包括:
- 獲取到對應的資料集指定的節點,Dataset CRD物件中有一個欄位記錄了Node名稱)。
- 獲取到訓練、評估、部署對應的節點名稱,這些名稱基於Annotation記錄。
- 根據LifelongLearningJob所處訓練、評估、部署階段不同,傳送訊息到不同的節點上。
pkg/globalmanager/controllers/lifelonglearning/downstream.go
func (c *Controller) syncToEdge(eventType watch.EventType, obj interface{}) error {

   // 获取到对应的数据集指定的节点(Dataset CRD对象中有一个字段记录了Node名称)
   ds, err := c.client.Datasets(job.Namespace).Get(context.TODO(), dataName, metav1.GetOptions{})

   // 获取到训练、评估、部署对应的节点名称
   getAnnotationsNodeName := func(nodeName sednav1.LLJobStage) string {
      return runtime.AnnotationsKeyPrefix + string(nodeName)
   }
   ann := job.GetAnnotations()
   if ann != nil {
      trainNodeName = ann[getAnnotationsNodeName(sednav1.LLJobTrain)]
      evalNodeName = ann[getAnnotationsNodeName(sednav1.LLJobEval)]
      deployNodeName = ann[getAnnotationsNodeName(sednav1.LLJobDeploy)]
   }

   ...

   // 根据LifelongLearningJob所处阶段不同,发送消息到不同的节点上
   switch jobStage {
   case sednav1.LLJobTrain:
      doJobStageEvent(trainNodeName)
   case sednav1.LLJobEval:
      doJobStageEvent(evalNodeName)
   case sednav1.LLJobDeploy:
      doJobStageEvent(deployNodeName)
   }

   return nil
}
【8】邊緣訊息同步到雲端
f.SetUpstreamHandler() 繫結了各個特性對應的雲端訊息訊息同步函式updateFromEdge()。
對於終身學習來說,其同步訊息主要做了幾件事:
- 根據不同的邊緣節點任務完成情況,變更當前LifelongLearningJob的整體狀態。
- 將當前LifelongLearningJob的整體狀態寫回k8s,也就是LifelongLearningJob這個CR的Status欄位。
- 解析邊緣訊息結構體,當前是以json的形式定義的,訊息體示例如下:
GM接收到的訊息體示例:
{
    "phase": "train",
    "status": "completed",
    "output": {
        "models": [{
            "classes":  ["road", "fence"],
            "current_metric": null,
            "format": "pkl",
            "metrics": null,
            "url": "/output/train/1/index.pkl"
        }],
        "ownerInfo": null
    }
}
pkg/globalmanager/controllers/lifelonglearning/upstream.go
// updateFromEdge syncs the edge updates to k8s
func (c *Controller) updateFromEdge(name, namespace, operation string, content []byte) error {
   var jobStatus struct {
      Phase  string `json:"phase"`
      Status string `json:"status"`
   }

   // 把边缘消息结构体进行解析。
   err := json.Unmarshal(content, &jobStatus)
   ...
   cond := sednav1.LLJobCondition{
      Status:             v1.ConditionTrue,
      LastHeartbeatTime:  metav1.Now(),
      LastTransitionTime: metav1.Now(),
      Data:               string(condDataBytes),
      Message:            "reported by lc",
   }

   // 根据不同的边缘节点任务状态实现,变更当前LifelongLearningJob的整体状态
   switch strings.ToLower(jobStatus.Status) {
   case "ready":
      cond.Type = sednav1.LLJobStageCondReady
   case "completed":
      cond.Type = sednav1.LLJobStageCondCompleted
   case "failed":
      cond.Type = sednav1.LLJobStageCondFailed
   case "waiting":
      cond.Type = sednav1.LLJobStageCondWaiting
   default:
      return fmt.Errorf("invalid condition type: %v", jobStatus.Status)
   }

   // 将当前LifelongLearningJob的整体状态写回k8s,也就是LifelongLearningJob这个CR的Status字段。
   err = c.appendStatusCondition(name, namespace, cond)
   ...
}
【9】Controller核心處理邏輯
f.run()會呼叫各個特性對應Controller的處理函式,下面是LifelongLearningJob的run()函式。
先會透過WaitForNamedCacheSync去等待Pod和LifelongLearningJob資源物件是否已經同步到Informer中。如果已經同步,則會啟動指定數量的worker對LifelongLearningJob進行處理。
pkg/globalmanager/controllers/lifelonglearning/lifelonglearningjob.go
// Run starts the main goroutine responsible for watching and syncing jobs.
func (c *Controller) Run(stopCh <-chan struct{}) {
   workers := 1

   defer utilruntime.HandleCrash()
   defer c.queue.ShutDown()

   klog.Infof("Starting %s controller", Name)
   defer klog.Infof("Shutting down %s controller", Name)

   if !cache.WaitForNamedCacheSync(Name, stopCh, c.podStoreSynced, c.jobStoreSynced) {
      klog.Errorf("failed to wait for %s caches to sync", Name)

      return
   }
   klog.Infof("Starting %s workers", Name)
   for i := 0; i < workers; i++ {
      go wait.Until(c.worker, time.Second, stopCh)
   }

   <-stopCh
}在c.worker方法中,會呼叫processNextWorkItem()去處理對應的LifelongLearningJob資源物件,
pkg/globalmanager/controllers/lifelonglearning/lifelonglearningjob.go
// worker runs a worker thread that just dequeues items, processes them, and marks them done.
// It enforces that the syncHandler is never invoked concurrently with the same key.
func (c *Controller) worker() {
   for c.processNextWorkItem() {
   }
}c.processNextWorkItem()會呼叫c.sync()函式來處理特性相關的邏輯。
pkg/globalmanager/controllers/lifelonglearning/lifelonglearningjob.go
func (c *Controller) sync(key string) (bool, error) {
   //省略了部分代码
   ns, name, err := cache.SplitMetaNamespaceKey(key)

   sharedJob, err := c.jobLister.LifelongLearningJobs(ns).Get(name)

   // if job was finished previously, we don't want to redo the termination
   if IsJobFinished(&job) {
      return true, nil
   }

   // transit this job's state machine
   needUpdated, err = c.transitJobState(&job)


   if needUpdated {
      if err := c.updateJobStatus(&job); err != nil {
         return forget, err
      }

      if jobFailed && !IsJobFinished(&job) {
         // returning an error will re-enqueue LifelongLearningJob after the backoff period
         return forget, fmt.Errorf("failed pod(s) detected for lifelonglearningjob key %q", key)
      }

      forget = true
   }

   return forget, err
}
sync是對具體的LifelongLearningJob進行邏輯處理了,主要做了這麼幾件事:
- 透過
SplitMetaNamespaceKey將LifelongLearningJob的key切分為namespace和name。 - 透過
c.jobLister獲取LifelongLearningJob的資源物件。 - 透過
transitJobState來分析當前job應該進入到訓練、評估、部署階段了。 - 如果LifelongLearningJob的Status更新了,那麼需要透過
c.updateJobStatus()寫回k8s資源物件中,這樣透過kubectl查詢到的就是最新的狀態了,比如說當前在評估階段、生成的模型路徑在哪裡等資訊。 - 任務失敗等異常處理。
// transit this job's state machine
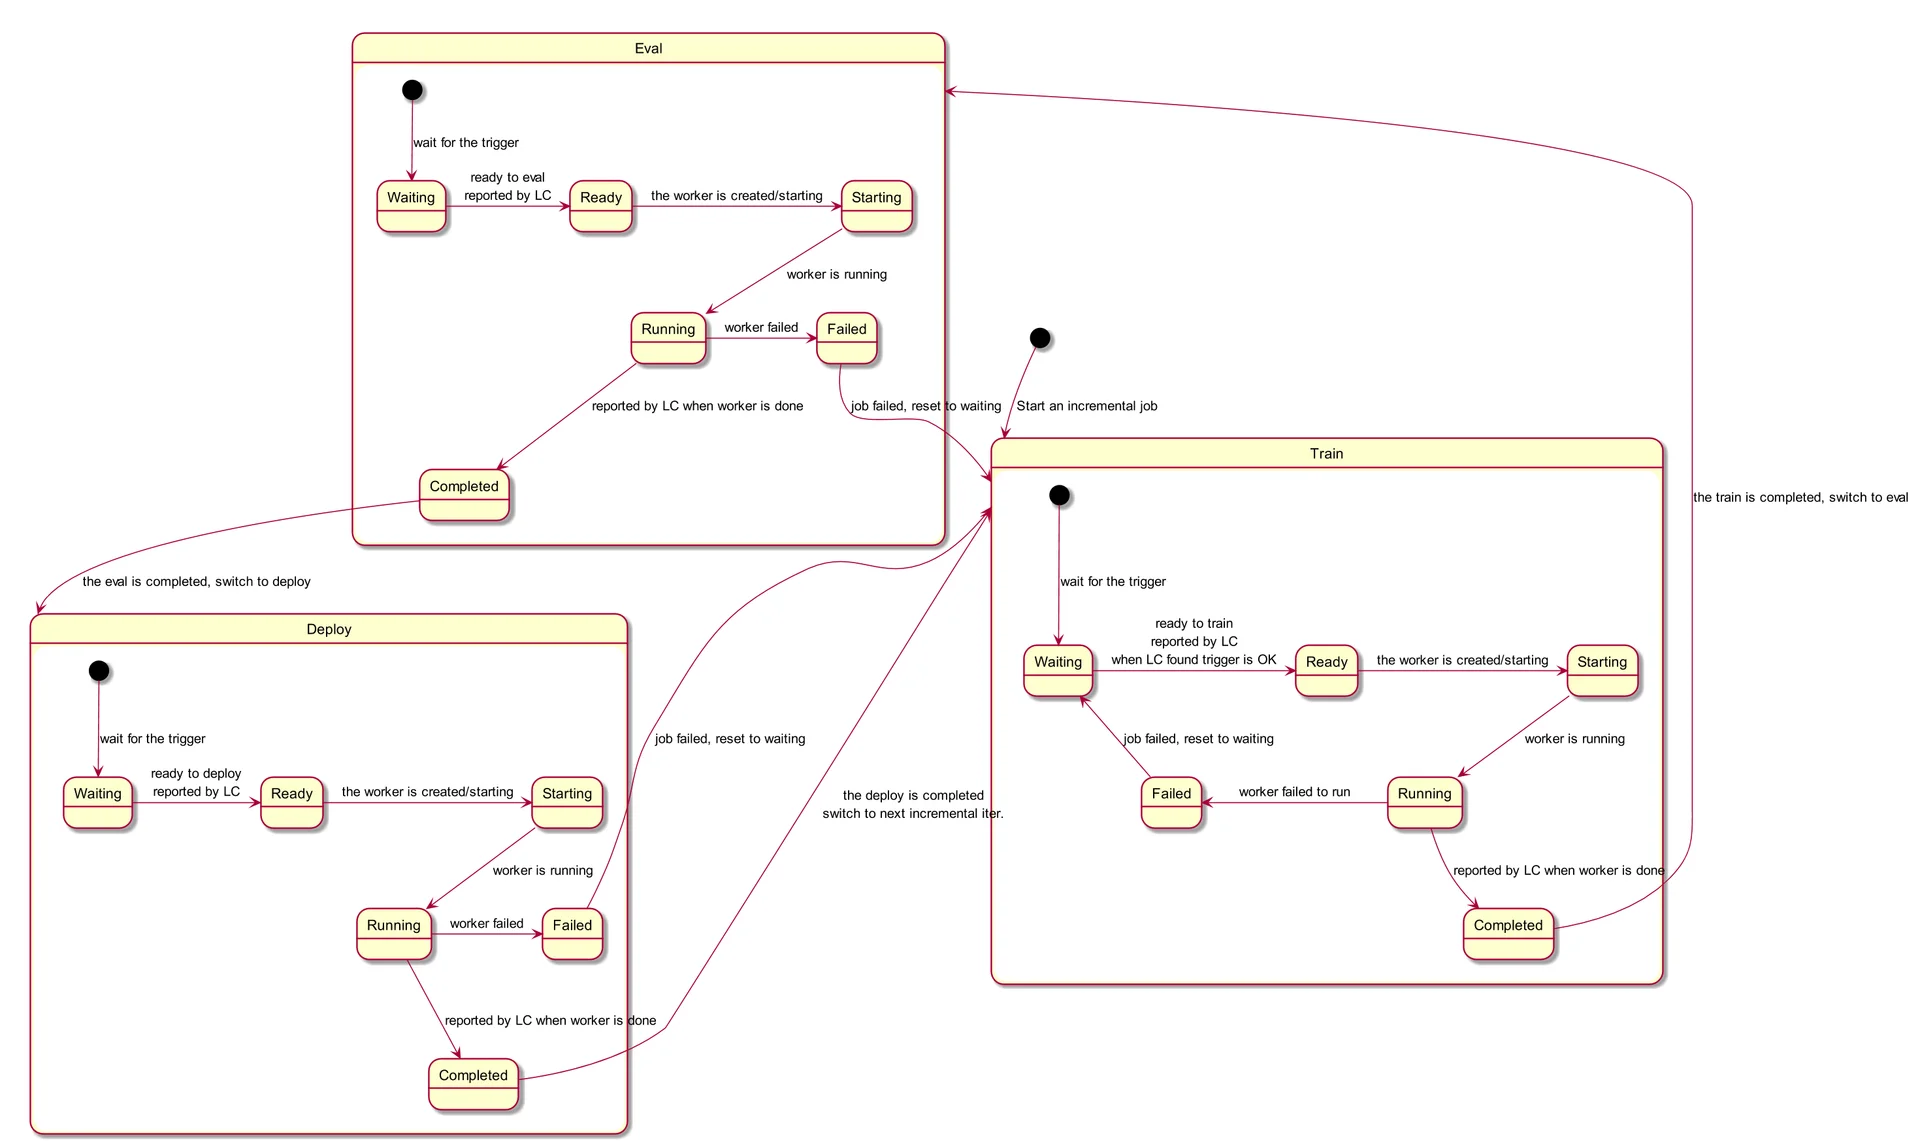
needUpdated, err = c.transitJobState(&job)其中transitJobState()是終身學習任務流轉的核心邏輯,包括訓練、評估、部署分別在什麼時候啟動、停止等的控制,詳細流轉邏輯可以結合下圖對應的狀態流轉圖進行分析。
【10】websocket監聽啟動
啟動一個websocket地址,用於接收【8】中提到的邊側傳過來的訊息,預設啟動的IP埠是0.0.0.0:9000。
pkg/globalmanager/controllers/manager.go
addr := fmt.Sprintf("%s:%d", m.Config.WebSocket.Address, m.Config.WebSocket.Port)

ws := websocket.NewServer(addr)
err = ws.ListenAndServe()
LC: Local Controller
LC是部署在邊緣節點,主要負責本地的任務管理和訊息代理。LC入口函式在cmd/sedna-lc/sedna-lc.go,相關入口分析可以參考GM章節。下面這裡貼一下本地任務管理註冊的函式入口:
cmd/sedna-lc/app/server.go
// runServer runs server
func runServer() {
   c := gmclient.NewWebSocketClient(Options)
   if err := c.Start(); err != nil {
      return
   }

   dm := dataset.New(c, Options)
   mm := model.New(c)
   jm := jointinference.New(c)
   fm := federatedlearning.New(c)
   im := incrementallearning.New(c, dm, mm, Options)
   lm := lifelonglearning.New(c, dm, Options)
   s := server.New(Options)

   for _, m := range []managers.FeatureManager{
      dm, mm, jm, fm, im, lm,
   } {
      s.AddFeatureManager(m)
      c.Subscribe(m)
      err := m.Start()
      if err != nil {
         klog.Errorf("failed to start manager %s: %v",
            m.GetName(), err)
         return
      }
      klog.Infof("manager %s is started", m.GetName())
   }

   s.ListenAndServe()
}
本地任務管理
Manager這個物件負責了在邊緣的任務管理,下面是其資料結構定義:
pkg/localcontroller/managers/lifelonglearning/lifelonglearningjob.go
// LifelongLearningJobManager defines lifelong-learning-job Manager
type Manager struct {
   Client                 clienttypes.ClientI
   WorkerMessageChannel   chan workertypes.MessageContent
   DatasetManager         *dataset.Manager
   LifelongLearningJobMap map[string]*Job
   VolumeMountPrefix      string
}主要的管理流程可以參考如下startJob()程式碼,其中主要:
- 監控並處理同步到邊緣的Dataset物件,比如監聽資料集樣本數量是否達到閾值,達到則啟動訓練。
- 根據當前任務不同階段,觸發不同階段的訓練、評估、部署任務。本地不直接起任務,而是把對應的狀態上報到GM,由GM統一排程來啟動對應的訓練、評估、部署任務。
pkg/localcontroller/managers/lifelonglearning/lifelonglearningjob.go
// startJob starts a job
func (lm *Manager) startJob(name string) {
   ...

   // 监控并处理同步到边缘的Dataset对象。
   go lm.handleData(job)

   tick := time.NewTicker(JobIterationIntervalSeconds * time.Second)
   for {
      // 根据当前任务不同阶段,触发不同阶段的训练、评估、部署任务。
      select {
      case <-job.JobConfig.Done:
         return
      case <-tick.C:
         cond := lm.getLatestCondition(job)
         jobStage := cond.Stage

         switch jobStage {
         case sednav1.LLJobTrain:
            err = lm.trainTask(job)
         case sednav1.LLJobEval:
            err = lm.evalTask(job)

         case sednav1.LLJobDeploy:
            err = lm.deployTask(job)
         default:
            klog.Errorf("invalid phase: %s", jobStage)
            continue
         }
 ...
      }
   }
}
除了整體的任務流程管理,其他功能還包括資料集的監控、模型的下載、任務本地資料庫備份等功能。
訊息代理
LC除了把狀態變化的訊息往雲端傳之外,還會在本地0.0.0.0:9100埠啟動一個HTTP Server,用來接收把Lib庫傳輸過來的訊息整合並統一傳輸給GM,起到訊息代理的作用。下面是註冊的rest介面路由和訊息處理函式。
pkg/localcontroller/server/server.go
// register registers api
func (s *Server) register(container *restful.Container) {
ws := new(restful.WebService)
ws.Path(fmt.Sprintf("/%s", constants.ServerRootPath)).
Consumes(restful.MIME_XML, restful.MIME_JSON).
Produces(restful.MIME_JSON, restful.MIME_XML)

ws.Route(ws.POST("/workers/{worker-name}/info").
To(s.messageHandler).
Doc("receive worker message"))
container.Add(ws)
}
pkg/localcontroller/server/server.go
// messageHandler handles message from the worker
func (s *Server) messageHandler(request *restful.Request, response *restful.Response) {
   var err error
   workerName := request.PathParameter("worker-name")
   workerMessage := workertypes.MessageContent{}

   err = request.ReadEntity(&workerMessage)
   if workerMessage.Name != workerName || err != nil {
      var msg string
      if workerMessage.Name != workerName {
         msg = fmt.Sprintf("worker name(name=%s) in the api is different from that(name=%s) in the message body",
            workerName, workerMessage.Name)
      } else {
         msg = fmt.Sprintf("read worker(name=%s) message body failed, error: %v", workerName, err)
      }

      klog.Errorf(msg)
      err = s.reply(response, http.StatusBadRequest, msg)
      if err != nil {
         klog.Errorf("reply messge to worker(name=%s) failed, error: %v", workerName, err)
      }
   }

   if m, ok := s.fmm[workerMessage.OwnerKind]; ok {
      m.AddWorkerMessage(workerMessage)
   }

   err = s.reply(response, http.StatusOK, "OK")
   if err != nil {
      klog.Errorf("reply message to worker(name=%s) failed, error: %v", workerName, err)
      return
   }
}
Sedna Lib原始碼解析(Python)
Lib是面向AI開發者和應用開發者的Python 庫,方便開發者把自己已有的程式碼改造成邊雲協同的。
下面是Lib的工程目錄結構:
➜  sedna tree lib -L 2
lib
├── __init__.py
├── MANIFEST.in
├── OWNERS
├── requirements.dev.txt
├── requirements.txt    // Sedna Python的依赖
├── sedna
│   ├── algorithms  // 边云协同算法
│   ├── backend     // 支持的后端,tensorflow/pytorch
│   ├── common
│   ├── core        // 主要特性的实现逻辑
│   ├── datasources // 支持的数据源格式,比如txt、csv等
│   ├── __init__.py
│   ├── README.md
│   ├── service     // 需要启动server的组件,比如kb等
│   ├── VERSION
│   └── __version__.py
└── setup.py
下面摘取每個部分比較典型的程式碼進行分析講解。
core
core部分主要是封裝了使用者的回撥函式,比如下面的train,主要是回撥使用者封裝的tensorflow、pytorch、mindspore的train函式。
- 配置後處理函式。
- 呼叫雲端知識庫進行訓練、推理等。
- 更新雲端知識庫。在終身學習中,雲端知識庫用來儲存新的模型和樣本,會被不斷更新。
- 將當前訓練任務執行的情況傳送給LC,比如訓練任務是否完成、訓練後的指標是多少。
lib/sedna/core/lifelong_learning/lifelong_learning.py
def train(self, train_data,
          valid_data=None,
          post_process=None,
          **kwargs):
    is_completed_initilization = \
        str(Context.get_parameters("HAS_COMPLETED_INITIAL_TRAINING",
                                   "false")).lower()

    if is_completed_initilization == "true":
        return self.update(train_data,
                           valid_data=valid_data,
                           post_process=post_process,
                           **kwargs)

    # 配置后处理函数
    callback_func = None
    if post_process is not None:
        callback_func = ClassFactory.get_cls(
            ClassType.CALLBACK, post_process)
    res, seen_task_index = \
        self.cloud_knowledge_management.seen_estimator.train(
            train_data=train_data,
            valid_data=valid_data,
            **kwargs
        )

    # 调用云端知识库进行训练、或推理
    unseen_res, unseen_task_index = \
        self.cloud_knowledge_management.unseen_estimator.train()

    # 更新云端知识库
    task_index = dict(
        seen_task=seen_task_index,
        unseen_task=unseen_task_index)
    task_index_url = FileOps.dump(
        task_index, self.cloud_knowledge_management.local_task_index_url)

    task_index = self.cloud_knowledge_management.update_kb(task_index_url)
    res.update(unseen_res)

    ...

    # 将当前训练任务执行的情况发送给LC,比如训练任务是否完成、训练后的指标是多少
    self.report_task_info(
            None, K8sResourceKindStatus.COMPLETED.value, task_info_res)
        self.log.info(f"Lifelong learning Train task Finished, "
                      f"KB index save in {task_index}")
        return callback_func(self.estimator, res) if callback_func else res

    ...
backend
MSBackend這裡定義了一種Sedna支援的後端框架Mindspore,如果對於某個框架定義好典型的train、predict、evaluate函式,那麼Sedna Lib 將能夠支援將其作為backend,能夠實現把現有AI程式碼進行簡單的封裝即可實現邊雲協同的能力。
lib/sedna/backend/mindspore/__init__.py
class MSBackend(BackendBase):
    def __init__(self, estimator, fine_tune=True, **kwargs):
        super(MSBackend, self).__init__(estimator=estimator,
                                        fine_tune=fine_tune,
                                        **kwargs)
        self.framework = "mindspore"
        if self.use_npu:
            context.set_context(mode=context.GRAPH_MODE,
                                device_target="Ascend")
        elif self.use_cuda:
            context.set_context(mode=context.GRAPH_MODE,
                                device_target="GPU")
        else:
            context.set_context(mode=context.GRAPH_MODE,
                                device_target="CPU")

        if callable(self.estimator):
            self.estimator = self.estimator()

    def train(self, train_data, valid_data=None, **kwargs):
        if callable(self.estimator):
            self.estimator = self.estimator()
        if self.fine_tune and FileOps.exists(self.model_save_path):
            self.finetune()
        self.has_load = True
        varkw = self.parse_kwargs(self.estimator.train, **kwargs)
        return self.estimator.train(train_data=train_data,
                                    valid_data=valid_data,
                                    **varkw)

    def predict(self, data, **kwargs):
        if not self.has_load:
            self.load()
        varkw = self.parse_kwargs(self.estimator.predict, **kwargs)
        return self.estimator.predict(data=data, **varkw)

    def evaluate(self, data, **kwargs):
        if not self.has_load:
            self.load()
        varkw = self.parse_kwargs(self.estimator.evaluate, **kwargs)
        return self.estimator.evaluate(data, **varkw)
datasource
datasource中封裝了常用的資料集格式處理函式,這樣就不需要透過
lib/sedna/datasources/__init__.py
class CSVDataParse(BaseDataSource, ABC):
    """
    csv file which contain Structured Data parser
    """
    # 提供了方便的数据集解析函数,
    def parse(self, *args, **kwargs):
        x_data = []
        y_data = []
        label = kwargs.pop("label") if "label" in kwargs else ""
        usecols = kwargs.get("usecols", "")
        if usecols and isinstance(usecols, str):
            usecols = usecols.split(",")
        if len(usecols):
            if label and label not in usecols:
                usecols.append(label)
            kwargs["usecols"] = usecols
        for f in args:
            if isinstance(f, (dict, list)):
                res = self.parse_json(f, **kwargs)
            else:
                if not (f and FileOps.exists(f)):
                    continue
                res = pd.read_csv(f, **kwargs)
            if self.process_func and callable(self.process_func):
                res = self.process_func(res)
            if label:
                if label not in res.columns:
                    continue
                y = res[label]
                y_data.append(y)
                res.drop(label, axis=1, inplace=True)
            x_data.append(res)
        if not x_data:
            return
        self.x = pd.concat(x_data)
        self.y = pd.concat(y_data)
algorithms
Sedna面向邊雲協同AI場景,需要有針對這種場景下的演算法。本身也整合了若干典型的難例識別演算法,比如下面的交叉熵閾值的演算法,能夠在邊側模型不自信的時候識別到對應的樣本。
Sedna不僅是為了整合這些基礎的演算法,更是為了支援邊雲協同框架下能擴展更多實用的演算法來最佳化邊雲整體訓練、推理效能。這才是Sedna Lib的這套框架所希望實現的。
lib/sedna/algorithms/hard_example_mining/hard_example_mining.py
@ClassFactory.register(ClassType.HEM, alias="CrossEntropy")
class CrossEntropyFilter(BaseFilter, abc.ABC):
    """
    **Object detection** Hard samples discovery methods named `CrossEntropy`

    Parameters
    ----------
    threshold_cross_entropy: float
        hard coefficient threshold score to filter img, default to 0.5.
    """

    def __init__(self, threshold_cross_entropy=0.5, **kwargs):
        self.threshold_cross_entropy = float(threshold_cross_entropy)

    def __call__(self, infer_result=None) -> bool:
        """judge the img is hard sample or not.

        Parameters
        ----------
        infer_result: array_like
            prediction classes list, such as
            [class1-score, class2-score, class2-score,....],
            where class-score is the score corresponding to the class,
            class-score value is in [0,1], who will be ignored if its
            value not in [0,1].

        Returns
        -------
        is hard sample: bool
            `True` means hard sample, `False` means not.
        """

        if not infer_result:
            # if invalid input, return False
            return False

        log_sum = 0.0
        data_check_list = [class_probability for class_probability
                           in infer_result
                           if self.data_check(class_probability)]

        if len(data_check_list) != len(infer_result):
            return False

        for class_data in data_check_list:
            log_sum += class_data * math.log(class_data)
        confidence_score = 1 + 1.0 * log_sum / math.log(
            len(infer_result))
        return confidence_score < self.threshold_cross_entropy