
Auteur original : jaypume
Cours d’origine : https://www.bilibili.com/video/BV1hg4y1b78L
Texte d’origine : https://github.com/jaypume/article/blob/main/sedna/边云协同AI框架Sedna源码解析/README.MD
Republié pour mon propre apprentissage, plus simple à relire.
Vue d’ensemble KubeEdge-Sedna
Sedna est un projet d’IA collaborative cloud–edge incubé dans KubeEdge SIG AI. Sur les capacités cloud–edge de KubeEdge, il fait de l’entraînement et de l’inférence collaboratifs : inférence conjointe, apprentissage incrémental, fédéré, lifelong, etc. Frameworks courants — TensorFlow / Pytorch / MindSpore — les applis IA existantes peuvent passer, et gagner sur le coût, la perf du modèle, la vie privée des data.
Projet :
https://github.com/kubeedge/sedna
Docs :
Architecture
La collab cloud–edge de Sedna s’appuie sur :
- Orchestration unifiée d’applis cloud–edge
- Router : canal de messages fiable côté plan de contrôle
- EdgeMesh : découverte de services et trafic data-plane
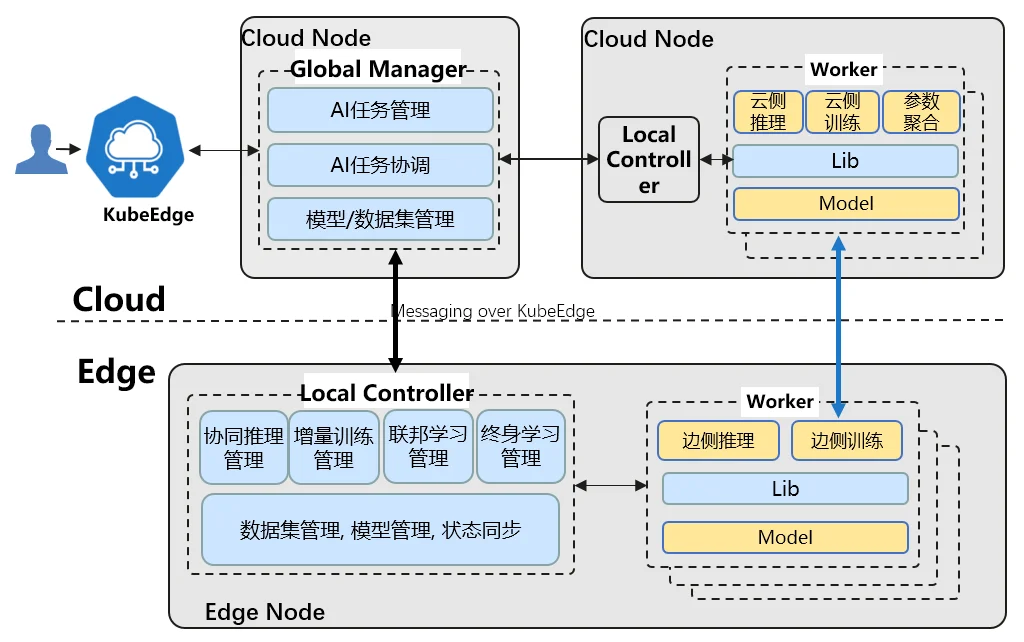
Composants :
- GlobalManager
- Gestion unifiée des jobs IA cloud–edge
- Coordination cross cloud–edge
- Config centrale
- LocalController
- Contrôle de flux local des jobs
- Gestion locale : modèles, datasets, sync de statut
- Lib
- Pour les devs IA / appli : exposer les features cloud–edge
- Worker
- Train ou infer, programmes sur les frameworks existants
- Un groupe de workers par feature ; edge ou cloud, et ils collaborent
Arborescence
| Dossier | Rôle |
|---|---|
| .github | CI/CD GitHub |
| LICENSES | Licences Sedna et vendors |
| build | Dockerfiles GM/LC ; yaml CRD générés ; samples |
| cmd | Entrées GM/LC |
| components | Monitoring et UI |
| docs | Proposals et install |
| examples | Inférence conjointe, incrémental, lifelong, fédéré |
| hack | Codegen et scripts dev |
| lib | Sedna Library, Python pour l’IA cloud–edge |
| pkg | API ; client-go généré ; cœur GM/LC |
| scripts | Install utilisateur |
| test | E2E et outils |
| vendor | Tiers |
Source du plan de contrôle Sedna (Go)
GM : Global Manager
GM, un operator K8S
C’est quoi un operator ?
An Operator is an application-specific controller that extends the Kubernetes API to create, configure and manage instances of complex stateful applications on behalf of a Kubernetes user. It builds upon the basic Kubernetes resource and controller concepts, but also includes domain or application-specific knowledge to automate common tasks better managed by computers. 1
Sedna pilote comment on configure et démarre les workers, comment ils collaborent, comment ça transite. Donc : Sedna GM est le contrôleur du domaine « applis IA collaboratives cloud–edge ».
The following components form the three main parts of an operator:
- API: The data that describes the operand’s configuration. The API includes:
- Custom resource definition (CRD), which defines a schema of settings available for configuring the operand.
- Programmatic API, which defines the same data schema as the CRD and is implemented using the operator’s programming language, such as Go.
- Custom resource (CR), which specifies values for the settings defined by the CRD; these values describe the configuration of an operand.
- Controller: The brains of the operator. The controller creates managed resources based on the description in the custom resource; controllers are implemented using the operator’s programming language, such as Go. 2
D’après Red Hat : CRD, API, CR, Controller.
Schéma de l’operator Sedna GM :
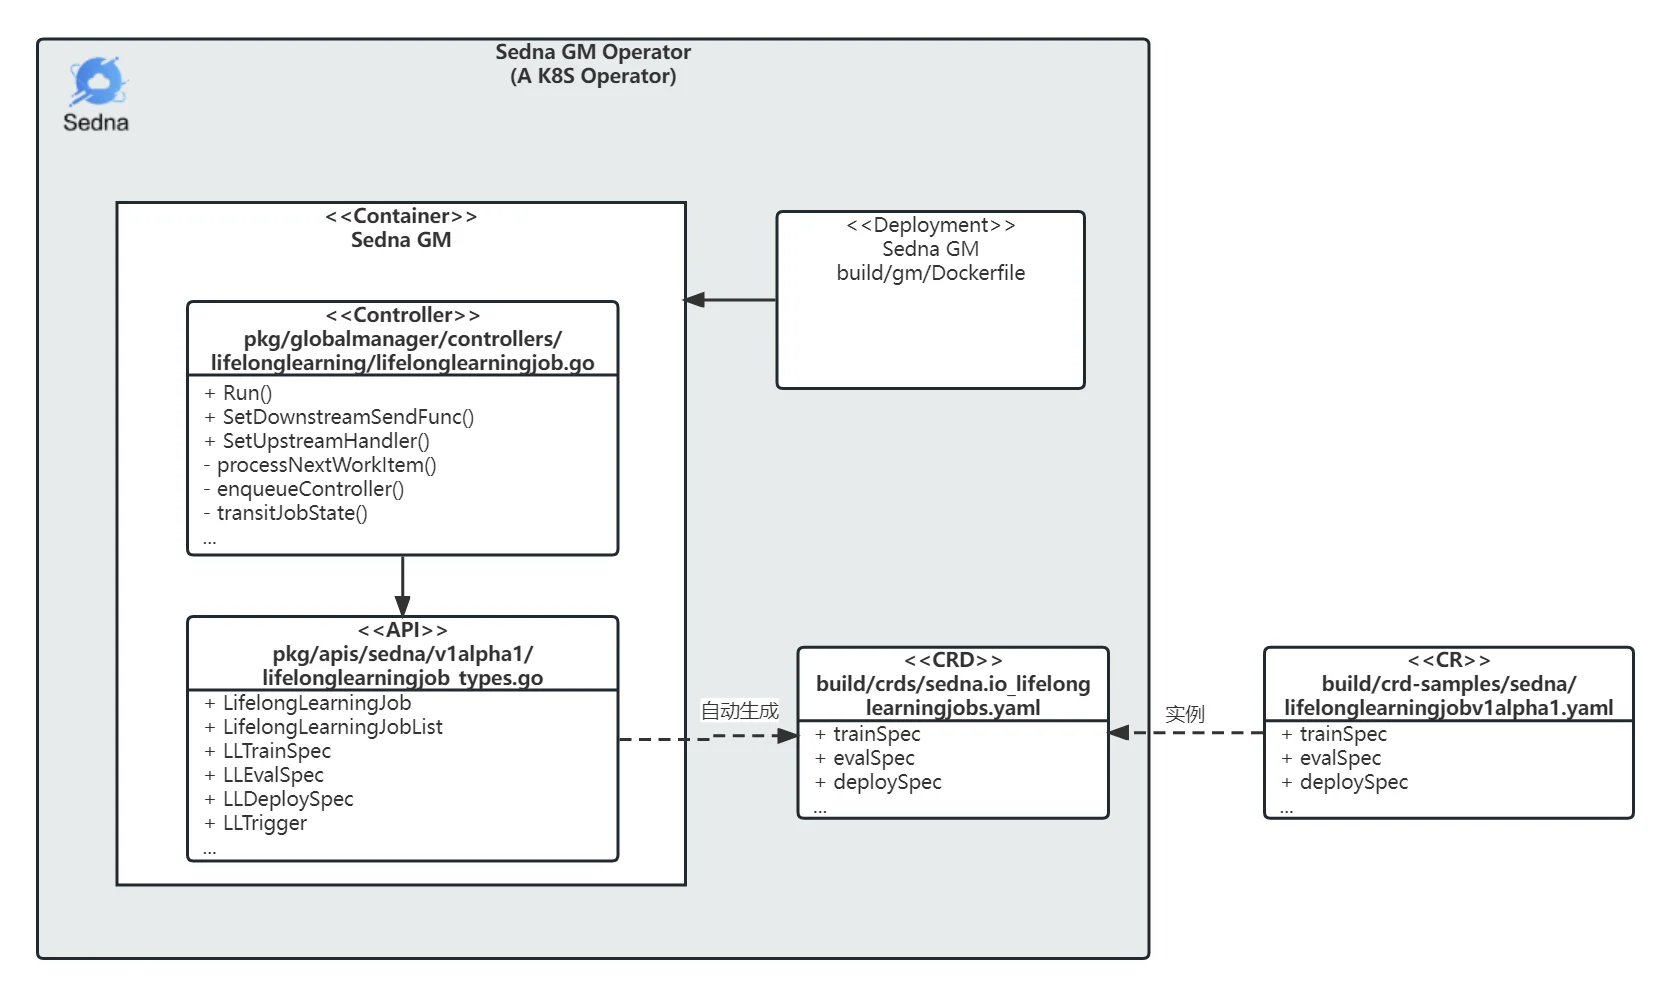
La suite suit ces pièces. Le Controller est la logique principale.
CR
Sedna gère inférence conjointe, incrémental, lifelong, fédéré. Pour lire le code, cet article prend le lifelong. Les trois autres se ressemblent.
Exemple de CR
Un échantillon CR lifelong. kubectl create dessus. Étapes ici. Champs :
- dataset : nom de l’objet dataset ; le dataset est aussi un CR.
- trainSpec : params du worker train — image, env, etc.
- trigger : quand démarrer le worker train.
- evalSpec : params du worker eval.
- deploySpec : params du worker infer.
- outputDir : chemin des modèles.
build/crd-samples/sedna/lifelonglearningjobv1alpha1.yaml
apiVersion: sedna.io/v1alpha1
kind: LifelongLearningJob
metadata:
  name: atcii-classifier-demo
spec:
  dataset:
    name: "lifelong-dataset"
    trainProb: 0.8
  trainSpec:
    template:
      spec:
        nodeName:  "edge-node"
        containers:
          - image: kubeedge/sedna-example-lifelong-learning-atcii-classifier:v0.3.0
            name:  train-worker
            imagePullPolicy: IfNotPresent
            args: ["train.py"]
            env:
              - name: "early_stopping_rounds"
                value: "100"
              - name: "metric_name"
                value: "mlogloss"
    trigger:
      checkPeriodSeconds: 60
      timer:
        start: 02:00
        end: 24:00
      condition:
        operator: ">"
        threshold: 500
        metric: num_of_samples
  evalSpec:
    template:
      spec:
        nodeName:  "edge-node"
        containers:
          - image: kubeedge/sedna-example-lifelong-learning-atcii-classifier:v0.3.0
            name:  eval-worker
            imagePullPolicy: IfNotPresent
            args: ["eval.py"]
            env:
              - name: "metrics"
                value: "precision_score"
              - name: "metric_param"
                value: "{'average': 'micro'}"
              - name: "model_threshold"
                value: "0.5"
  deploySpec:
    template:
      spec:
        nodeName:  "edge-node"
        containers:
        - image: kubeedge/sedna-example-lifelong-learning-atcii-classifier:v0.3.0
          name:  infer-worker
          imagePullPolicy: IfNotPresent
          args: ["inference.py"]
          env:
          - name: "UT_SAVED_URL"
            value: "/ut_saved_url"
          - name: "infer_dataset_url"
            value: "/data/testData.csv"
          volumeMounts:
          - name: utdir
            mountPath: /ut_saved_url
          - name: inferdata
            mountPath: /data/
          resources:
            limits:
              memory: 2Gi
        volumes:
          - name: utdir
            hostPath:
              path: /lifelong/unseen_task/
              type: DirectoryOrCreate
          - name: inferdata
            hostPath:
              path:  /data/
              type: DirectoryOrCreate
  outputDir: "/output"
CRD
Le CRD est le gabarit du CR. Il faut le déclarer sur le cluster avant de créer des CR. YAML à la main ou généré ; pour du non trivial, générer. Sedna utilise controller-gen de kubebuilder. make crds met à jour build/crds/. Voir crds: controller-gen dans le Makefile.
Pour un CRD : group, version, kind — GVK. L’objet est une Resource. En OO, Resource ≈ Object, Kind ≈ Class. GVR / GVK lifelong :
| Group | Version | Resource | Kind | |
|---|---|---|---|---|
| CRD | apiextensions.k8s.io | v1 | lifelonglearningjobs.sedna.io | CustomResourceDefinition |
| CR | sedna.io | v1alpha1 | lifelonglearningjob | LifelongLearningJob |
Dans K8S les ressources sont des URI REST :
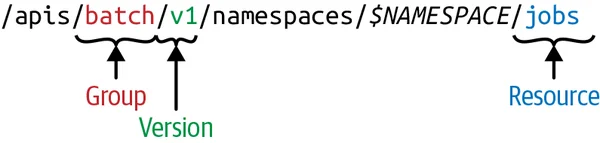
Une fois le schéma connu, tu colles une URI REST sans kubectl / client-go. Ex. :
CRD lifelong en REST :
curl -k --cert ./client.crt --key ./client.key https://127.0.0.1:5443/apis/apiextensions.k8s.io/v1beta1/customresourcedefinitions/lifelonglearningjobs.sedna.ioListe des CR lifelong en REST :
curl -k --cert ./client.crt --key ./client.key https://127.0.0.1:5443/apis/sedna.io/v1alpha1/lifelonglearningjobsPas de SDK k8s officiel dans un langage → encapsuler ces REST.
CRD Sedna lifelong, champs à voir :
apiVersion: apiextensions.k8s.io/v1, tous les CRD étendent apiextensions.k8s.io/v1kind: CustomResourceDefinitionspec.group: sedna.io, le Group s’appelle sedna.iospec.names.kind: LifelongLearningJobspec.names.shortNames: - ll, raccourci kubectlll
build/crds/sedna.io_lifelonglearningjobs.yaml
apiVersion: apiextensions.k8s.io/v1
kind: CustomResourceDefinition
metadata:
  annotations:
    controller-gen.kubebuilder.io/version: v0.4.1
  creationTimestamp: null
  name: lifelonglearningjobs.sedna.io
spec:
  group: sedna.io
  names:
    kind: LifelongLearningJob
    listKind: LifelongLearningJobList
    plural: lifelonglearningjobs
    shortNames:
    - ll
    singular: lifelonglearningjob
  scope: Namespaced
  versions:
  - name: v1alpha1
...
status:
  acceptedNames:
    kind: ""
    plural: ""
  conditions: []
  storedVersions: []
API
Les CRD sont générés — d’où vient l’API ?
pkg/apis/sedna/v1alpha1/lifelonglearningjob_types.go
package v1alpha1

import (
v1 "k8s.io/api/core/v1"
metav1 "k8s.io/apimachinery/pkg/apis/meta/v1"
)

// 这里展示了
// +genclient
// +k8s:deepcopy-gen:interfaces=k8s.io/apimachinery/pkg/runtime.Object
// +kubebuilder:resource:shortName=ll
// +kubebuilder:subresource:status

// 整体的LifelongLearningJob的API定义,主要包含Spec和Status定义,分别代表期望状态和实际状态。
type LifelongLearningJob struct {
metav1.TypeMeta   `json:",inline"`
metav1.ObjectMeta `json:"metadata"`
Spec              LLJobSpec   `json:"spec"`
Status            LLJobStatus `json:"status,omitempty"`
}

// 在创建LifelongLearningJob时候需要配置的参数;如果需要扩展终身学习字段的接口,可以在这里修改。
type LLJobSpec struct {
Dataset    LLDataset    `json:"dataset"`
TrainSpec  LLTrainSpec  `json:"trainSpec"`
EvalSpec   LLEvalSpec   `json:"evalSpec"`
DeploySpec LLDeploySpec `json:"deploySpec"`

// the credential referer for OutputDir
CredentialName string `json:"credentialName,omitempty"`
OutputDir      string `json:"outputDir"`
}

type LLDataset struct {
Name      string  `json:"name"`
TrainProb float64 `json:"trainProb"`
}

// 剩下还有一些结构体定义省略了。
Sur ce snippet :
// +kubebuilder...: flags pour kubebuilder / codegentype LifelongLearningJob struct{...}: API globale, Spec souhaité, Status réeltype LLJobSpec struct {...}: params à la création du CR ; étendre ici
Inférence conjointe / incrémental / fédéré : aussi pkg/apis/sedna/v1alpha1/.
Mettre à jour client-go
Après *_types.go :
bash hack/update-codegen.shCode généré dans pkg/client :
➜  pkg tree client -L 2
client
├── clientset
│   └── versioned
├── informers
│   └── externalversions
└── listers
    └── sedna
client-go sert plus loin dans le Controller.
Mettre à jour les CRD
Après *_types.go :
make crdsYAML dans build/crds. Puis kubectl apply à nouveau.
Controller
La logique lifelong est dans pkg/globalmanager/controllers/lifelonglearning/lifelonglearningjob.go — quand les workers train/eval partent, comment les params vont à l’edge.
Avant ça, le flux, en pseudo :
cmd/sedna-gm/sedna-gm.go/main() 【1】
pkg/globalmanager/controllers/manager.go/New() 【2】读取GM配置文件。
pkg/globalmanager/controllers/manager.go/Start() 【3】启动GM进程。
    - clientset.NewForConfig():【4】调用client-go生成了Sedna CRD client。
    - NewUpstreamController():【5】创建UpstreamController,每个GM进程有一个UpstreamController
    - uc.Run(stopCh):启动一个for循环协程,来处理
        - pkg/globalmanager/controllers/upstream.go/syncEdgeUpdate()
    - NewRegistry():【6】注册所有controller。
        - f.SetDownstreamSendFunc()【7】
            -> pkg/globalmanager/controllers/lifelonglearning/downstream.go
        - f.SetUpstreamHandler()【8】
            -> pkg/globalmanager/controllers/lifelonglearning/upstream.go/updateFromEdge()
        - f.Run()【9】
    - ws.ListenAndServe() 【10】
Controller LifelongLearningJob, numéros 1 à 10 :
[1] main
sedna-gm.go : entrée GM, logs, app.NewControllerCommand() parse, démarre le controller.
cmd/sedna-gm/sedna-gm.go
func main() {
   rand.Seed(time.Now().UnixNano())

   command := app.NewControllerCommand()
   logs.InitLogs()
   defer logs.FlushLogs()

   if err := command.Execute(); err != nil {
      os.Exit(1)
   }
}
[2] Config GM
Cluster K8S, addr/port websocket, addr du KB, etc.
pkg/globalmanager/controllers/manager.go
// New creates the controller manager
func New(cc *config.ControllerConfig) *Manager {
   config.InitConfigure(cc)
   return &Manager{
      Config: cc,
   }
}
pkg/globalmanager/config/config.go
// ControllerConfig indicates the config of controller
type ControllerConfig struct {
   // KubeAPIConfig indicates the kubernetes cluster info which controller will connected
   KubeConfig string `json:"kubeConfig,omitempty"`

   // Master indicates the address of the Kubernetes API server. Overrides any value in KubeConfig.
   // such as https://127.0.0.1:8443
   // default ""
   Master string `json:"master"`
   // Namespace indicates which namespace the controller listening to.
   // default ""
   Namespace string `json:"namespace,omitempty"`

   // websocket server config
   // Since the current limit of kubeedge(1.5), GM needs to build the websocket channel for communicating between GM and LCs.
   WebSocket WebSocket `json:"websocket,omitempty"`

   // lc config to info the worker
   LC LCConfig `json:"localController,omitempty"`

   // kb config to info the worker
   KB KBConfig `json:"knowledgeBaseServer,omitempty"`

   // period config min resync period
   // default 30s
   MinResyncPeriodSeconds int64 `json:"minResyncPeriodSeconds,omitempty"`
}
[3] Init GM
Client CRD Sedna, bind et start des handlers cloud–edge, start des controllers par feature, listen websocket.
pkg/globalmanager/controllers/manager.go
// Start starts the controllers it has managed
func (m *Manager) Start() error {
   ...
   // 初始化Sedna CRD client,Controller会监听Sedna CR 增删改查的变化,并执行对应的处理逻辑。
   sednaClient, err := clientset.NewForConfig(kubecfg)

   ...
   sednaInformerFactory := sednainformers.NewSharedInformerFactoryWithOptions(sednaClient, genResyncPeriod(minResyncPeriod), sednainformers.WithNamespace(namespace))

   // 初始化UpstreamController,用于处理边缘LC上传的消息
   uc, _ := NewUpstreamController(context)
   downstreamSendFunc := messagelayer.NewContextMessageLayer().SendResourceObject
   stopCh := make(chan struct{})
   go uc.Run(stopCh)

   // 针对每个特性(协同推理、终身学习等),绑定对应的消息处理函数
   for name, factory := range NewRegistry() {
      ...
      f.SetDownstreamSendFunc(downstreamSendFunc)
      f.SetUpstreamHandler(uc.Add)
      ...
      // 启动各个特性对应controller
      go f.Run(stopCh)
   }

   ...

   // 启动整体GM的websocket,默认监听在0.0.0.0:9000这个端口地址
   ws := websocket.NewServer(addr)
   ...
}
[4] Init client CRD
clientset.NewForConfig() dans pkg/client/clientset/versioned/clientset.go — généré par client-go, CRUD Go.
L’init du Controller LifelongLearningJob s’en sert :
- Informer LifelongLearningJob. Cache local de l’api-server, moins de lectures.
- Champs : client k8s, client sedna, config GM.
- Callbacks Add / Update / Delete.
pkg/globalmanager/controllers/lifelonglearning/lifelonglearningjob.go
// New creates a new LifelongLearningJob controller that keeps the relevant pods
// in sync with their corresponding LifelongLearningJob objects.
func New(cc *runtime.ControllerContext) (runtime.FeatureControllerI, error) {
   cfg := cc.Config

   podInformer := cc.KubeInformerFactory.Core().V1().Pods()

   // 获取LifelongLearningJob的Informer
   jobInformer := cc.SednaInformerFactory.Sedna().V1alpha1().LifelongLearningJobs()

   eventBroadcaster := record.NewBroadcaster()
   eventBroadcaster.StartRecordingToSink(&v1core.EventSinkImpl{Interface: cc.KubeClient.CoreV1().Events("")})

   // 配置LifelongLearningJob Controller的参数
   jc := &Controller{
      kubeClient: cc.KubeClient,
      client:     cc.SednaClient.SednaV1alpha1(),
      queue:      workqueue.NewNamedRateLimitingQueue(workqueue.NewItemExponentialFailureRateLimiter(runtime.DefaultBackOff, runtime.MaxBackOff), Name),
      cfg:        cfg,
   }

   // 绑定LifelongLearningJob CRD资源的Add、Update、Delete对应事件的回调函数。
   jobInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
      AddFunc: func(obj interface{}) {
         jc.enqueueController(obj, true)
         jc.syncToEdge(watch.Added, obj)
      },
      UpdateFunc: func(old, cur interface{}) {
         jc.enqueueController(cur, true)
         jc.syncToEdge(watch.Added, cur)
      },
      DeleteFunc: func(obj interface{}) {
         jc.enqueueController(obj, true)
         jc.syncToEdge(watch.Deleted, obj)
      },
   })
   jc.jobLister = jobInformer.Lister()
   jc.jobStoreSynced = jobInformer.Informer().HasSynced

   // 绑定Pod对应的增删改对应事件的回调函数。
   podInformer.Informer().AddEventHandler(cache.ResourceEventHandlerFuncs{
      AddFunc:    jc.addPod,
      UpdateFunc: jc.updatePod,
      DeleteFunc: jc.deletePod,
   })
   jc.podStore = podInformer.Lister()
   jc.podStoreSynced = podInformer.Informer().HasSynced

   return jc, nil
}
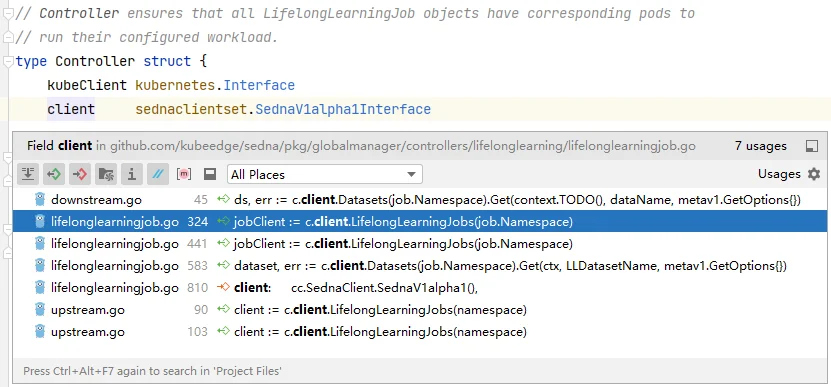
Autres usages du client CRD :
[5] Init messages
uc.Run() init UpstreamController, tous les messages de l’edge.
Boucle sur context.upstreamChannel. Message → uc.updateHandlers[kind]. Map : inférence conjointe, incrémental, fédéré, lifelong.
pkg/globalmanager/controllers/upstream.go
// syncEdgeUpdate receives the updates from edge and syncs these to k8s.
func (uc *UpstreamController) syncEdgeUpdate() {
   for {
      select {
      case <-uc.messageLayer.Done():
         klog.Info("Stop sedna upstream loop")
         return
      default:
      }

      update, err := uc.messageLayer.ReceiveResourceUpdate()
  ...

      handler, ok := uc.updateHandlers[kind]
      if ok {
         err := handler(name, namespace, operation, update.Content)
         ...
      }
   }
}
ReceiveFromEdge : canal bloquant depuis le LC edge, type nodeMessage.
pkg/globalmanager/messagelayer/ws/context.go
// ReceiveResourceUpdate receives and handles the update
func (cml *ContextMessageLayer) ReceiveResourceUpdate() (*ResourceUpdateSpec, error) {
   nodeName, msg, err := wsContext.ReceiveFromEdge()
   ...
}
[6] Registry des controllers
NewRegistry() enregistre les New de chaque feature. Nouvelle feature → New ici.
pkg/globalmanager/controllers/registry.go
func NewRegistry() Registry {
   return Registry{
      ji.Name:      ji.New,
      fe.Name:      fe.New,
      fl.Name:      fl.New,
      il.Name:      il.New,
      ll.Name:      ll.New,
      reid.Name:    reid.New,
      va.Name:      va.New,
      dataset.Name: dataset.New,
      objs.Name:    objs.New,
   }
}
[7] Cloud → edge
f.SetDownstreamSendFunc() bind syncToEdge() par feature.
Lifelong :
- Nœud du Dataset CR.
- Noms train / eval / deploy via annotations.
- Selon le stage, envoyer à des nœuds différents.
pkg/globalmanager/controllers/lifelonglearning/downstream.go
func (c *Controller) syncToEdge(eventType watch.EventType, obj interface{}) error {

   // 获取到对应的数据集指定的节点(Dataset CRD对象中有一个字段记录了Node名称)
   ds, err := c.client.Datasets(job.Namespace).Get(context.TODO(), dataName, metav1.GetOptions{})

   // 获取到训练、评估、部署对应的节点名称
   getAnnotationsNodeName := func(nodeName sednav1.LLJobStage) string {
      return runtime.AnnotationsKeyPrefix + string(nodeName)
   }
   ann := job.GetAnnotations()
   if ann != nil {
      trainNodeName = ann[getAnnotationsNodeName(sednav1.LLJobTrain)]
      evalNodeName = ann[getAnnotationsNodeName(sednav1.LLJobEval)]
      deployNodeName = ann[getAnnotationsNodeName(sednav1.LLJobDeploy)]
   }

   ...

   // 根据LifelongLearningJob所处阶段不同,发送消息到不同的节点上
   switch jobStage {
   case sednav1.LLJobTrain:
      doJobStageEvent(trainNodeName)
   case sednav1.LLJobEval:
      doJobStageEvent(evalNodeName)
   case sednav1.LLJobDeploy:
      doJobStageEvent(deployNodeName)
   }

   return nil
}
[8] Edge → cloud
f.SetUpstreamHandler() bind updateFromEdge().
Lifelong :
- Changer l’état global du job selon ce que l’edge a fini.
- Réécrire cet état dans k8s, Status du CR.
- Parser le message edge (json). Ex. :
Ce que GM reçoit :
{
    "phase": "train",
    "status": "completed",
    "output": {
        "models": [{
            "classes":  ["road", "fence"],
            "current_metric": null,
            "format": "pkl",
            "metrics": null,
            "url": "/output/train/1/index.pkl"
        }],
        "ownerInfo": null
    }
}
pkg/globalmanager/controllers/lifelonglearning/upstream.go
// updateFromEdge syncs the edge updates to k8s
func (c *Controller) updateFromEdge(name, namespace, operation string, content []byte) error {
   var jobStatus struct {
      Phase  string `json:"phase"`
      Status string `json:"status"`
   }

   // 把边缘消息结构体进行解析。
   err := json.Unmarshal(content, &jobStatus)
   ...
   cond := sednav1.LLJobCondition{
      Status:             v1.ConditionTrue,
      LastHeartbeatTime:  metav1.Now(),
      LastTransitionTime: metav1.Now(),
      Data:               string(condDataBytes),
      Message:            "reported by lc",
   }

   // 根据不同的边缘节点任务状态实现,变更当前LifelongLearningJob的整体状态
   switch strings.ToLower(jobStatus.Status) {
   case "ready":
      cond.Type = sednav1.LLJobStageCondReady
   case "completed":
      cond.Type = sednav1.LLJobStageCondCompleted
   case "failed":
      cond.Type = sednav1.LLJobStageCondFailed
   case "waiting":
      cond.Type = sednav1.LLJobStageCondWaiting
   default:
      return fmt.Errorf("invalid condition type: %v", jobStatus.Status)
   }

   // 将当前LifelongLearningJob的整体状态写回k8s,也就是LifelongLearningJob这个CR的Status字段。
   err = c.appendStatusCondition(name, namespace, cond)
   ...
}
[9] Cœur du Controller
f.run() lance chaque controller. run() lifelong :
WaitForNamedCacheSync jusqu’à ce que Pod et LifelongLearningJob soient dans l’Informer. Puis N workers.
pkg/globalmanager/controllers/lifelonglearning/lifelonglearningjob.go
// Run starts the main goroutine responsible for watching and syncing jobs.
func (c *Controller) Run(stopCh <-chan struct{}) {
   workers := 1

   defer utilruntime.HandleCrash()
   defer c.queue.ShutDown()

   klog.Infof("Starting %s controller", Name)
   defer klog.Infof("Shutting down %s controller", Name)

   if !cache.WaitForNamedCacheSync(Name, stopCh, c.podStoreSynced, c.jobStoreSynced) {
      klog.Errorf("failed to wait for %s caches to sync", Name)

      return
   }
   klog.Infof("Starting %s workers", Name)
   for i := 0; i < workers; i++ {
      go wait.Until(c.worker, time.Second, stopCh)
   }

   <-stopCh
}
c.worker appelle processNextWorkItem().
pkg/globalmanager/controllers/lifelonglearning/lifelonglearningjob.go
// worker runs a worker thread that just dequeues items, processes them, and marks them done.
// It enforces that the syncHandler is never invoked concurrently with the same key.
func (c *Controller) worker() {
   for c.processNextWorkItem() {
   }
}
processNextWorkItem() → c.sync().
pkg/globalmanager/controllers/lifelonglearning/lifelonglearningjob.go
func (c *Controller) sync(key string) (bool, error) {
   //省略了部分代码
   ns, name, err := cache.SplitMetaNamespaceKey(key)

   sharedJob, err := c.jobLister.LifelongLearningJobs(ns).Get(name)

   // if job was finished previously, we don't want to redo the termination
   if IsJobFinished(&job) {
      return true, nil
   }

   // transit this job's state machine
   needUpdated, err = c.transitJobState(&job)


   if needUpdated {
      if err := c.updateJobStatus(&job); err != nil {
         return forget, err
      }

      if jobFailed && !IsJobFinished(&job) {
         // returning an error will re-enqueue LifelongLearningJob after the backoff period
         return forget, fmt.Errorf("failed pod(s) detected for lifelonglearningjob key %q", key)
      }

      forget = true
   }

   return forget, err
}
sync sur un job concret :
SplitMetaNamespaceKey→ namespace et namec.jobListerrécupère l’objettransitJobState: train / eval / deploy- Si Status a changé,
c.updateJobStatus()pour que kubectl montre le stage, le chemin modèle, etc. - Échecs
// transit this job's state machine
needUpdated, err = c.transitJobState(&job)
transitJobState() est la machine d’états. Voir le schéma :
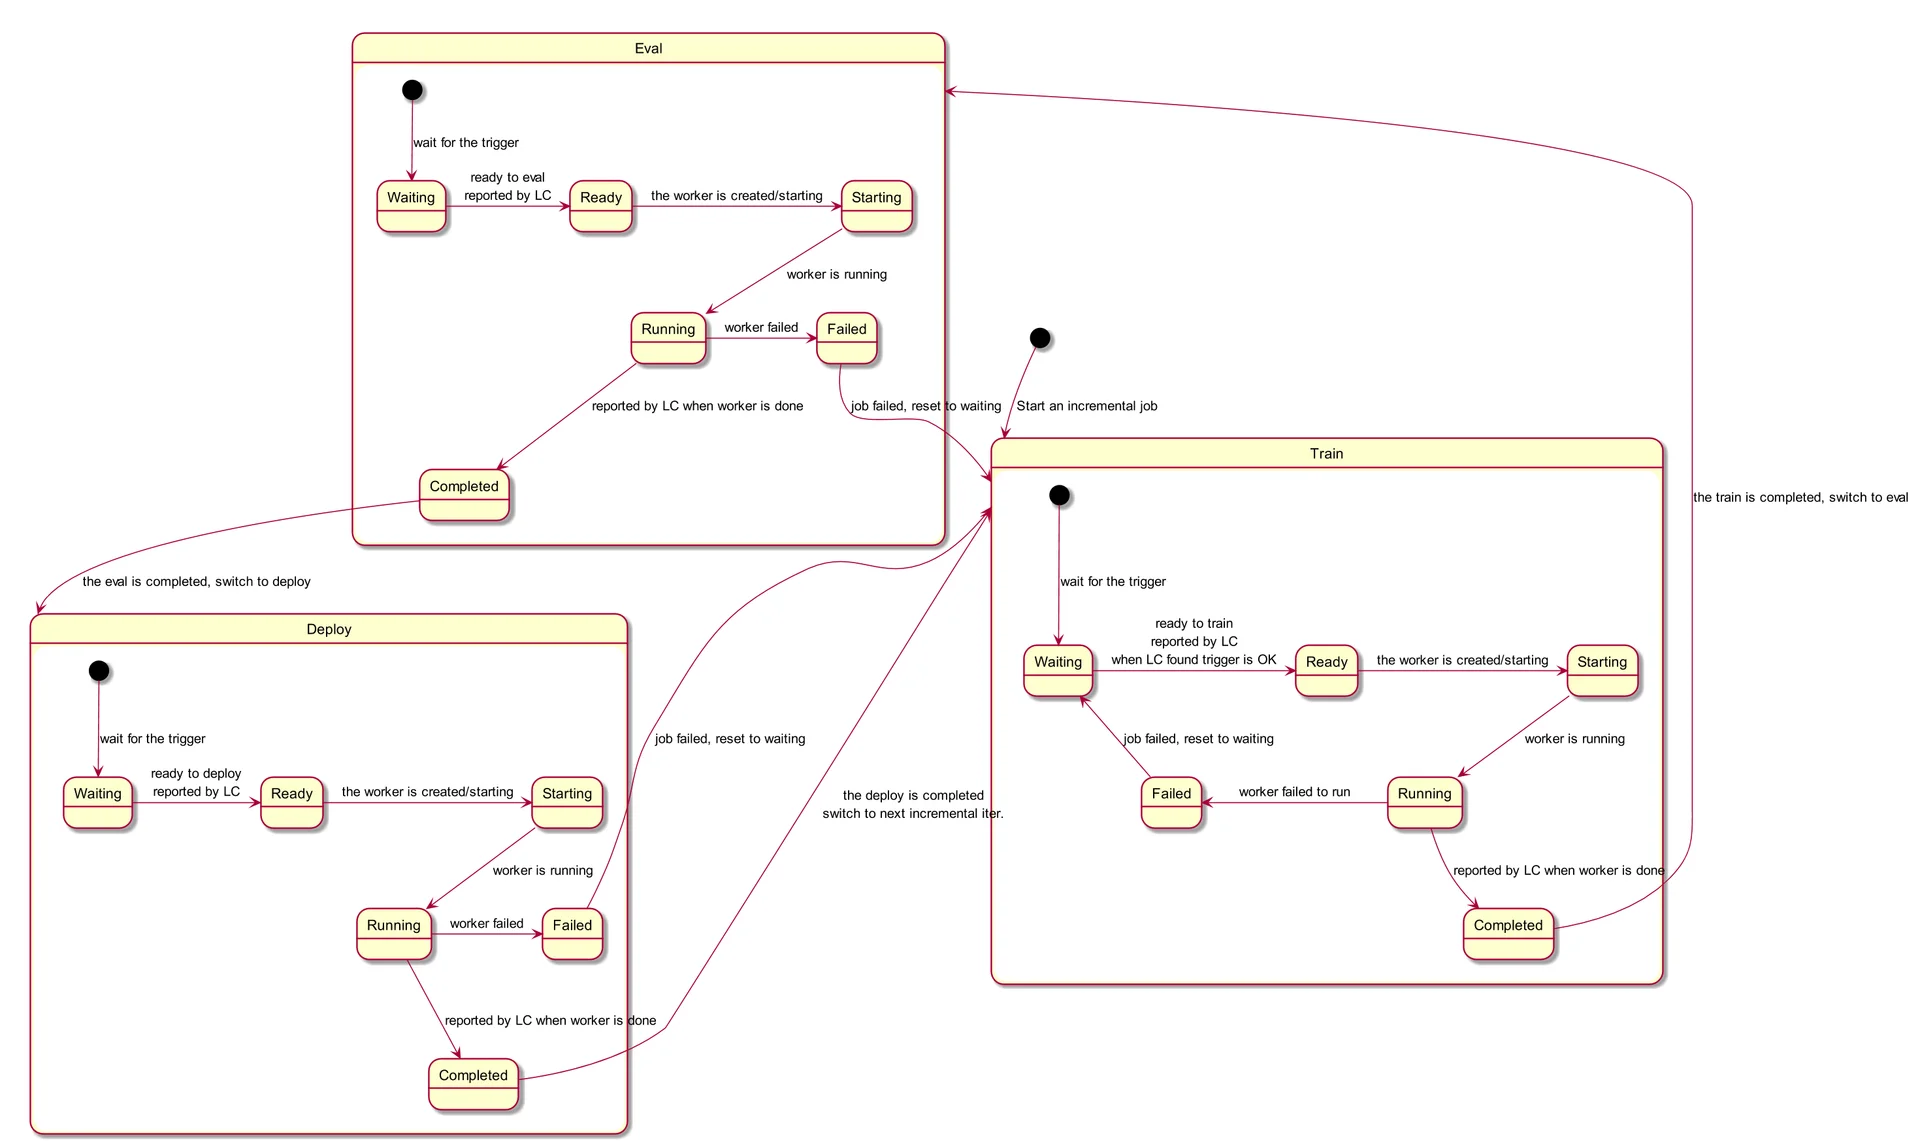
[10] Listen websocket
Websocket pour les messages edge de [8], défaut 0.0.0.0:9000.
pkg/globalmanager/controllers/manager.go
addr := fmt.Sprintf("%s:%d", m.Config.WebSocket.Address, m.Config.WebSocket.Port)

ws := websocket.NewServer(addr)
err = ws.ListenAndServe()
LC : Local Controller
LC sur le nœud edge : jobs locaux et proxy de messages. Entrée cmd/sedna-lc/sedna-lc.go ; voir GM pour un entry similaire. Enregistrement :
cmd/sedna-lc/app/server.go
// runServer runs server
func runServer() {
   c := gmclient.NewWebSocketClient(Options)
   if err := c.Start(); err != nil {
      return
   }

   dm := dataset.New(c, Options)
   mm := model.New(c)
   jm := jointinference.New(c)
   fm := federatedlearning.New(c)
   im := incrementallearning.New(c, dm, mm, Options)
   lm := lifelonglearning.New(c, dm, Options)
   s := server.New(Options)

   for _, m := range []managers.FeatureManager{
      dm, mm, jm, fm, im, lm,
   } {
      s.AddFeatureManager(m)
      c.Subscribe(m)
      err := m.Start()
      if err != nil {
         klog.Errorf("failed to start manager %s: %v",
            m.GetName(), err)
         return
      }
      klog.Infof("manager %s is started", m.GetName())
   }

   s.ListenAndServe()
}
Jobs locaux
Manager gère les jobs edge. Forme :
pkg/localcontroller/managers/lifelonglearning/lifelonglearningjob.go
// LifelongLearningJobManager defines lifelong-learning-job Manager
type Manager struct {
   Client                 clienttypes.ClientI
   WorkerMessageChannel   chan workertypes.MessageContent
   DatasetManager         *dataset.Manager
   LifelongLearningJobMap map[string]*Job
   VolumeMountPrefix      string
}
startJob() :
- Surveiller les Dataset syncés ; ex. nombre d’échantillons au seuil → train.
- Selon le stage, train / eval / deploy. L’edge ne les démarre pas lui-même : il reporte au GM, le GM schedule.
pkg/localcontroller/managers/lifelonglearning/lifelonglearningjob.go
// startJob starts a job
func (lm *Manager) startJob(name string) {
   ...

   // 监控并处理同步到边缘的Dataset对象。
   go lm.handleData(job)

   tick := time.NewTicker(JobIterationIntervalSeconds * time.Second)
   for {
      // 根据当前任务不同阶段,触发不同阶段的训练、评估、部署任务。
      select {
      case <-job.JobConfig.Done:
         return
      case <-tick.C:
         cond := lm.getLatestCondition(job)
         jobStage := cond.Stage

         switch jobStage {
         case sednav1.LLJobTrain:
            err = lm.trainTask(job)
         case sednav1.LLJobEval:
            err = lm.evalTask(job)

         case sednav1.LLJobDeploy:
            err = lm.deployTask(job)
         default:
            klog.Errorf("invalid phase: %s", jobStage)
            continue
         }
 ...
      }
   }
}
Aussi : watch dataset, download de modèles, backup local des jobs, etc.
Proxy de messages
En plus d’envoyer le statut au cloud, LC ouvre un HTTP server 0.0.0.0:9100, prend les messages de la Lib, les agrège, les envoie au GM. Routes :
pkg/localcontroller/server/server.go
// register registers api
func (s *Server) register(container *restful.Container) {
ws := new(restful.WebService)
ws.Path(fmt.Sprintf("/%s", constants.ServerRootPath)).
Consumes(restful.MIME_XML, restful.MIME_JSON).
Produces(restful.MIME_JSON, restful.MIME_XML)

ws.Route(ws.POST("/workers/{worker-name}/info").
To(s.messageHandler).
Doc("receive worker message"))
container.Add(ws)
}
pkg/localcontroller/server/server.go
// messageHandler handles message from the worker
func (s *Server) messageHandler(request *restful.Request, response *restful.Response) {
   var err error
   workerName := request.PathParameter("worker-name")
   workerMessage := workertypes.MessageContent{}

   err = request.ReadEntity(&workerMessage)
   if workerMessage.Name != workerName || err != nil {
      var msg string
      if workerMessage.Name != workerName {
         msg = fmt.Sprintf("worker name(name=%s) in the api is different from that(name=%s) in the message body",
            workerName, workerMessage.Name)
      } else {
         msg = fmt.Sprintf("read worker(name=%s) message body failed, error: %v", workerName, err)
      }

      klog.Errorf(msg)
      err = s.reply(response, http.StatusBadRequest, msg)
      if err != nil {
         klog.Errorf("reply messge to worker(name=%s) failed, error: %v", workerName, err)
      }
   }

   if m, ok := s.fmm[workerMessage.OwnerKind]; ok {
      m.AddWorkerMessage(workerMessage)
   }

   err = s.reply(response, http.StatusOK, "OK")
   if err != nil {
      klog.Errorf("reply message to worker(name=%s) failed, error: %v", workerName, err)
      return
   }
}
Source Sedna Lib (Python)
Lib = bibliothèque Python pour devs IA / appli, pour transformer du code existant en collab cloud–edge.
Layout :
➜  sedna tree lib -L 2
lib
├── __init__.py
├── MANIFEST.in
├── OWNERS
├── requirements.dev.txt
├── requirements.txt    // Sedna Python的依赖
├── sedna
│   ├── algorithms  // 边云协同算法
│   ├── backend     // 支持的后端,tensorflow/pytorch
│   ├── common
│   ├── core        // 主要特性的实现逻辑
│   ├── datasources // 支持的数据源格式,比如txt、csv等
│   ├── __init__.py
│   ├── README.md
│   ├── service     // 需要启动server的组件,比如kb等
│   ├── VERSION
│   └── __version__.py
└── setup.py
Morceaux typiques :
core
core wrappe les callbacks user. train ci-dessous appelle surtout le train tensorflow / pytorch / mindspore de l’user.
- Configurer le post-process.
- Appeler la knowledge base cloud pour train / infer.
- Mettre à jour la KB. En lifelong elle garde nouveaux modèles et samples, et bouge tout le temps.
- Reporter le job train au LC — fini ou pas, métriques.
lib/sedna/core/lifelong_learning/lifelong_learning.py
def train(self, train_data,
          valid_data=None,
          post_process=None,
          **kwargs):
    is_completed_initilization = \
        str(Context.get_parameters("HAS_COMPLETED_INITIAL_TRAINING",
                                   "false")).lower()

    if is_completed_initilization == "true":
        return self.update(train_data,
                           valid_data=valid_data,
                           post_process=post_process,
                           **kwargs)

    # 配置后处理函数
    callback_func = None
    if post_process is not None:
        callback_func = ClassFactory.get_cls(
            ClassType.CALLBACK, post_process)
    res, seen_task_index = \
        self.cloud_knowledge_management.seen_estimator.train(
            train_data=train_data,
            valid_data=valid_data,
            **kwargs
        )

    # 调用云端知识库进行训练、或推理
    unseen_res, unseen_task_index = \
        self.cloud_knowledge_management.unseen_estimator.train()

    # 更新云端知识库
    task_index = dict(
        seen_task=seen_task_index,
        unseen_task=unseen_task_index)
    task_index_url = FileOps.dump(
        task_index, self.cloud_knowledge_management.local_task_index_url)

    task_index = self.cloud_knowledge_management.update_kb(task_index_url)
    res.update(unseen_res)

    ...

    # 将当前训练任务执行的情况发送给LC,比如训练任务是否完成、训练后的指标是多少
    self.report_task_info(
            None, K8sResourceKindStatus.COMPLETED.value, task_info_res)
        self.log.info(f"Lifelong learning Train task Finished, "
                      f"KB index save in {task_index}")
        return callback_func(self.estimator, res) if callback_func else res

    ...
backend
MSBackend : backend MindSpore. Si un framework a train / predict / evaluate typiques, Sedna Lib peut l’utiliser en backend et wrapper le code IA existant.
lib/sedna/backend/mindspore/__init__.py
class MSBackend(BackendBase):
    def __init__(self, estimator, fine_tune=True, **kwargs):
        super(MSBackend, self).__init__(estimator=estimator,
                                        fine_tune=fine_tune,
                                        **kwargs)
        self.framework = "mindspore"
        if self.use_npu:
            context.set_context(mode=context.GRAPH_MODE,
                                device_target="Ascend")
        elif self.use_cuda:
            context.set_context(mode=context.GRAPH_MODE,
                                device_target="GPU")
        else:
            context.set_context(mode=context.GRAPH_MODE,
                                device_target="CPU")

        if callable(self.estimator):
            self.estimator = self.estimator()

    def train(self, train_data, valid_data=None, **kwargs):
        if callable(self.estimator):
            self.estimator = self.estimator()
        if self.fine_tune and FileOps.exists(self.model_save_path):
            self.finetune()
        self.has_load = True
        varkw = self.parse_kwargs(self.estimator.train, **kwargs)
        return self.estimator.train(train_data=train_data,
                                    valid_data=valid_data,
                                    **varkw)

    def predict(self, data, **kwargs):
        if not self.has_load:
            self.load()
        varkw = self.parse_kwargs(self.estimator.predict, **kwargs)
        return self.estimator.predict(data=data, **varkw)

    def evaluate(self, data, **kwargs):
        if not self.has_load:
            self.load()
        varkw = self.parse_kwargs(self.estimator.evaluate, **kwargs)
        return self.estimator.evaluate(data, **varkw)
datasource
datasource wrappe les formats de datasets courants, pour ne pas avoir à
lib/sedna/datasources/__init__.py
class CSVDataParse(BaseDataSource, ABC):
    """
    csv file which contain Structured Data parser
    """
    # 提供了方便的数据集解析函数,
    def parse(self, *args, **kwargs):
        x_data = []
        y_data = []
        label = kwargs.pop("label") if "label" in kwargs else ""
        usecols = kwargs.get("usecols", "")
        if usecols and isinstance(usecols, str):
            usecols = usecols.split(",")
        if len(usecols):
            if label and label not in usecols:
                usecols.append(label)
            kwargs["usecols"] = usecols
        for f in args:
            if isinstance(f, (dict, list)):
                res = self.parse_json(f, **kwargs)
            else:
                if not (f and FileOps.exists(f)):
                    continue
                res = pd.read_csv(f, **kwargs)
            if self.process_func and callable(self.process_func):
                res = self.process_func(res)
            if label:
                if label not in res.columns:
                    continue
                y = res[label]
                y_data.append(y)
                res.drop(label, axis=1, inplace=True)
            x_data.append(res)
        if not x_data:
            return
        self.x = pd.concat(x_data)
        self.y = pd.concat(y_data)
algorithms
L’IA cloud–edge a besoin d’algos pour ce cadre. Sedna embarque quelques mineurs d’exemples durs, ex. le seuil d’entropie croisée ci-dessous, qui repère un sample quand le modèle edge n’est pas sûr.
Le but n’est pas seulement d’embarquer ces bases — c’est de pouvoir ajouter des algos utiles qui améliorent train/infer global. C’est ce que cette forme de Lib vise.
lib/sedna/algorithms/hard_example_mining/hard_example_mining.py
@ClassFactory.register(ClassType.HEM, alias="CrossEntropy")
class CrossEntropyFilter(BaseFilter, abc.ABC):
    """
    **Object detection** Hard samples discovery methods named `CrossEntropy`

    Parameters
    ----------
    threshold_cross_entropy: float
        hard coefficient threshold score to filter img, default to 0.5.
    """

    def __init__(self, threshold_cross_entropy=0.5, **kwargs):
        self.threshold_cross_entropy = float(threshold_cross_entropy)

    def __call__(self, infer_result=None) -> bool:
        """judge the img is hard sample or not.

        Parameters
        ----------
        infer_result: array_like
            prediction classes list, such as
            [class1-score, class2-score, class2-score,....],
            where class-score is the score corresponding to the class,
            class-score value is in [0,1], who will be ignored if its
            value not in [0,1].

        Returns
        -------
        is hard sample: bool
            `True` means hard sample, `False` means not.
        """

        if not infer_result:
            # if invalid input, return False
            return False

        log_sum = 0.0
        data_check_list = [class_probability for class_probability
                           in infer_result
                           if self.data_check(class_probability)]

        if len(data_check_list) != len(infer_result):
            return False

        for class_data in data_check_list:
            log_sum += class_data * math.log(class_data)
        confidence_score = 1 + 1.0 * log_sum / math.log(
            len(infer_result))
        return confidence_score < self.threshold_cross_entropy