
RPC - Remote Procedure Call - 遠端過程呼叫
用來解決分散式系統通訊問題,核心特點是可以像呼叫本地一樣發起遠端呼叫。RPC其實不只是微服務雲原生專用名詞,只要涉及到網路通訊,就可能用到RPC。
舉兩個例子:
- 大型分散式應用系統可能會依賴訊息佇列、分散式快取、分散式資料庫以及統一配置中心等,應用程式與依賴的這些中介軟體之間都可以透過RPC進行通訊。比如etcd,它作為一個統一的配置服務,客戶端就是透過gRPC框架與服務端進行通訊的。
- Kubernetes本身就是分散式的,Kubernetes的kube-apiserver與整個分散式叢集中的每個元件間的通訊,都是透過gRPC框架進行的。
RPC涉及:
- 序列化: 將物件轉換為可傳輸的位元組流(序列化)及逆向還原(反序列化),解決跨網路和跨語言的資料交換問題。
- 壓縮演算法: 減少網路傳輸的資料量,降低頻寬消耗和延遲。
- 協議: 定義客戶端與服務端通訊的規則,包括傳輸格式和互動模式:HTTP/2、TCP、UDP。
- 動態代理: 遮蔽遠端呼叫的複雜性,使開發者像呼叫本地方法一樣使用遠端服務:JDK動態代理、位元組碼增強。
- 服務註冊與發現: 動態管理服務實例的可用性,支援負載均衡和故障轉移。註冊中心如ZooKeeper、Consul、ETCD,記錄服務地址和元資料。
- 加密:保障資料傳輸的機密性和完整性,防止中間人攻擊和資料篡改。
- 網路通訊:網路IO模型,實現高效、穩定的網路通訊,處理連線管理、資料收發等底層細節。網路通訊說起來簡單,但實際上是一個非常複雜的過程,這個過程主要包括:對端節點的查詢、網路連線的建立、傳輸資料的編碼解碼以及網路連線的管理等等。RPC對網路通訊的整個過程做了完整包裝,在搭建分散式系統時,它會使網路通訊邏輯的開發變得簡單,同時也會讓網路通訊變得更加安全可靠。
RPC叢集涉及:
- 監控
- 熔斷限流
- 優雅啟停
- 多協議
- 分散式鏈路跟蹤
RPC真正強大的地方:
- 連線管理
- 健康檢測
- 負載均衡
- 優雅啟停機
- 異常重試
- 業務分組
- 熔斷限流
如果沒有RPC框架,那要怎麼呼叫另外一臺伺服器的介面呢?
RPC是幫助我們遮蔽網路程式設計細節,實現呼叫遠端方法就跟呼叫本地(同一個專案中的方法)一樣的體驗,我們不需要因為這個方法是遠端呼叫就需要編寫很多與業務無關的程式碼。
RPC的作用主要體現在兩方面:
- 遮蔽遠端呼叫和本地呼叫的區別,讓我們覺得這就是呼叫專案內的方法;
- 隱藏底層網路通訊的複雜性,讓我們更專注於業務邏輯。
序列化
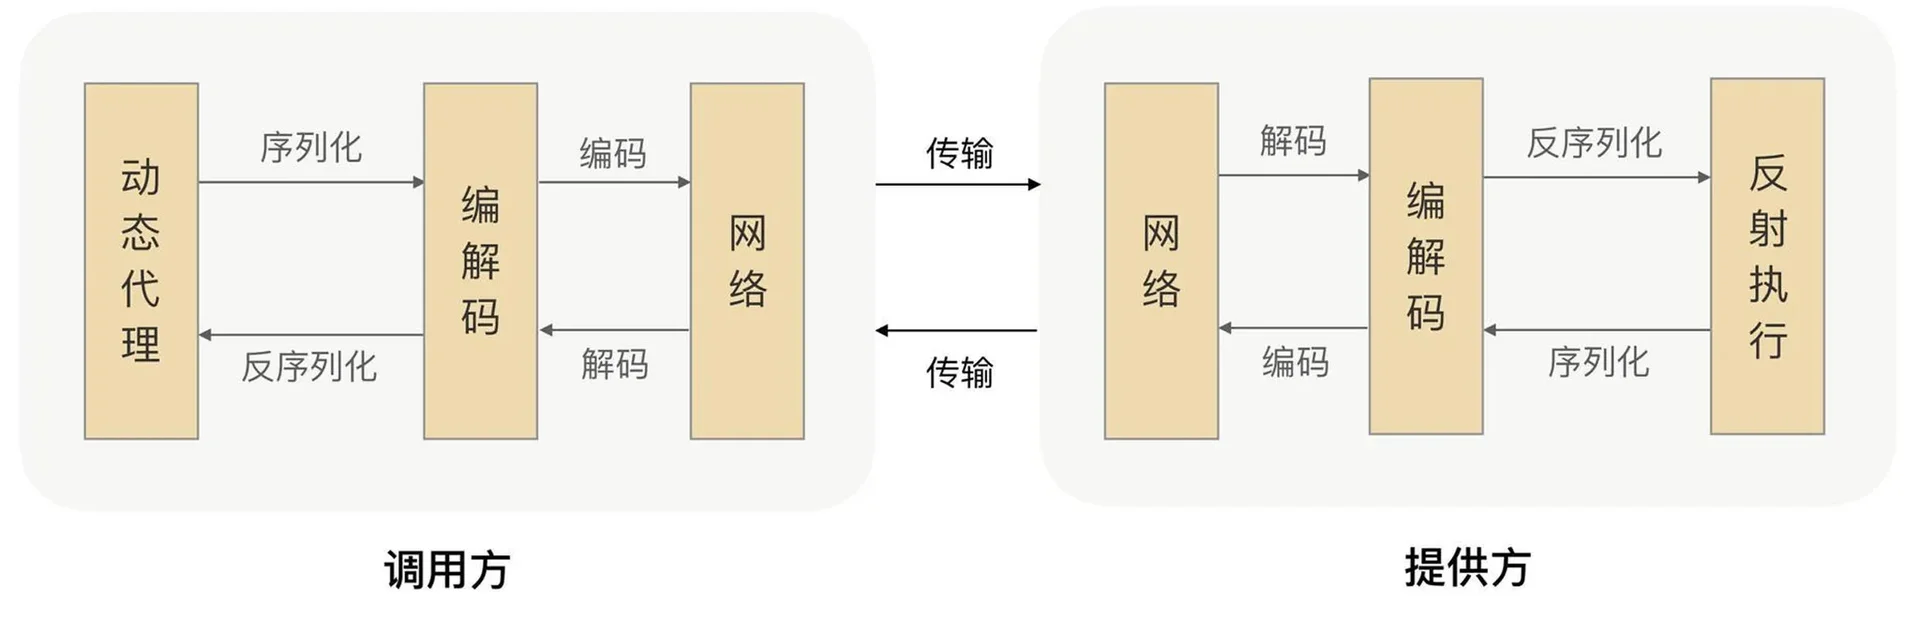
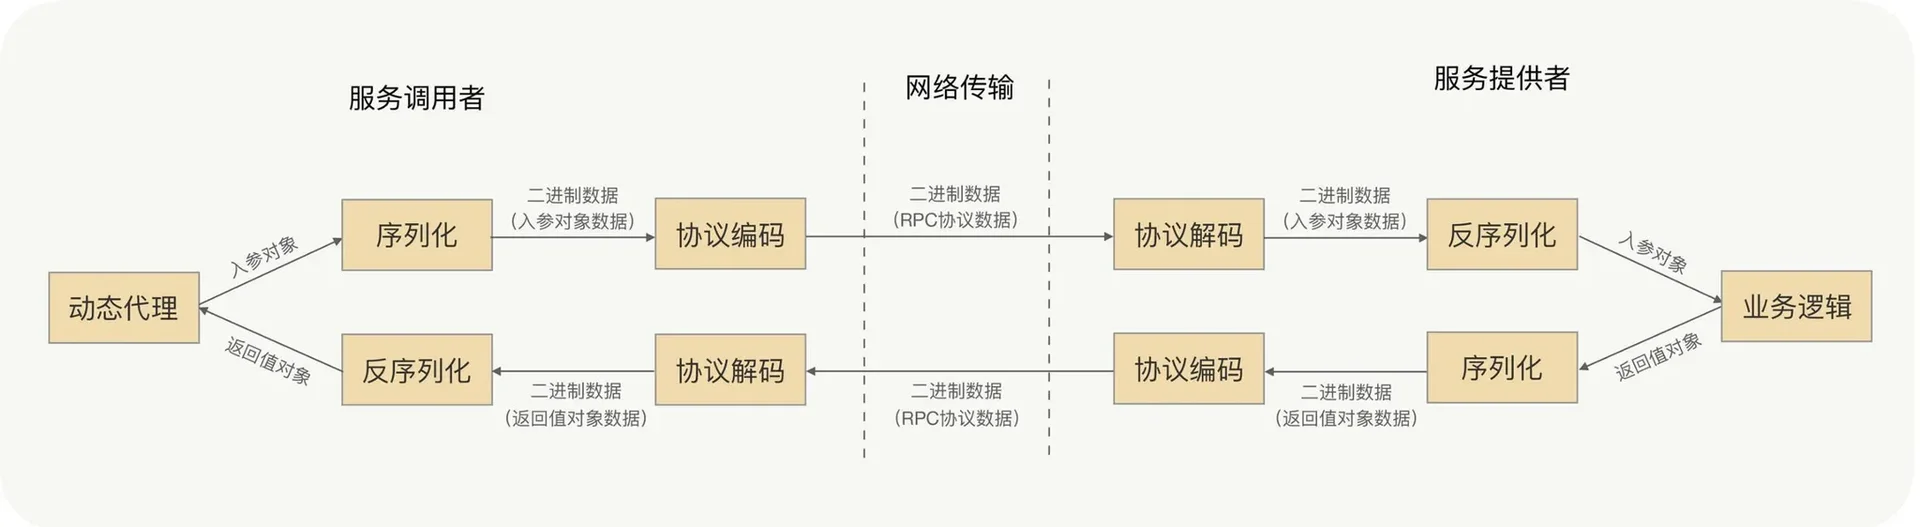
網路傳輸的資料必須是二進位資料,但呼叫方請求的出入參數都是物件。需要提前把它轉換成可傳輸的二進位資料,而且要求轉換演算法是可逆的。
資料的資料頭一般用於身份識別,包括協議標識、資料大小、請求型別、序列化型別等資訊;訊息體主要是請求的業務參數資訊和擴展屬性等。
反序列化
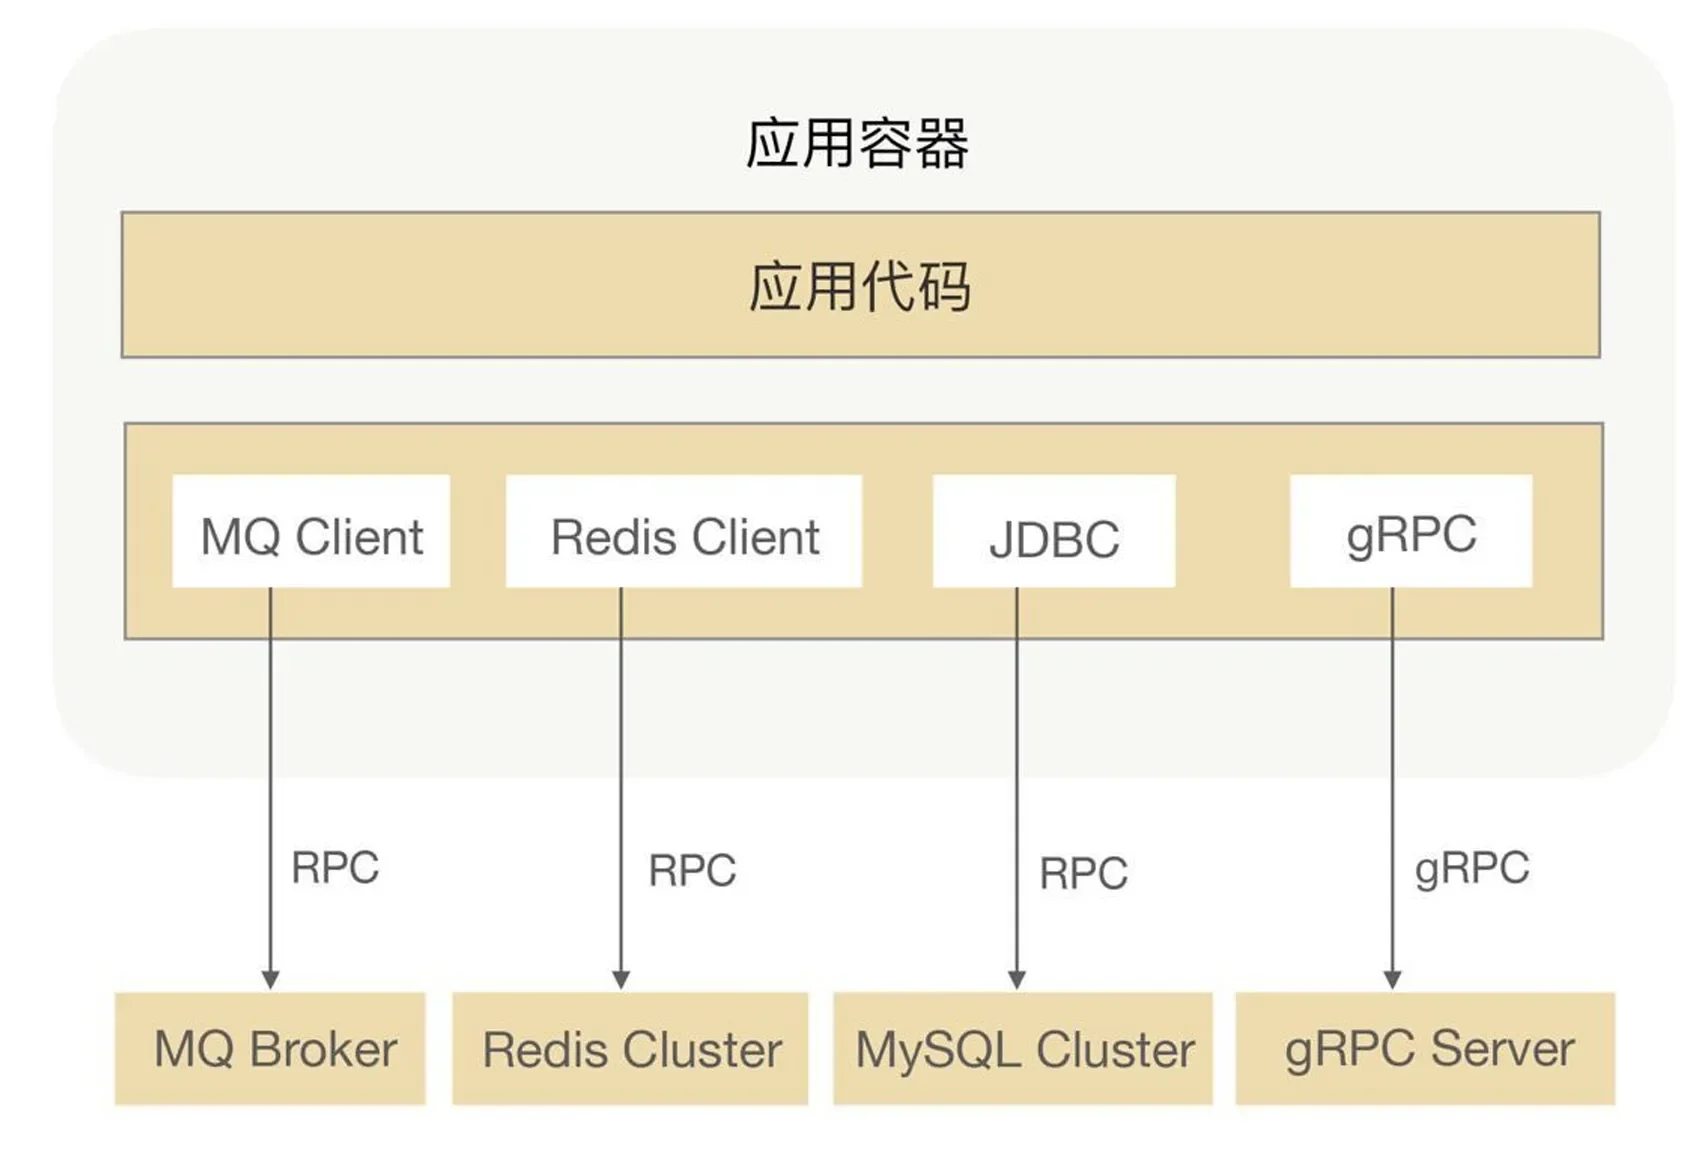
RPC不僅可以解決通訊問題,還可以發MQ、分散式快取、資料庫。
RPC和HTTP都屬於應用層協議。
RPC請求在傳送到網路中之前,他需要把方法呼叫的請求參數轉成二進位;轉成二進位後,寫入本地Socket中,然後被網卡傳送到網路裝置中。
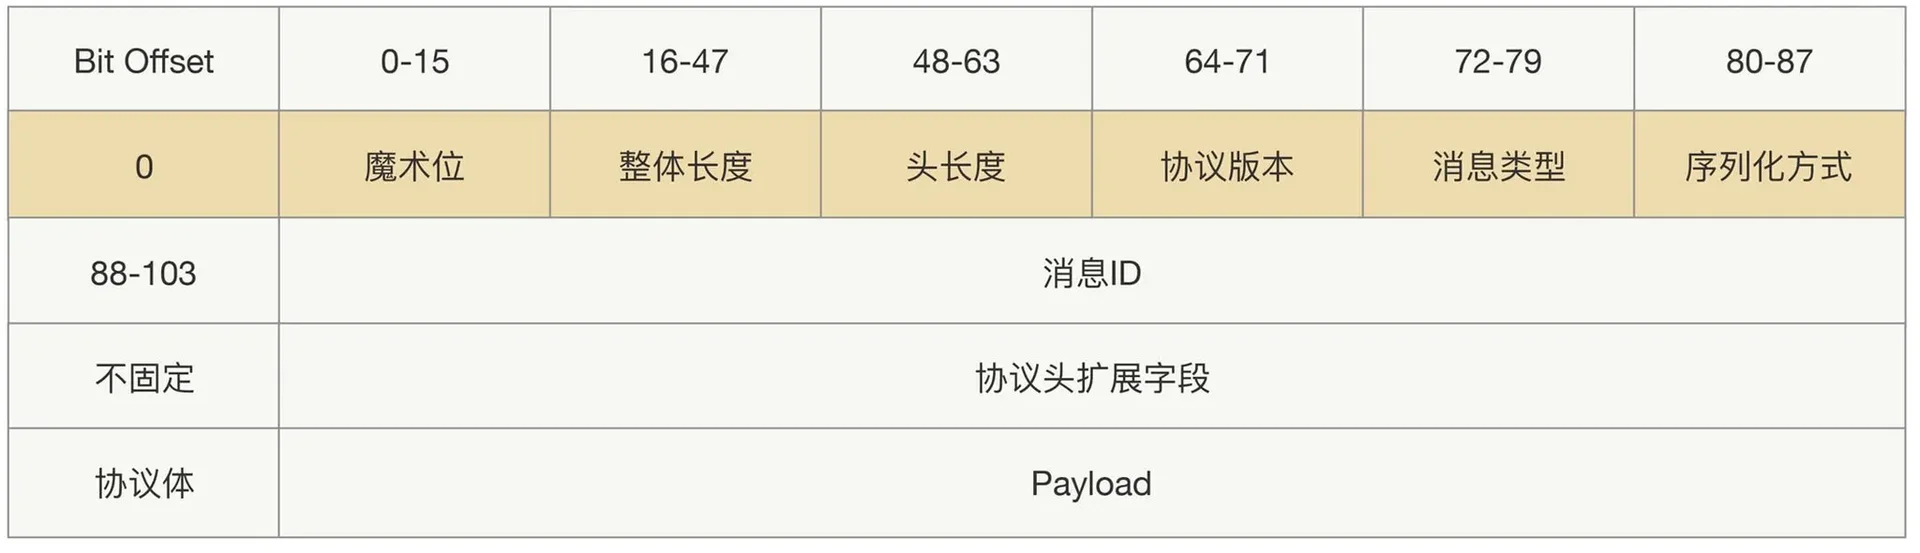
設計可擴展的、向後相容的協議,關鍵點就是利用好Header中的擴展欄位以及Payload中的擴展欄位,透過擴展欄位向後相容。
不同場景下合理選擇序列化方法。
常用的序列化方法:
- JDK原生序列化
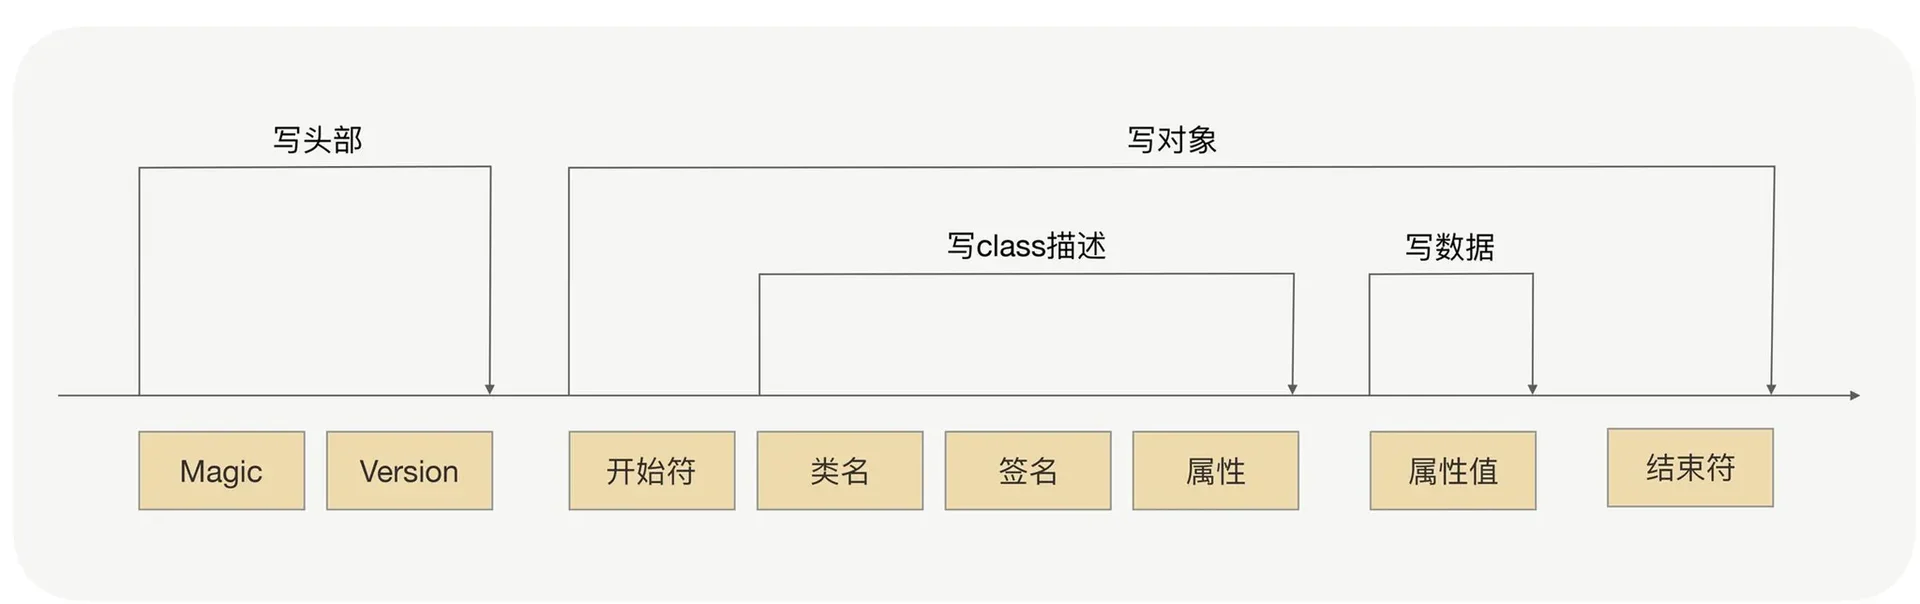
實際上任何一種序列化框架,核心思想就是設計一種序列化協議。
- JSON:典型的Key-Value方式,沒有資料型別,是一種文字型序列化框架。
但是JSON序列化有兩個問題:
- 額外空間開銷比較大,對於大資料量服務意味著巨大的記憶體和磁碟開銷;
- JSON沒有型別,但像Java這種強型別語言,需要透過反射統一解決,所以效能不好。
所以如果RPC框架選用JSON序列化,服務提供者與服務呼叫者之間傳輸的資料量要相對較小,否則將嚴重影響效能。
- Hessian:動態型別、二進位、緊湊的,並且可跨語言移植的一種序列化框架。Hessian協議要比JDK、JSON更緊湊,效能上要比JDK、JSON序列化高效很多,並且生成的位元組數也更少。
- 但是Hessian本身有問題,官方版本對Java裡面一些常見物件的型別不支援。
- Linked系列,LinkedHashMap、LinkedHashSet等,但可以透過擴展CollectionDeserializer類修復;
- Locale類,可以透過擴展ContextSerializerFactory類修復;
- Byte/Short反序列化的時候變成Integer
- 但是Hessian本身有問題,官方版本對Java裡面一些常見物件的型別不支援。
- Protobuf:Google公司內部的混合語言資料標準,結構化資料儲存格式,可以用於結構化資料序列化,支援Java、Python、C++、Go等語言。Protobuf使用的時候需要定義IDL(Interface description language),然後使用不同語言的IDL編譯器,生成序列化工具類,優點是
- 序列化後體積相比JSON、Hessian小很多;
- IDL能清晰的描述語義,所以足以幫助並保證應用程式之間的型別不會丟失,無需類似XML解析器;
- 序列化反序列化速度很快,不需要透過反射獲取型別;
- 訊息格式升級和相容性不錯,可以做到向後相容。
Protobuf不需要依賴IDL檔案,可以直接對Java領域物件進行反序列化操作,在效率上跟Protobuf差不多,生成的二進位格式和Protobuf是完全相同的,可以說是一個Java版本的Protobuf序列化框架。但在使用過程中,遇到過一些不支援的情況:
序列化協議還有Message Pack、kryo等。
影響選擇序列化工具的因素:
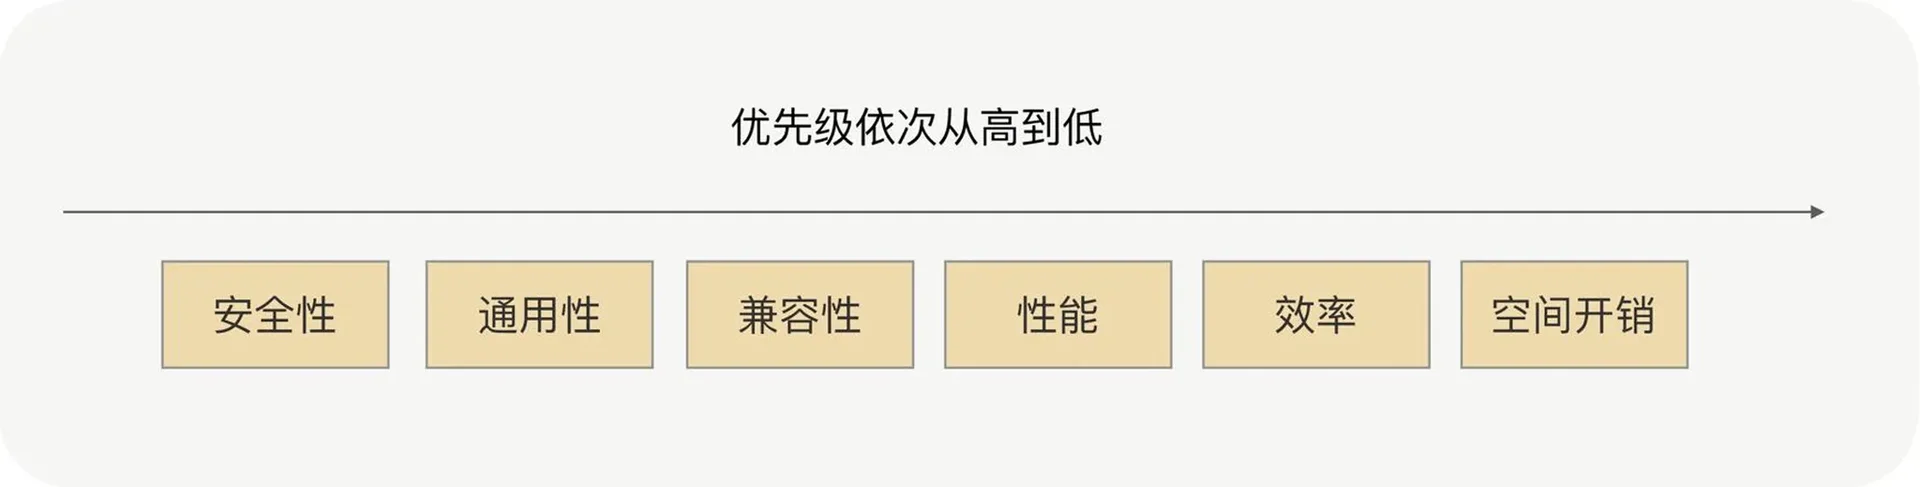
首選序列化協議還是Hessian與Protobuf,因為他們在效能、時間開銷、空間開銷、通用性、相容性和安全性上,都滿足了我們的要求。其中Hessian在使用上更加方便,在物件的相容性上更好;Protobuf則更加高效,通用性上更有優勢。
RPC框架在使用時需要注意哪些問題?
- 物件構造的過於複雜。屬性很多,並且存在多層巢狀。
- 物件過於龐大。
- 使用序列化框架不支援的類作為入參類。
- 物件有複雜的繼承關係。
RPC框架在網路通訊上更傾向於哪種網路IO模型?
常見的網路IO模型
- 同步阻塞IO(BIO)
- 同步非阻塞IO(NIO)
- IO多路複用
- 非同步非阻塞IO(AIO)
只有AIO為非同步IO,其他都是同步IO。
阻塞IO(blocking IO)是最簡單、最常見的IO模型。在Linux中,預設情況下所有的socket都是blocking的,先看下操作流程。
首先,應用程序發起IO系統呼叫後,應用程序被阻塞,轉到核心空間處理。然後,核心開始等待資料,等待到資料之後,再將核心中的資料複製到使用者記憶體中,整個IO處理完畢後返回程序。最後應用的程序解除阻塞狀態,執行業務邏輯。
系統核心處理IO操作分為兩個階段—等待資料和複製資料。而在這兩個階段中,應用程序中IO操作的執行緒會一直都處於阻塞狀態,如果是基於Java多執行緒開發,那麼每一個IO操作都要佔用執行緒,直至IO操作結束。
IO多路複用
多路複用IO是在高併發場景中使用最為廣泛的一種IO模型。如Java的NIO、Redis、Nginx的底層實現就是此類IO模型的應用,經典的Reactor模式也是基於此類IO模型。
多個網路連線的IO可以註冊到一個複用器(select)上,當使用者程序呼叫了select,那麼整個程序會被阻塞。同時,核心會“監視”所有select負責的socket,當任何一個socket中的資料準備好了,select就會返回。這個時候使用者程序再呼叫read操作,將資料從核心中複製到使用者程序。
這裡我們可以看到,當使用者程序發起了select呼叫,程序會被阻塞,當發現該select負責的socket有準備好的資料時才返回,之後才發起一次read,整個流程要比阻塞IO要複雜,似乎也更浪費效能。但它最大的優勢在於,使用者可以在一個執行緒內同時處理多個socket的IO請求。使用者可以註冊多個socket,然後不斷的呼叫select讀取被啟用的socket,即可達到在同一個執行緒內同時處理多個IO請求的目的。而在同步阻塞模型中,必須透過多執行緒的方式才能達到這個目的。
為什麼說阻塞IO和IO多路複用最常見?
實際在網路IO的應用上,需要的是系統核心的支援以及程式語言的支援。
在系統核心的支援上,現在大多數系統都會支援阻塞IO、非阻塞IO和IO多路複用,但像訊號驅動IO、非同步IO,只有高版本的Linux系統才會支援。
在程式語言上,無論是C++還是Java,在高效能的網路程式設計框架的編寫上,大多數都是基於Reactor模式,其中最為典型的便是Java的Netty框架,而Reactor模式是基於IO多路複用的。當然,在非高發場景下,同步阻塞IO是最為常見的。
RPC框架在網路通訊上傾向於選擇哪種網路IO模型?
RPC呼叫在大多數情況下,是一個高併發呼叫的場景,考慮到系統核心的支援、程式語言的支援以及IO模型本身的特點,在RPC框架的實現中,在網路通訊的處理上,我們會選擇IO多路複用的方式。開發語言的網路通訊框架選型上,最優的選擇是基於Reactor模式實現的框架,如Java語言,首選框架便是Netty框架(Java還有很多其他NIO框架,但目前Netty應用的最為廣泛),並且在Linux環境下,也要開啟epoll來提升系統效能(Windows環境下是無法開啟epoll的,因為系統核心不支援)。
什麼是基於Reactor模式的網路IO模型?
基於Reactor模式的網路IO模型是一種事件驅動的高效能網路程式設計模型,透過將I/O事件的監聽、分發與業務邏輯處理解耦,實現對高併發連線的統一管理和高效響應。其核心是透過多路複用技術(如Select、epoll、kqueue)監控多個連線事件,並基於事件型別分發給對應的處理器,避免了傳統阻塞式IO的執行緒資源浪費。
核心元件:
- Reactor(反應器):負責監聽所有I/O事件,並透過事件迴圈(Event Loop)將就緒事件分發給對應的處理器。它是整個模型的中樞,通常在一個獨立執行緒中執行。使用多路複用器(如Selector)輪詢註冊Channel,檢測連線、讀、寫等事件。
- Acceptor(連線處理器):專門處理連線建立事件,接收客戶端連線請求,並將新建立的SocketChannel註冊到Reactor中,後續監聽其讀/寫事件。
- Handler(事件處理器):處理具體的業務邏輯(如資料讀取、處理、寫回),通常為:
讀處理器:處理讀就緒事件,從Channel讀取資料並解碼。寫處理器:處理寫就緒事件,將處理結果編碼後寫回客戶端。業務處理器:執行計算、資料庫操作等耗時任務,可能由執行緒池非同步處理。
零複製 zero copy
系統核心處理IO操作分為兩個階段—等待資料和複製資料。等待資料,就是系統核心在等待網卡接收到資料後,把資料寫到核心中;而複製資料,就是系統核心在獲取到資料後,將資料複製到使用者程序的空間中。
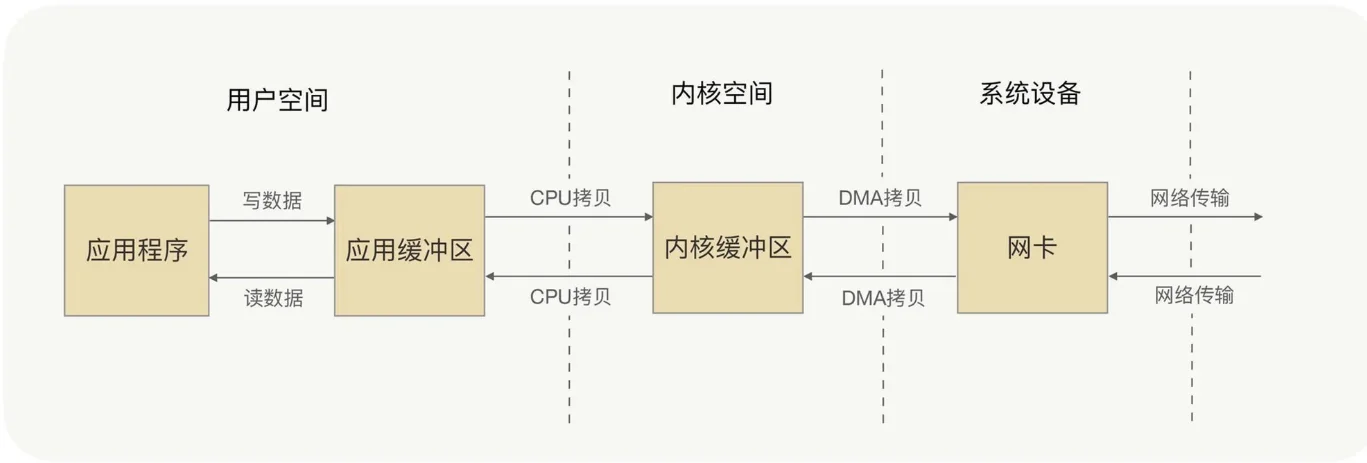
應用程序的每一次寫操作,都會把資料寫到使用者空間的緩衝區中,再由CPU將資料複製到系統核心的緩衝區中,之後再由DMA將這份資料複製到網卡中,最後由網卡傳送出去。這裡我們可以看到,一次寫運算元據要複製兩次才能透過網卡傳送出去,而使用者程序的讀操作則是將整個流程反過來,資料同樣會複製兩次才能讓應用程式讀取到資料。
應用程序的一次完整的讀寫操作,都需要在使用者空間與核心空間中來回複製,並且每一次複製,都需要CPU進行一次上下文切換(由使用者程序切換到系統核心,或由系統核心切換到使用者程序)。
零複製技術
零複製,就是取消使用者空間與核心空間之間的資料複製操作,應用程序每一次的讀寫操作,都可以透過一種方式,讓應用程序向使用者空間寫入或者讀取資料,就如同直接向核心空間寫入或者讀取資料一樣,再透過DMA將核心中的資料複製到網卡,或將網卡中的資料copy到核心。
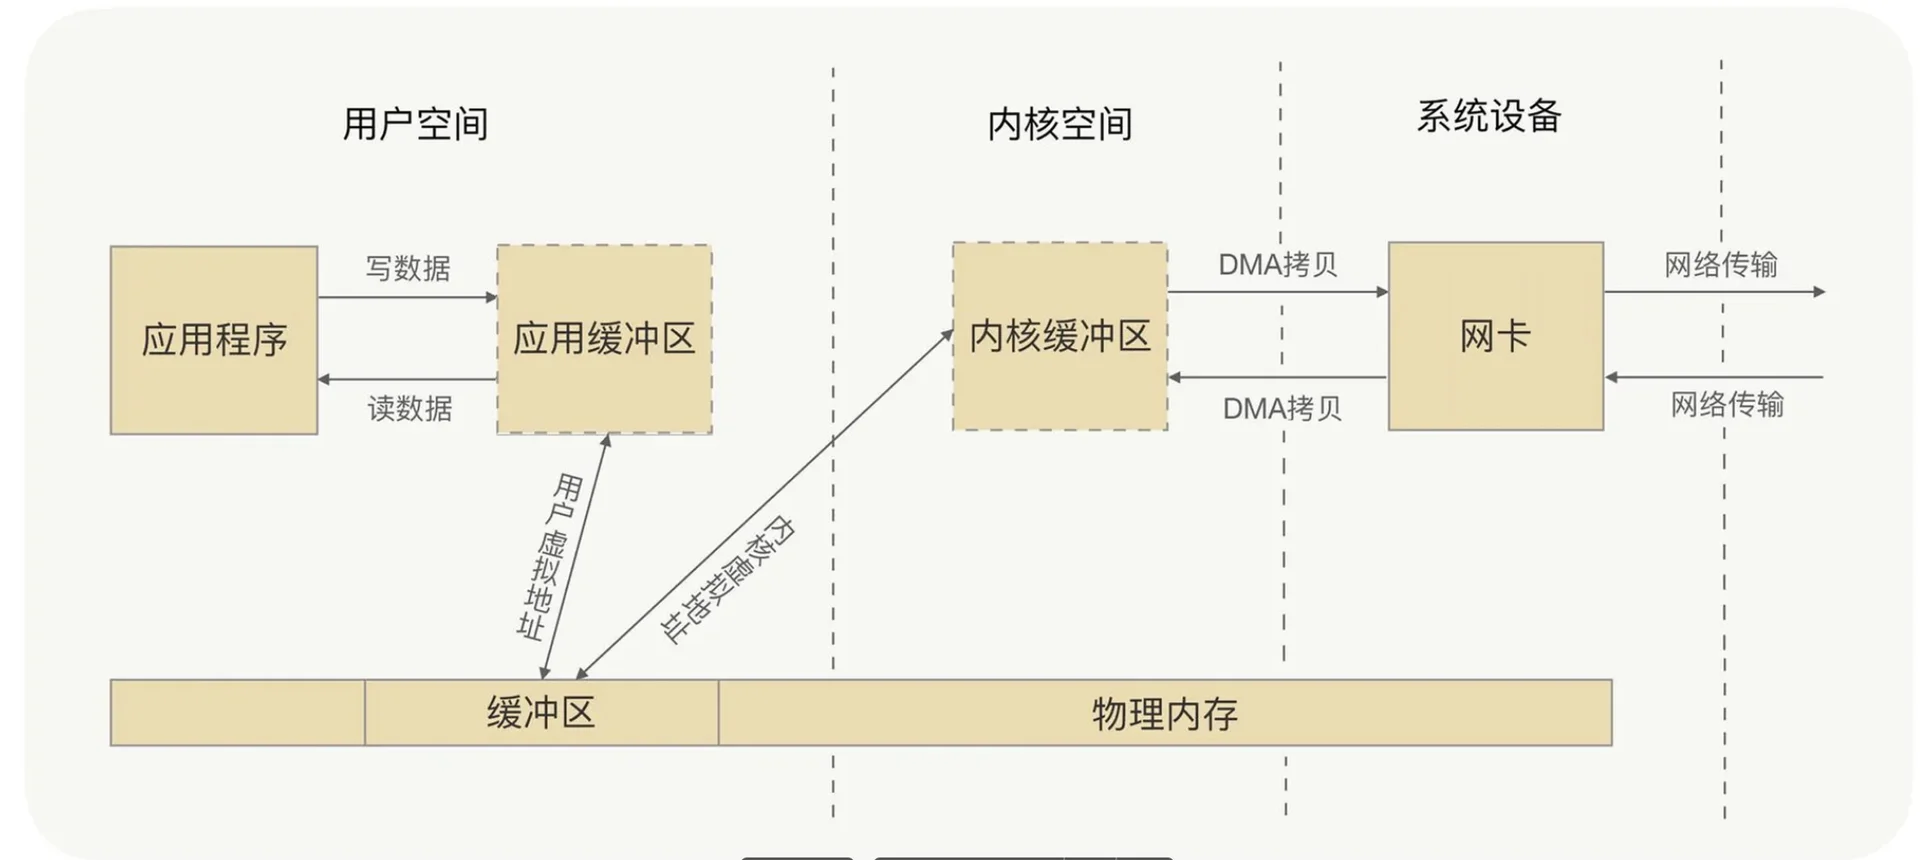
零複製有兩種解決方案
- mmap+write方式:核心原理是透過虛擬記憶體解決。
- sendfile方式
mmap+write
實現原理:
- 記憶體對映機制:透過mmap系統呼叫將核心讀緩衝區直接對映到使用者程序的虛擬地址空間,實現核心與使用者空間的共享記憶體。此過程無需將資料從核心緩衝區複製到使用者緩衝區,僅建立地址對映關係。
資料傳輸流程:
- 第一次複製(DMA):磁碟資料透過DMA直接傳輸到核心讀緩衝區。
共享對映:使用者透過虛擬記憶體對映訪問核心緩衝區資料。
- 第二次複製(CPU):呼叫write時,CPU將核心讀緩衝區的資料複製到核心Socket緩衝區。
- 第三次複製(DMA):DMA將Socket緩衝區的資料傳送到網卡。
優勢與侷限:
優點:
- 減少一次CPU複製(核心→使用者緩衝區的複製被消除)。
- 允許應用程式直接操作對映記憶體,適合需要對資料進行預處理(如修改、壓縮)的場景。
缺點:
- 仍存在4次上下文切換(兩次系統呼叫)和3次資料複製。
- 維護記憶體對映需要額外開銷,可能因檔案被截斷導致異常(如SIGBUS訊號)。
sendfile
sendfile方式將read和write合併為一次系統呼叫,直接在核心空間完成資料傳輸。
資料傳輸流程(分兩種模式)
基礎模式(無SG-DMA支援):
- 第一次複製(DMA):磁碟→核心讀緩衝區。
- 第二次複製(CPU):核心讀緩衝區→核心Socket緩衝區。
- 第三次複製(DMA):Socket緩衝區→網卡。
SG-DMA最佳化模式:
僅需兩次DMA複製:核心讀緩衝區直接透過DMA Scatter/Gather技術傳輸到網卡,無需CPU參與Socket緩衝區複製。
優點:
- 系統呼叫次數減少到1次,上下文切換僅2次。
- 在支援SG-DMA的硬體下實現真正的零複製(僅兩次DMA複製)。
- 吞吐量提升顯著,適合大檔案傳輸。
缺點:
- 資料對使用者空間完全不可見,無法在傳輸前處理資料。
- 依賴作業系統和硬體支援。
若需資料預處理(如修改檔案內容),選擇mmap+write。
若僅需高效傳輸且無需處理資料,優先使用sendfile(尤其支援SG-DMA環境)。
Netty中的零複製
完全站在了使用者空間上,也就是JVM上,它的零複製技術主要是偏向於資料操作的最佳化上。
- Netty提供了CompositeByteBuf類,它可以將多個ByteBuf合併為一個邏輯上的Bytebuf,避免了各個Bytebuf之間的複製。
- ByteBuf支援slice操作,因此可以將ByteBuf分解為多個共享同一個儲存區域的Bytebuf,避免了記憶體的複製。
- 透過wrap操作,我們可以將byte[]陣列、ByteBuf、ByteBuffer等包裝成一個Netty ByteBuf物件,進而避免複製操作。
Netty還提供FileRegion中包裝NIO的FileChannel.transferTo()方法實現了零複製,這與Linux中的sendfile方式在原理上也是一樣的。
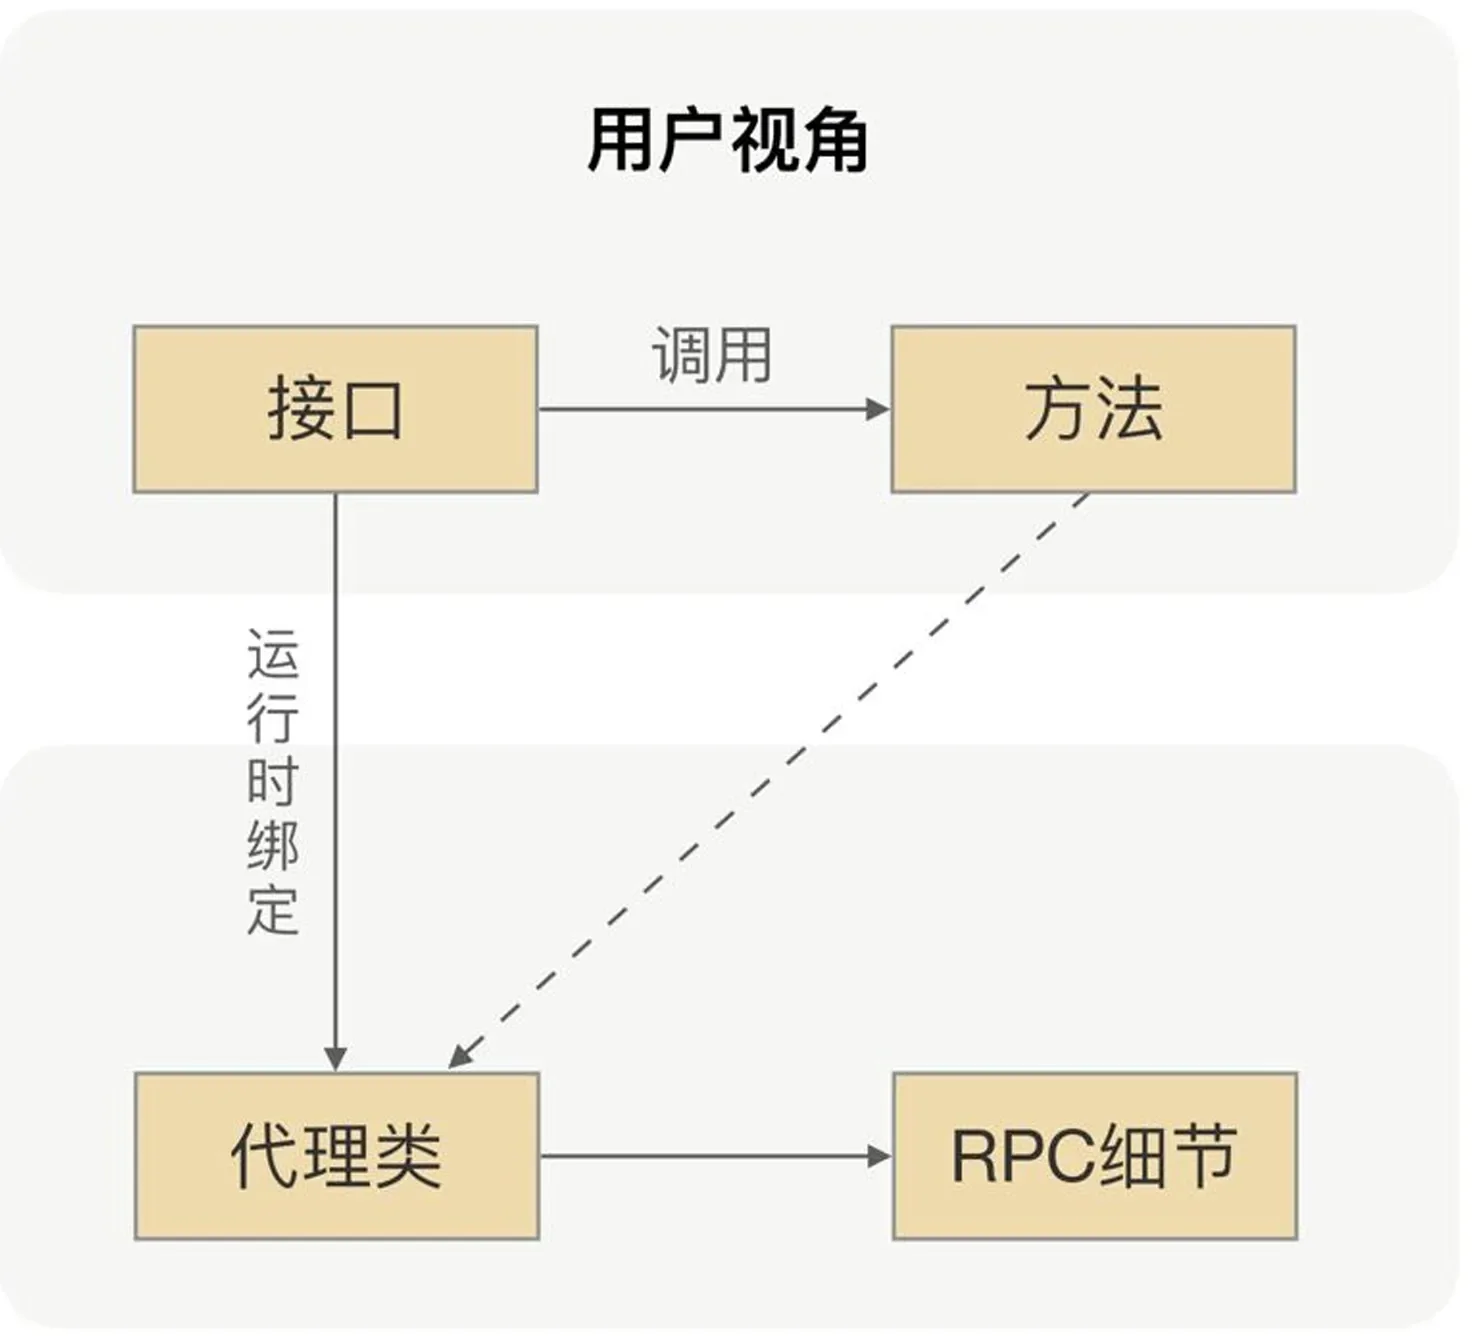
動態代理:面向介面程式設計,遮蔽RPC處理流程(這個沒有看過程式碼說實話不是特別清楚)
關於網路通訊,只要記住—可靠的傳輸。
RPC會自動給介面生成一個代理類,當我們在專案中注入介面的時候,執行過程中實際繫結的是這個介面生成的代理類。這樣在介面方法被呼叫的時候,它實際上是被生成代理類攔截到了,這樣我們就可以在生成的代理類裡面,加入遠端呼叫邏輯。
- 代理類是在執行中生成的,那麼代理框架生成生成代理類的速度、生成代理類的位元組碼大小等等,都會影響到效能—生成的位元組碼越小,執行所佔資源就越小。
- 我們生成的代理類,是用於介面方法請求攔截的,所以每次呼叫介面方法的時候,都會執行生成的代理類,這時生成的代理類的執行效率就需要很高效。
- 我們希望選擇一個使用起來方便的代理類框架。API設計是否好理解、社群活躍度、還有就是依賴複雜度。
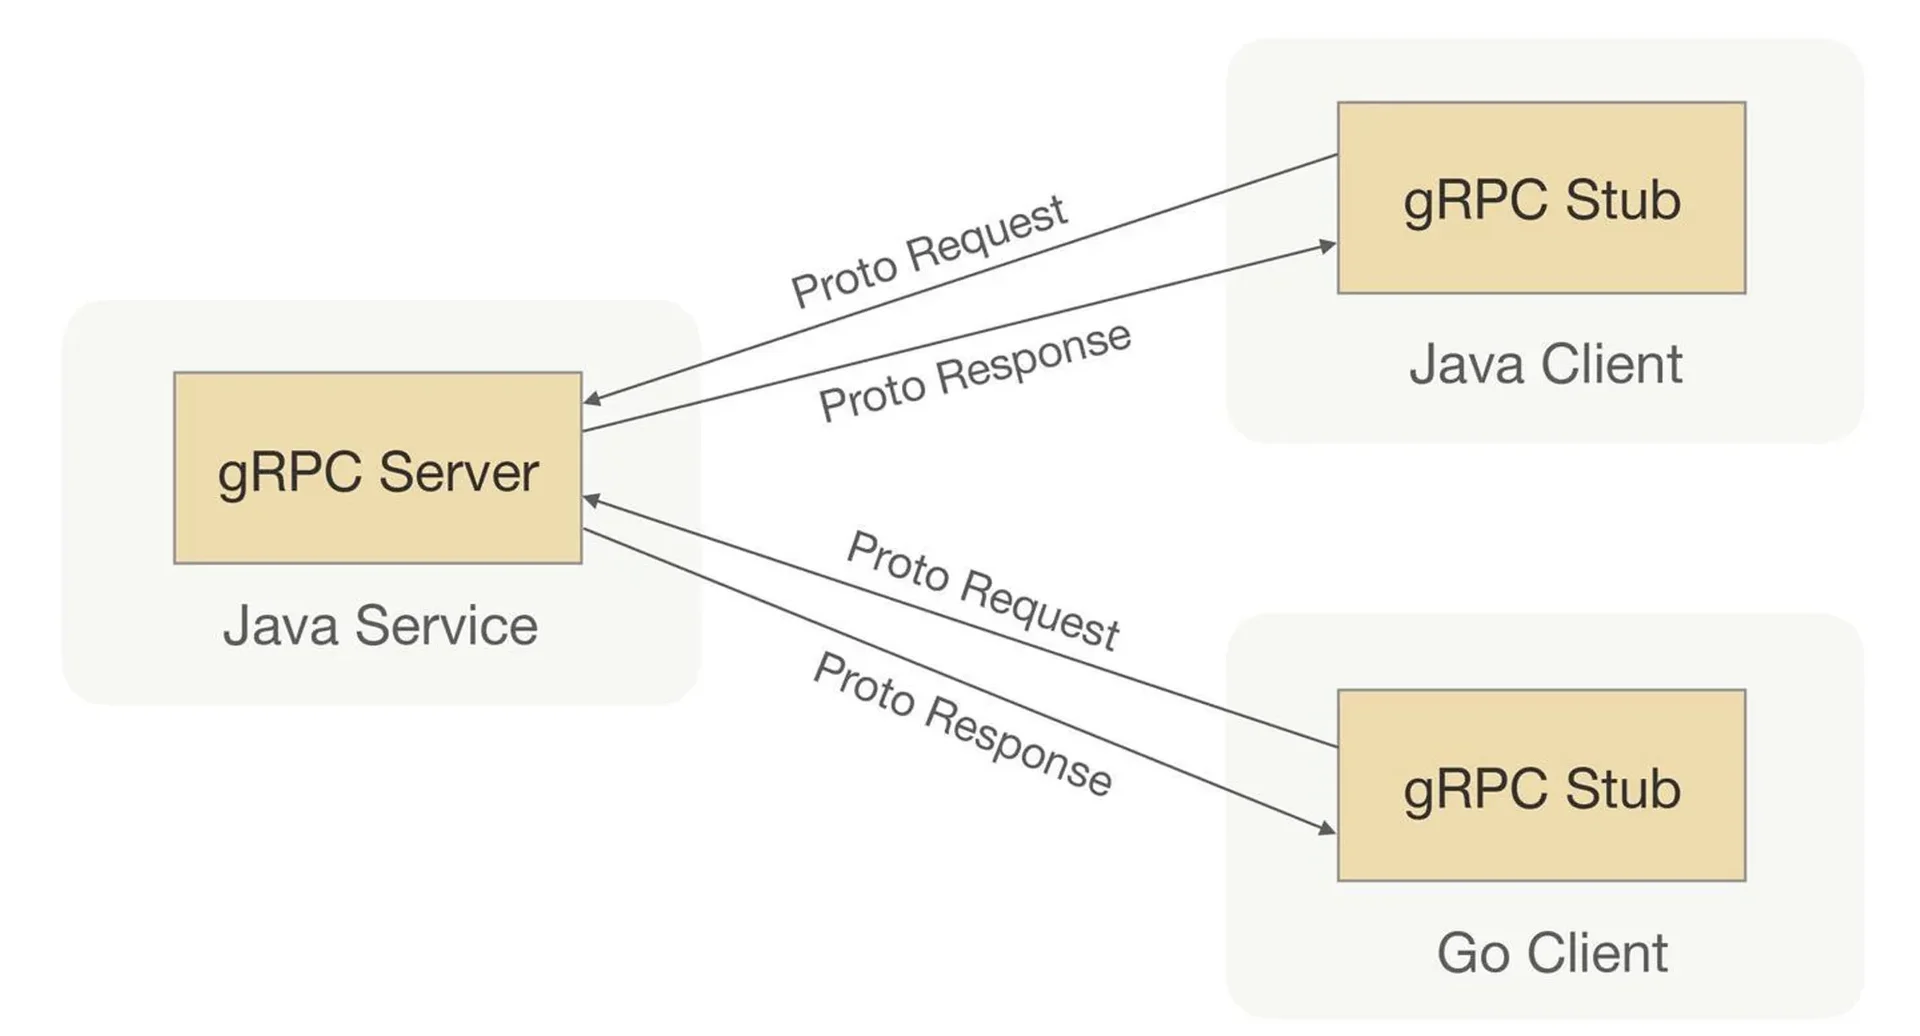
gRPC
協議封裝
我們需要在方法呼叫參數的二進位資料後面增加“斷句”符號來分隔出不同的請求,在兩個“斷句”符號中間放的內容就是我們請求的二進位資料,這個過程叫做協議封裝。
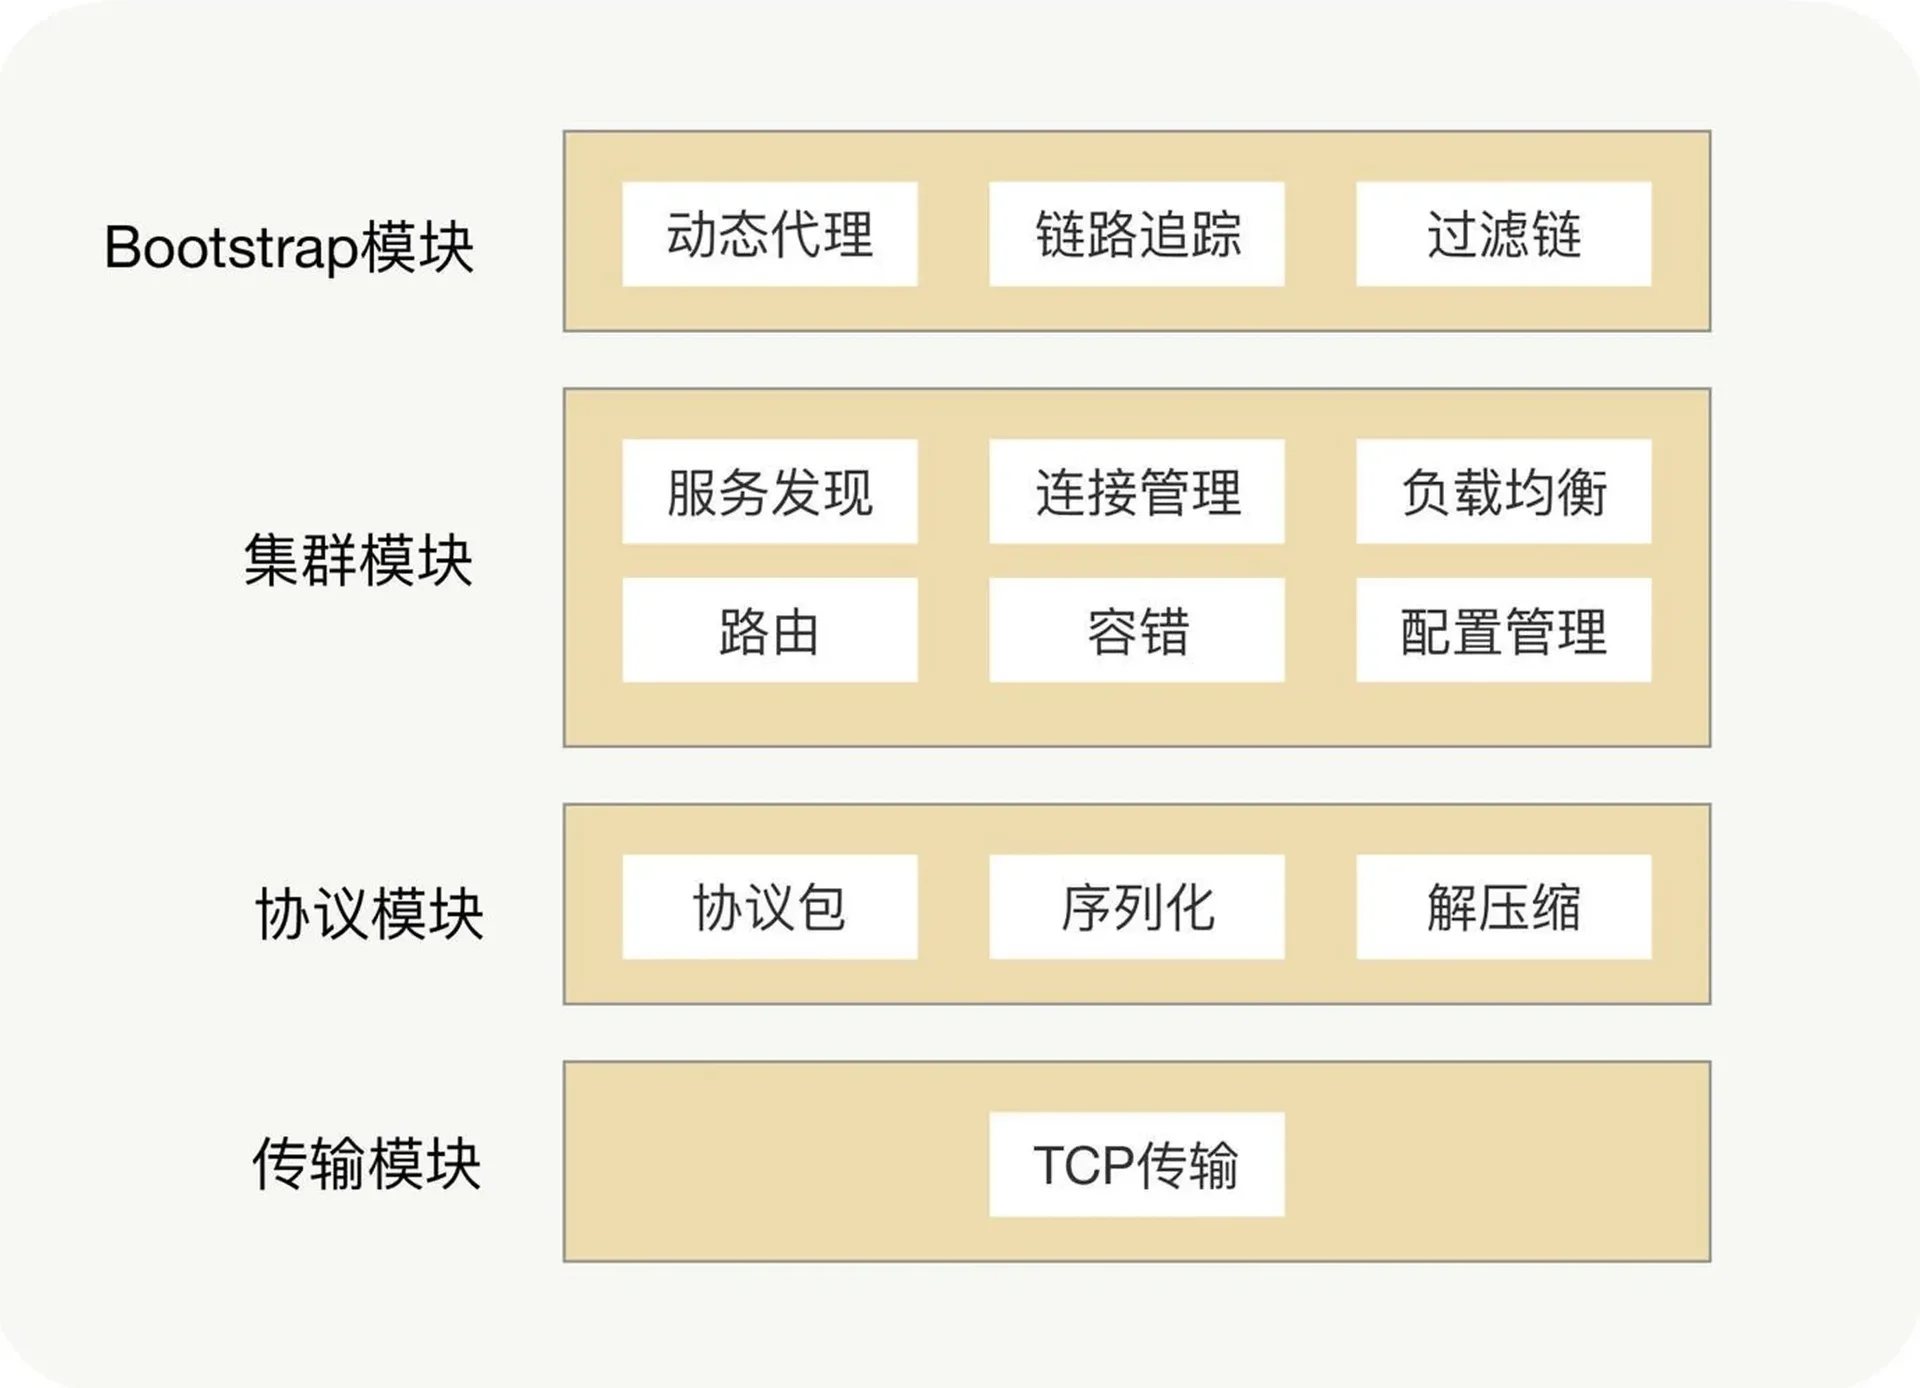
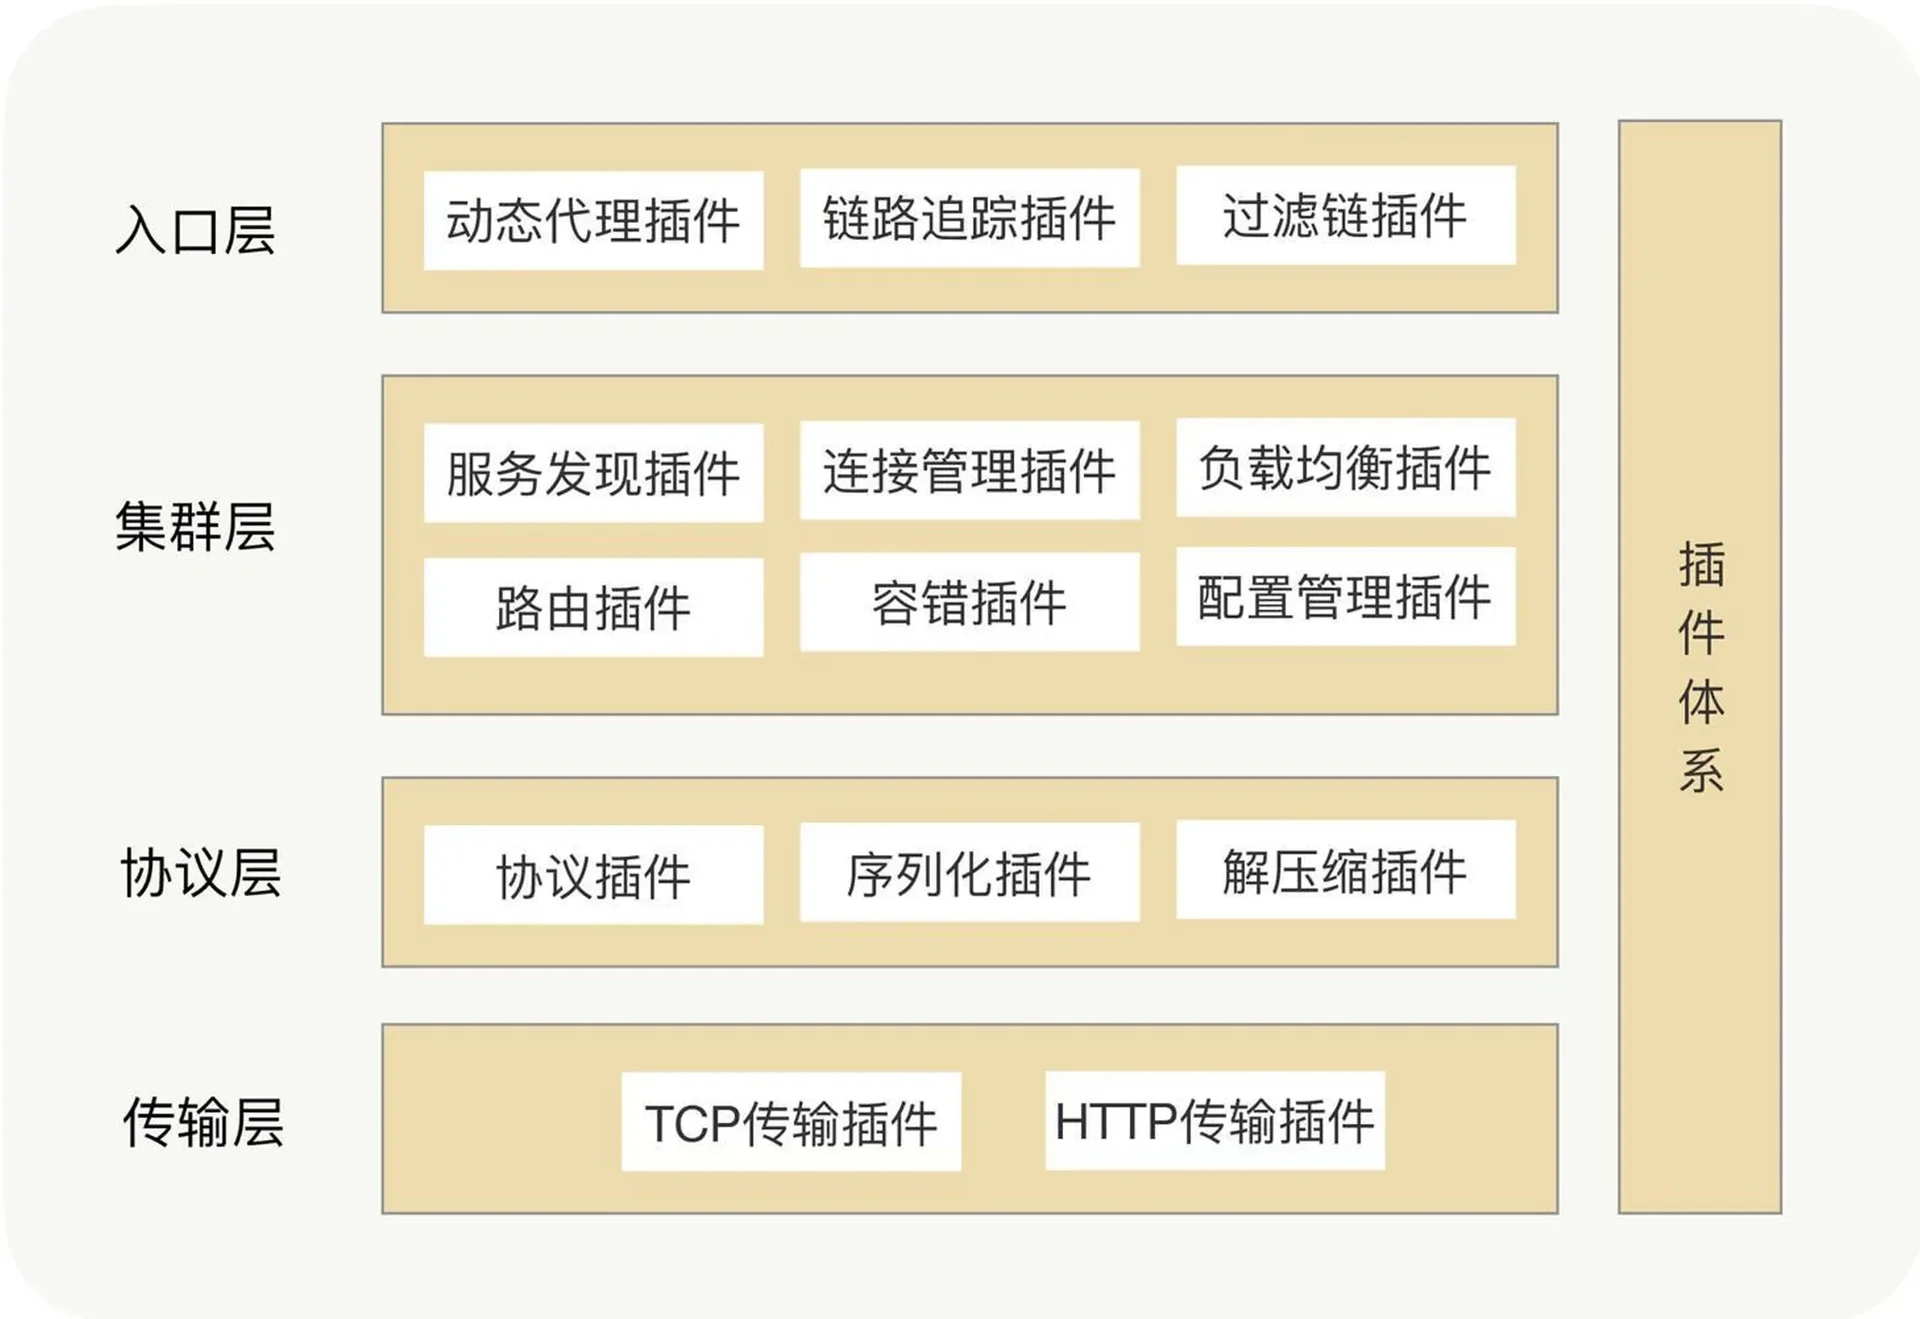
服務發現:到底是要CP還是AP?
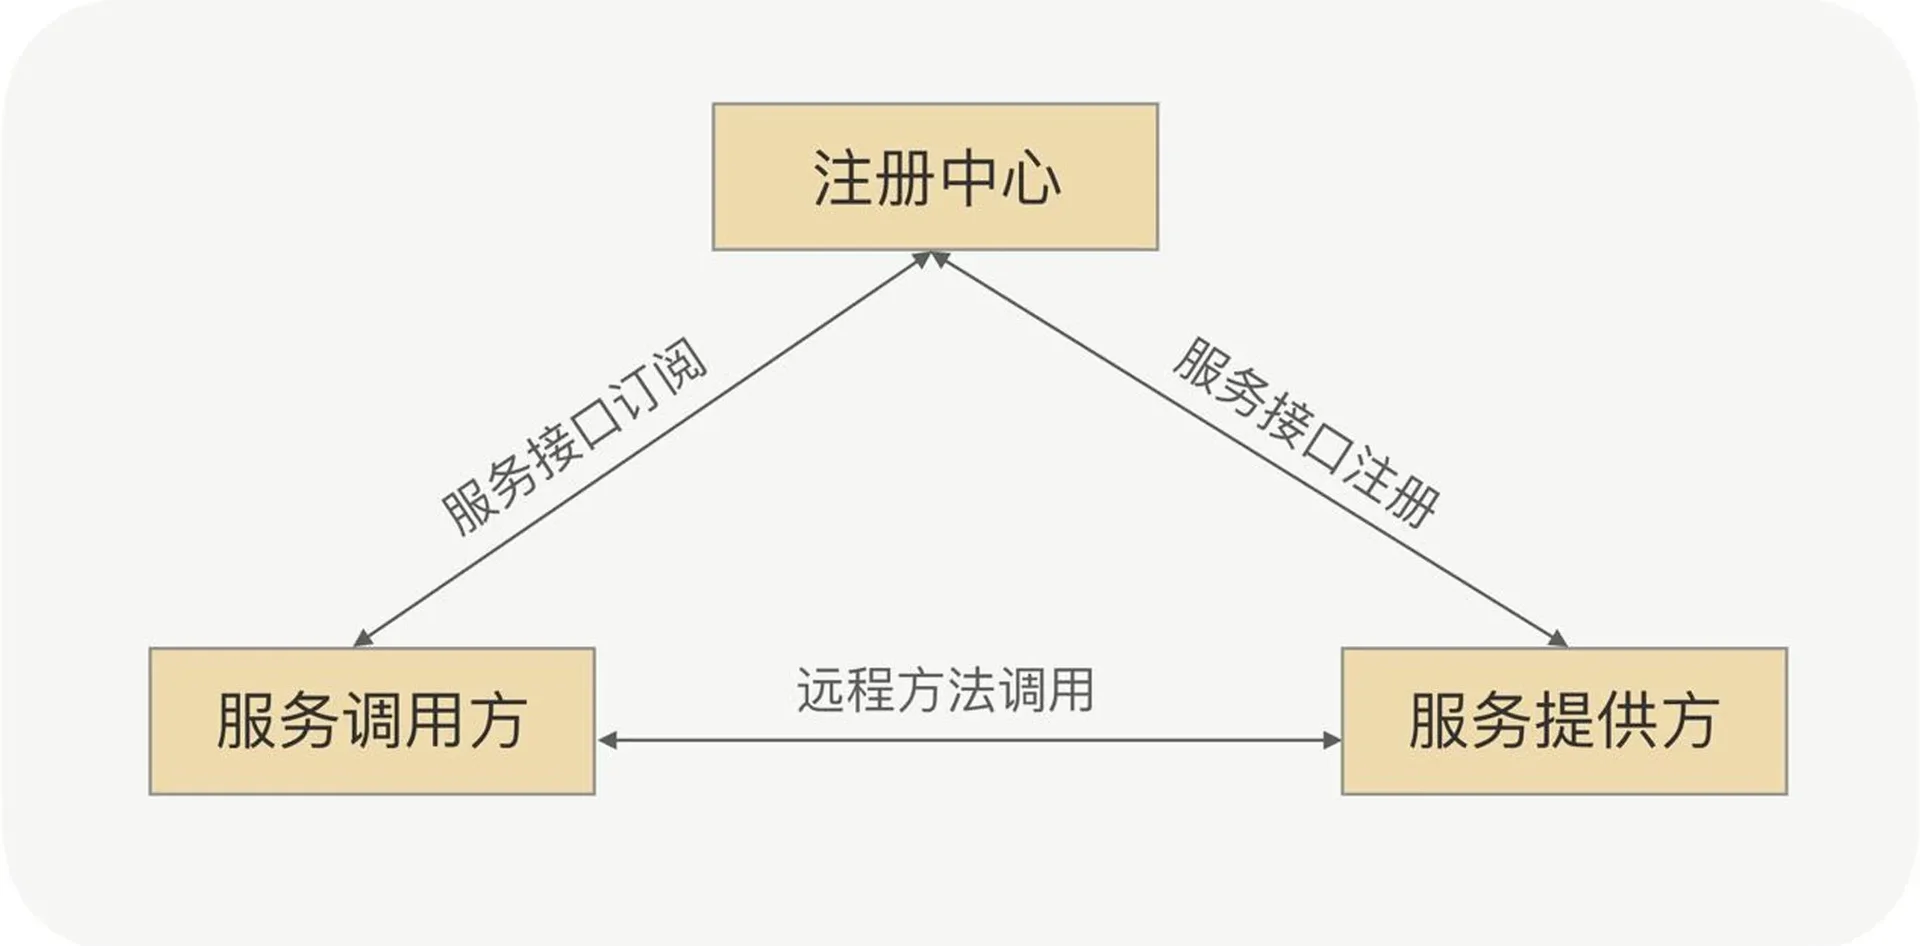
- 服務註冊:在服務提供方啟動的時候,將對外暴露的介面註冊到註冊中心中,註冊中心將這個服務節點的IP和介面儲存下來。
- 服務訂閱:在服務呼叫方啟動的時候,去註冊中心查詢並訂閱服務提供方的IP,然後快取到本地,並用於後續的遠端呼叫。
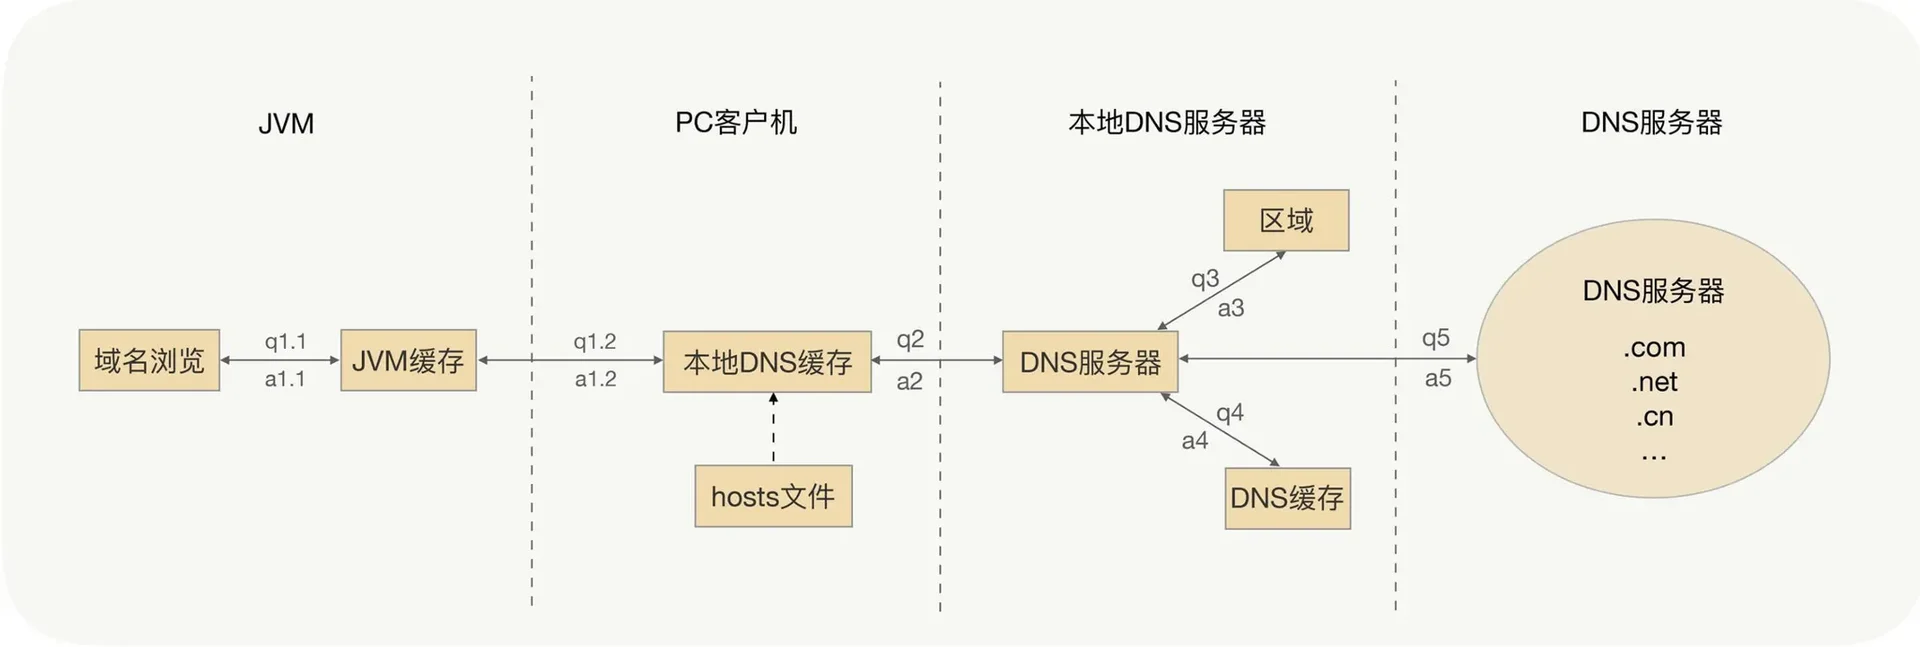
如果使用DNS來進行服務發現:
如果我們用DNS來實現服務發現,所有的服務提供者節點都配置在了同一個域名下,呼叫方的確可以透過DNS拿到隨機的一個服務提供者的IP,並與之建立長連線,看上去沒有問題,但是需要考慮以下情況:
- 如果IP埠下線,服務呼叫者能否及時摘除服務節點?
- 如果在之前已經上線了一部分服務節點,這時突然對服務進行擴容,那麼新上線的服務節點能否及時接收流量?
答案都是“不能”。這是因為為了提升效能和減少DNS服務的壓力,DNS採取了多級快取機制,一般配置的快取時間較長。
基於ZooKeeper的服務發現
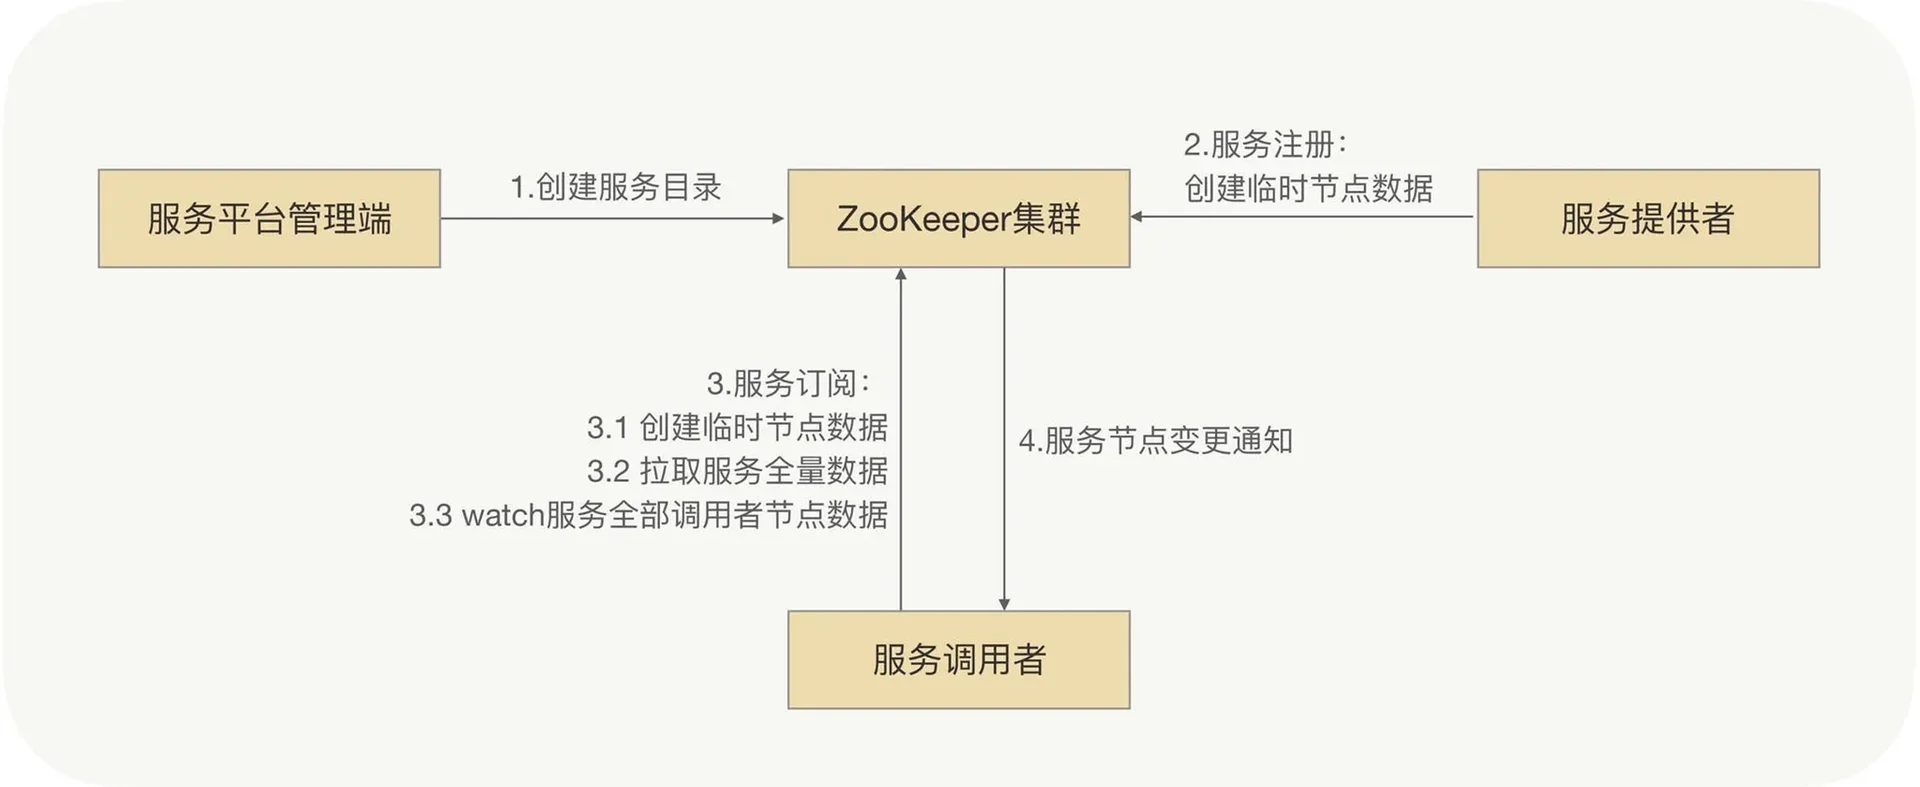
- 服務平臺管理端先在ZooKeeper中建立一個服務根路徑,可以根據介面名命名(例如:/service/com.demo.xxService),在這個路徑再建立服務提供方目錄與服務呼叫方目錄(例如:provider、consumer),分別用來儲存服務提供方的節點資訊和服務呼叫方的節點資訊。
- 當服務提供方發起註冊時,會在服務提供方目錄建立一個臨時節點,節點中儲存該服務提供方的註冊資訊。
- 當服務呼叫方發起訂閱時,則在服務呼叫方目錄中建立一個臨時節點,節點中儲存該服務呼叫方的資訊,同時服務調起方watch該服務的服務提供方目錄(/service/com.demo.xxService/provider)中所有的服務節點資料。
- 當服務提供方目錄下有節點資料發起變更時,ZooKeeper就會通知給發起訂閱的服務呼叫方。
基於訊息匯流排的最終一致性的註冊中心
ZooKeeper的一大特點就是強一致性,ZooKeeper叢集的每個節點的資料每次發生更新操作,都會通知其它ZooKeeper節點同時執行更新。它要求保證每個節點的資料能夠實時的完全一致,這也就直接導致了ZooKeeper叢集效能上的下降。
而RPC框架的服務發現,在服務節點剛上線時,服務呼叫方是可以容忍在一段時間之後(比如幾秒鐘之後)發現這個新上線的節點的。畢竟服務節點剛上線之後的幾秒內,甚至更長的一段時間內沒有接收到請求流量,對整個服務叢集是沒有什麼影響的,所以我們可以犧牲掉CP(強制一致性),而選擇AP(最終一致),來換取整個註冊中心叢集的效能和穩定性。
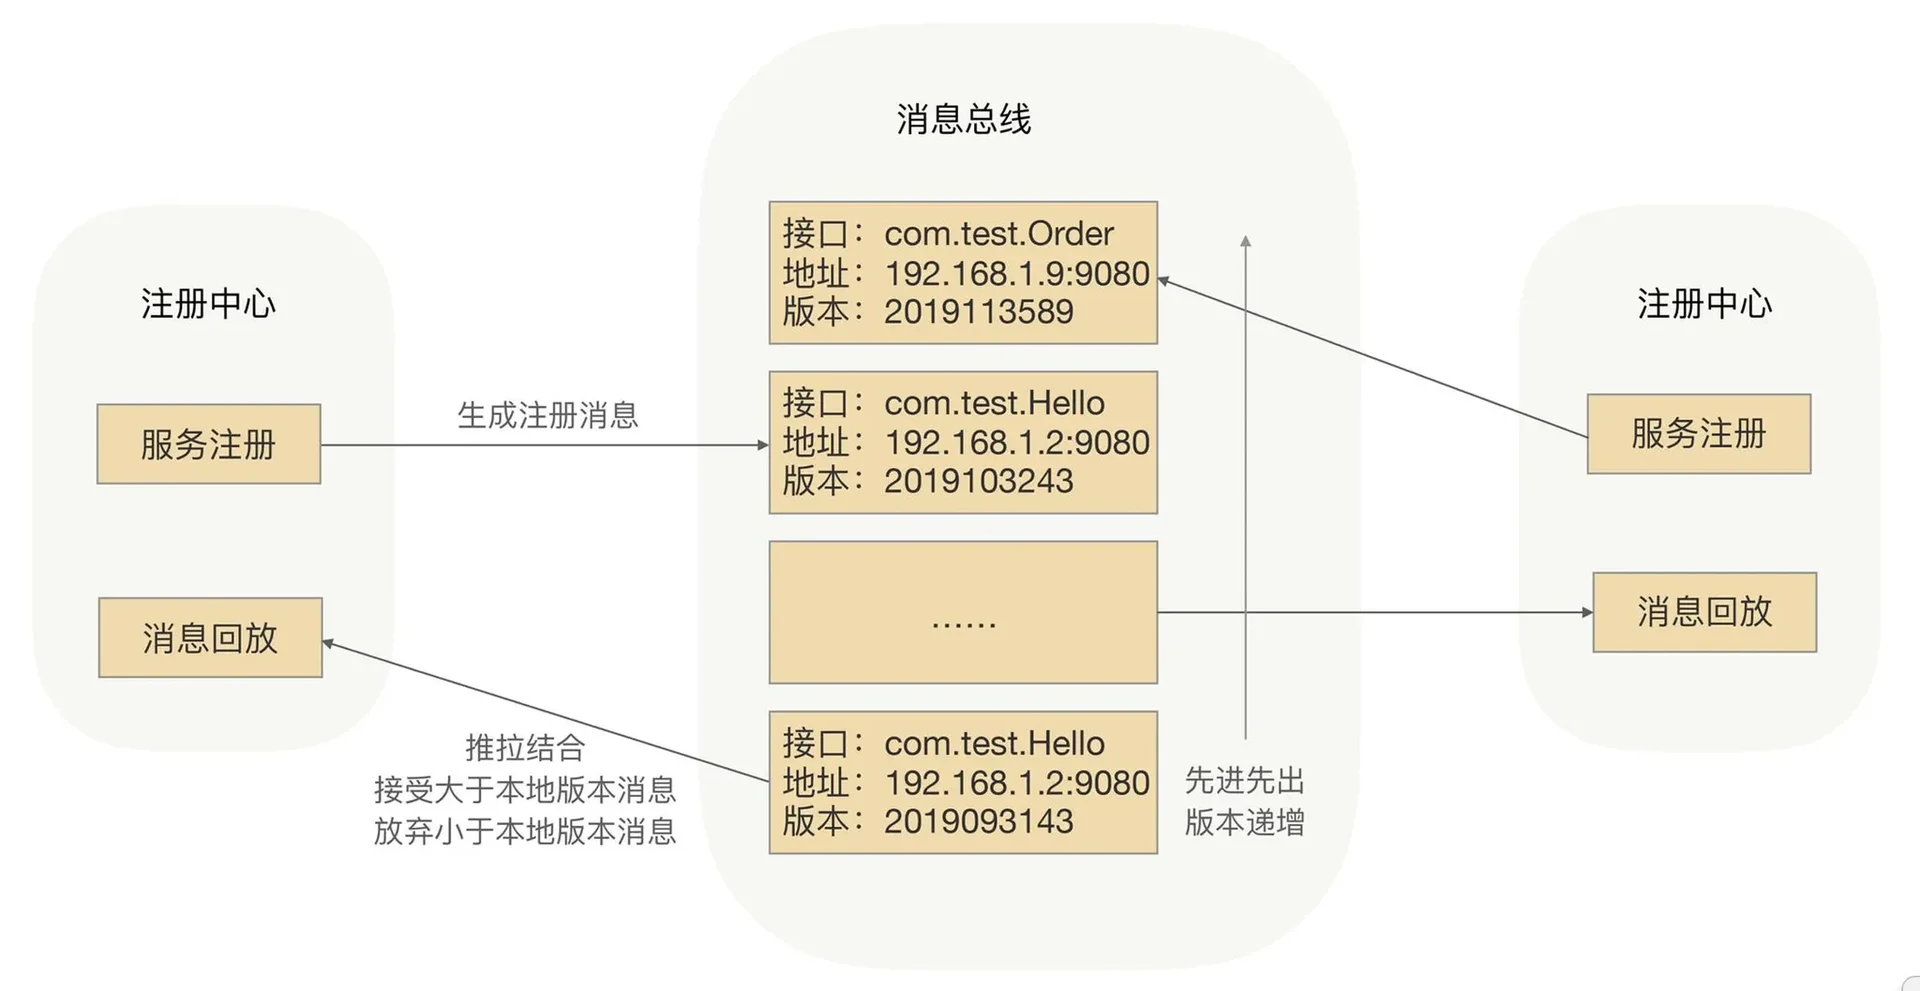
因為要求最終一致性,可以考慮採用訊息匯流排機制。註冊資料可以全量快取在每個註冊中心記憶體中,透過訊息匯流排來同步資料。當有一個註冊中心節點接收到服務節點註冊,會產生一個訊息推送給服務匯流排,再透過訊息匯流排通知給其它註冊中心節點更新資料並進行服務下發,從而達到註冊中心間資料最終一致性,具體流程如下圖:
後記
後續應該要解讀一些gRPC和Kitex的程式碼,此外還有字節跳動雲原生的公眾號的文章可以學習一下。真正重要的事情其實是拋開那些開源專案掌握更基礎的知識。