
RPC - Remote Procedure Call - リモートプロシージャコール
分散システムの通信を解くためのもの。核心は、ローカル呼び出しと同じ感覚でリモート呼び出しができること。RPC はマイクロサービスやクラウドネイティブ専用の用語ではなく、ネットワーク通信があるところなら使い得る。
例を二つ:
- 大規模な分散アプリはメッセージキュー、分散キャッシュ、分散データベース、統一設定センターなどに依存することがある。アプリとこれらのミドルウェアの間も RPC で通信できる。etcd は統一設定サービスとして、クライアントは gRPC フレームワークでサーバと通信している。
- Kubernetes 自体が分散だ。kube-apiserver とクラスタ内の各コンポーネントの通信は、いずれも gRPC フレームワーク経由だ。
RPC が扱うもの:
- シリアライズ:オブジェクトを転送可能なバイト列に変換(シリアライズ)し、逆に戻す(デシリアライズ)。ネットワーク越え・言語越えのデータ交換を解く。
- 圧縮:ネットワークで送る量を減らし、帯域と遅延を下げる。
- プロトコル:クライアントとサーバの通信ルール。転送フォーマットとやり取りの形:HTTP/2、TCP、UDP。
- 動的プロキシ:リモート呼び出しの複雑さを隠し、ローカルメソッドのようにリモートサービスを使う:JDK 動的プロキシ、バイトコード強化。
- サービス登録と発見:インスタンスの可用性を動的に管理し、負荷分散とフェイルオーバーを支える。ZooKeeper、Consul、ETCD などの登録センターがアドレスとメタデータを持つ。
- 暗号化:転送データの機密性と完全性。中間者攻撃や改ざんを防ぐ。
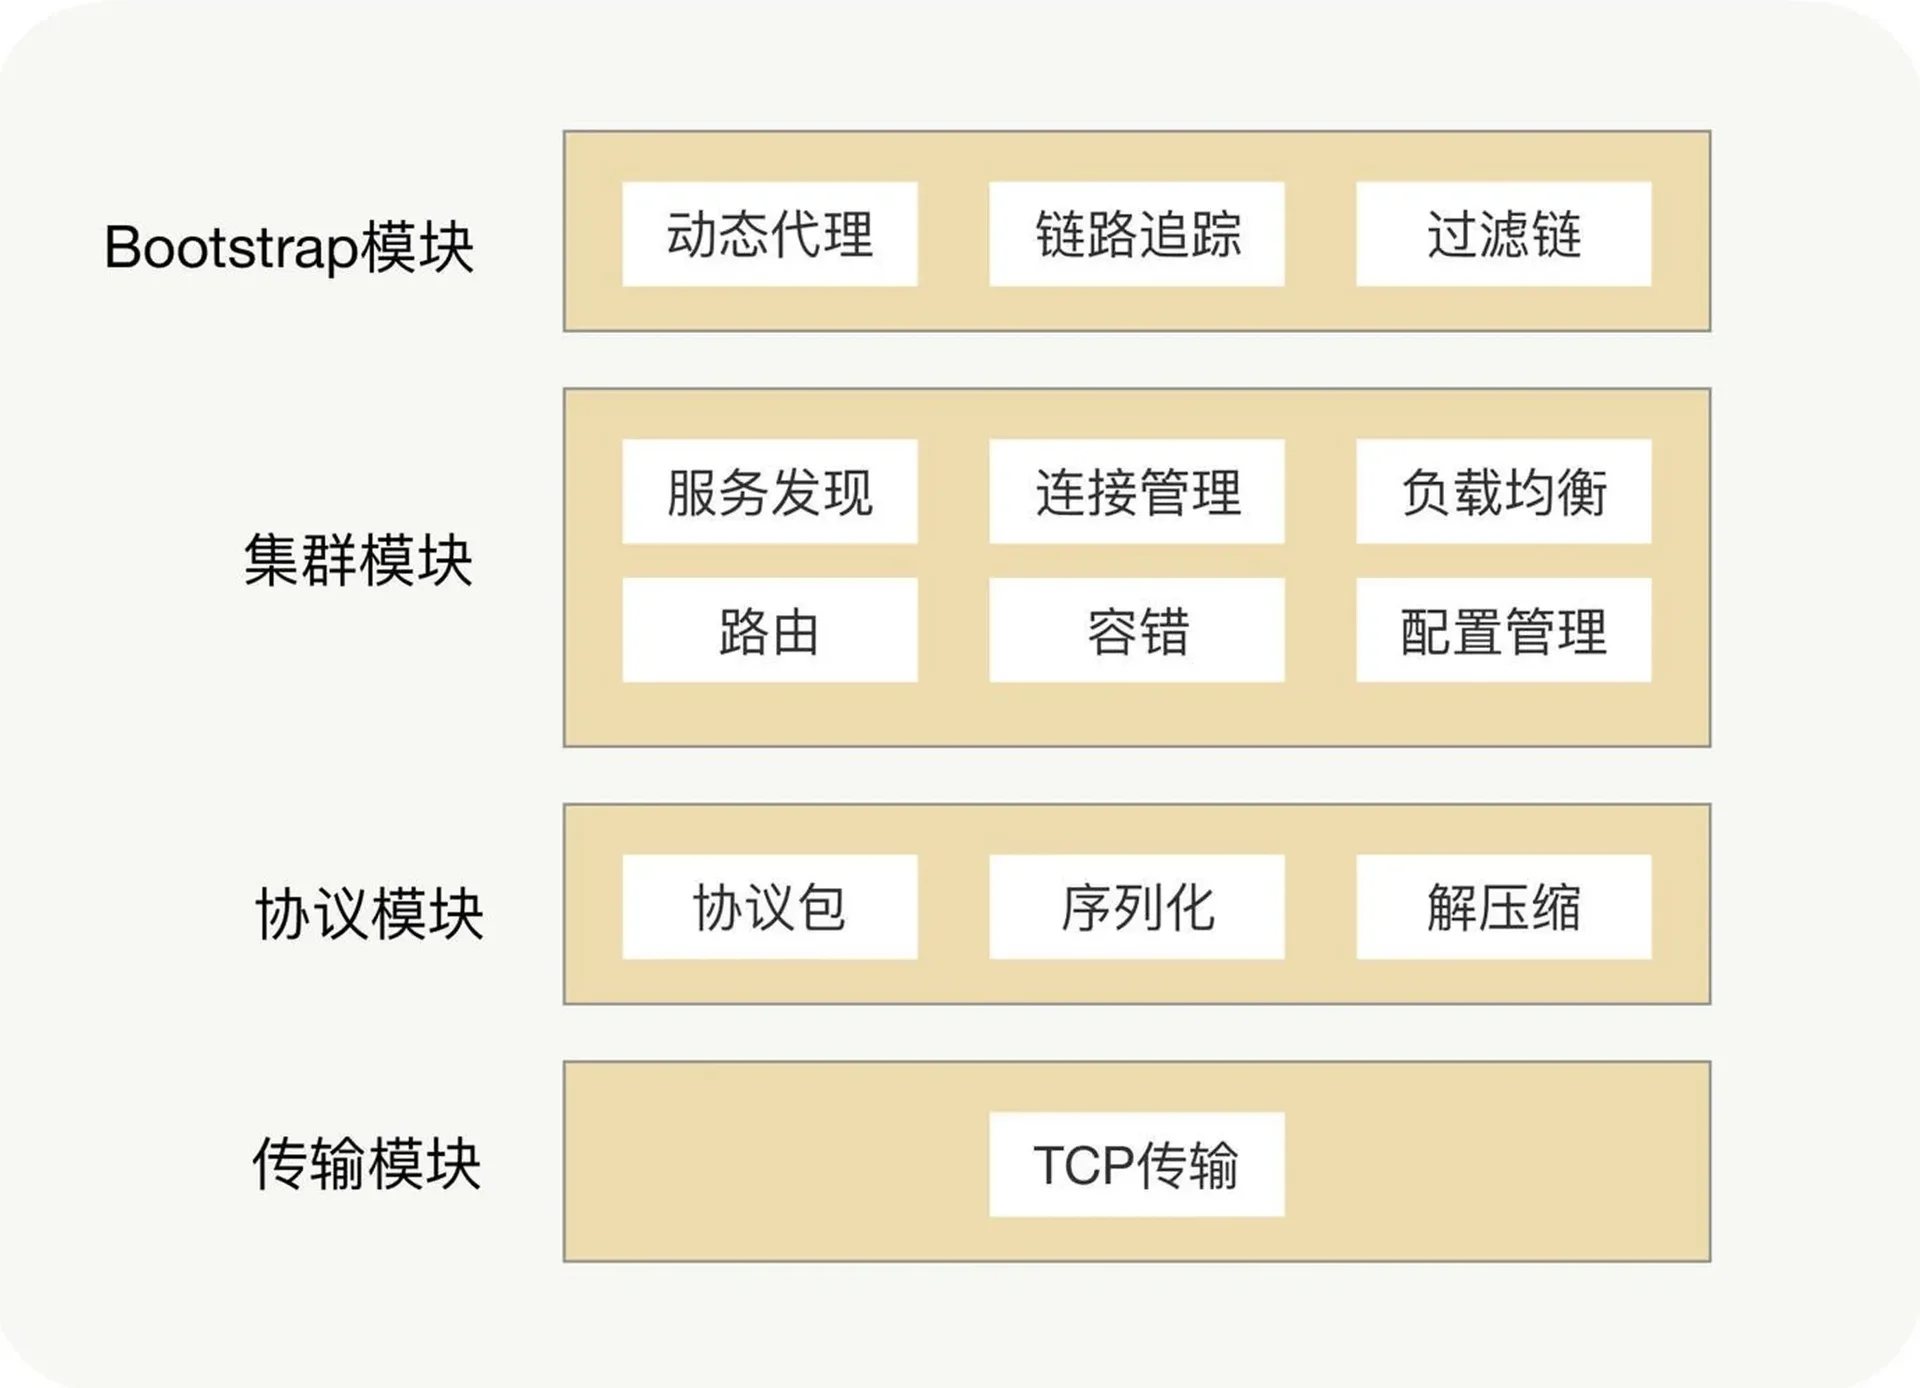
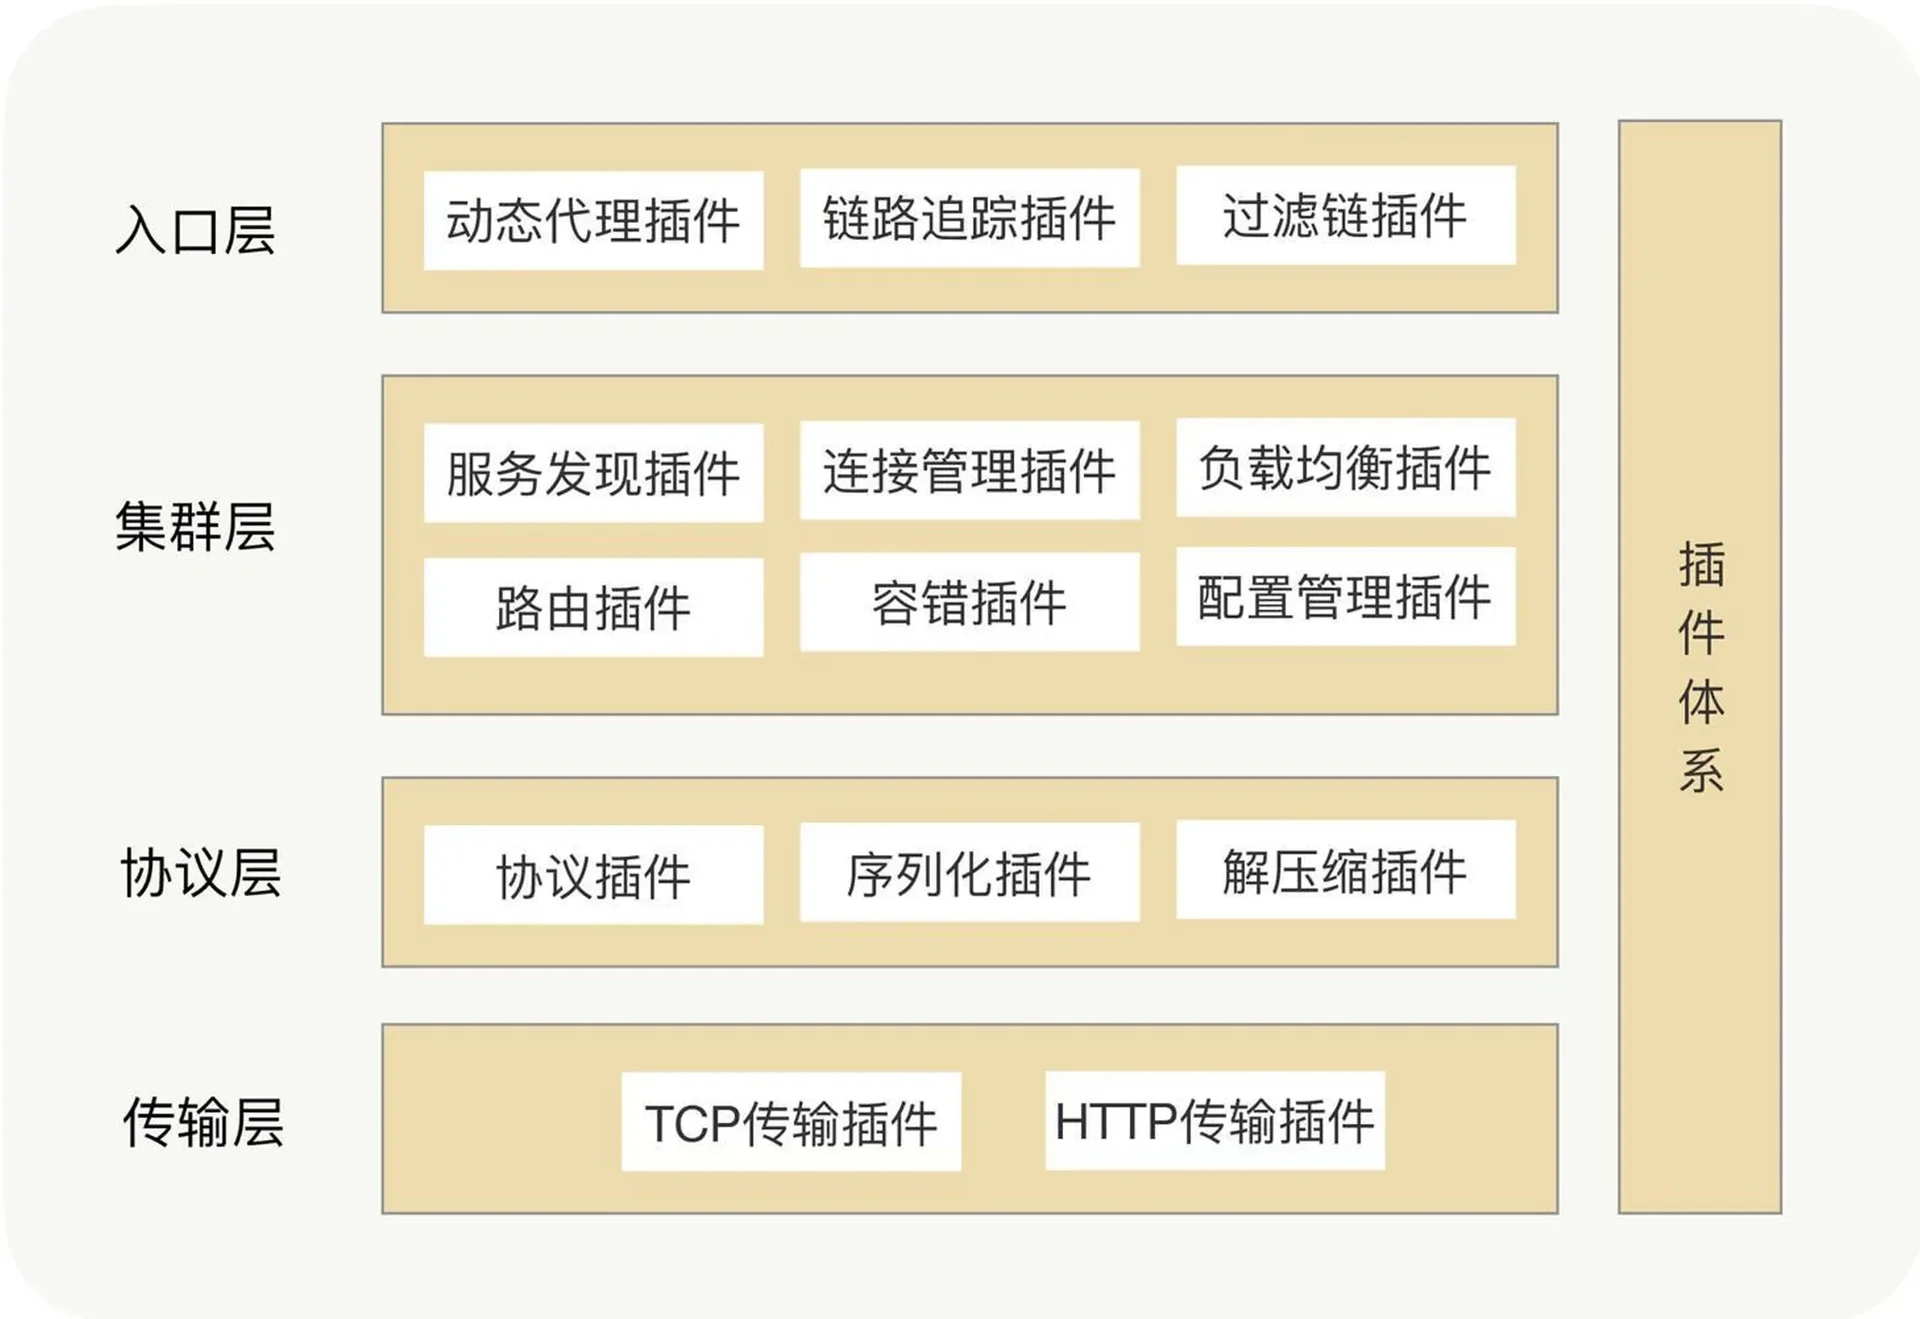
- ネットワーク通信:ネットワーク IO モデル。効率的で安定した通信、接続管理や送受信などの下回り。口で言うのは簡単だが、実際はかなり複雑だ。対向ノードの探索、接続の確立、エンコード/デコード、接続の管理など。RPC はこの一連を包んでくれるので、分散システムを組むときの通信ロジックは簡単になり、より安全にもなる。
RPC クラスタが扱うもの:
- 監視
- サーキットブレーク/レート制限
- グレースフルな起動停止
- 複数プロトコル
- 分散トレーシング
RPC が本当に強いところ:
- 接続管理
- ヘルスチェック
- 負荷分散
- グレースフルな起動・停止
- 異常時リトライ
- 業務グループ分け
- サーキットブレーク/レート制限
RPC フレームワークがなければ、別サーバのインタフェースはどう呼ぶのか。
RPC はネットワークプログラミングの詳細を隠し、リモートメソッドの呼び出しをローカル(同じプロジェクト内のメソッド)と同じ体験にする。リモートだからといって、業務と関係ないコードを大量に書く必要はない。
RPC の役割は主に二つ:
- リモート呼び出しとローカル呼び出しの差を隠し、プロジェクト内のメソッドを呼んでいるように感じさせる;
- 下のネットワークの複雑さを隠し、業務ロジックに集中させる。
シリアライズ
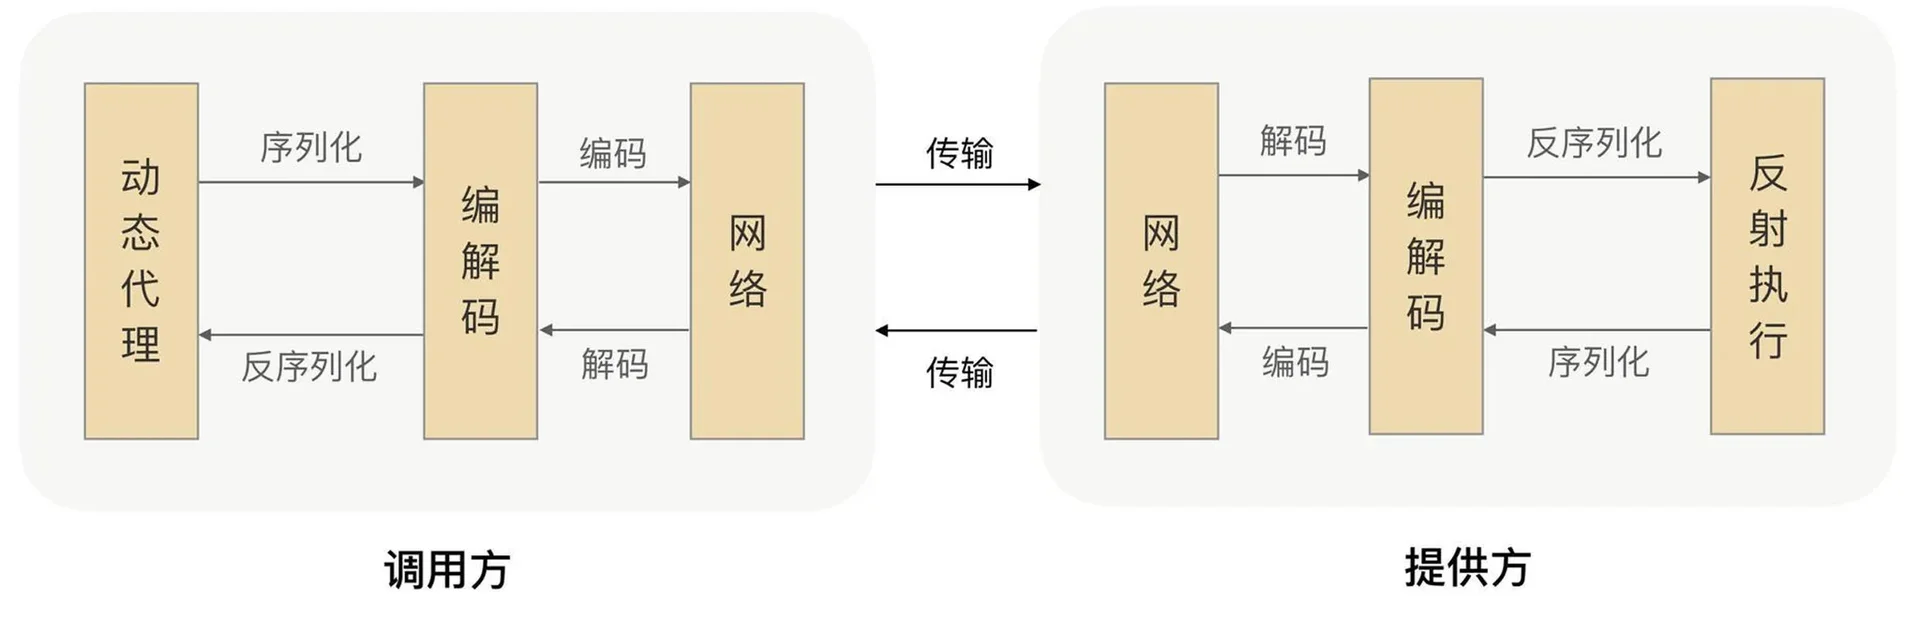
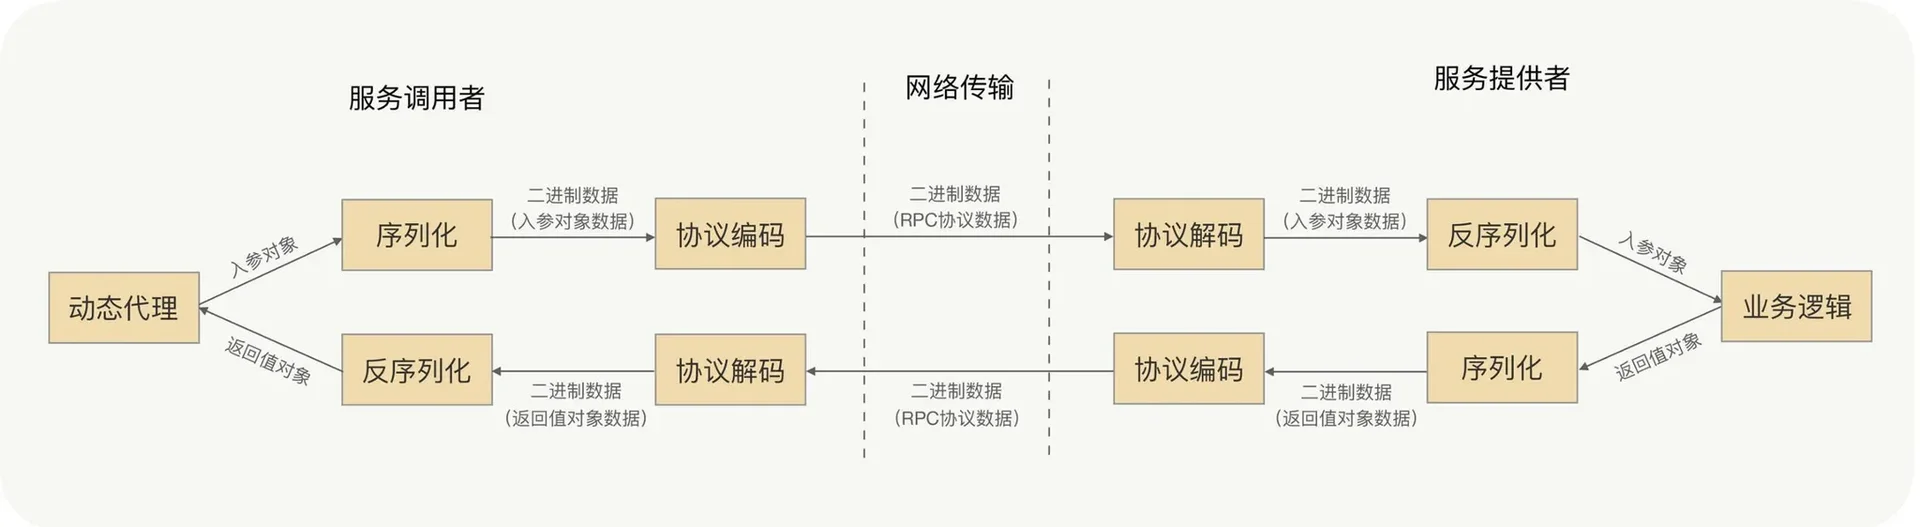
ネットワークで送るデータはバイナリでなければならない。しかし呼び出し側の入出力はオブジェクトだ。先に転送可能なバイナリに変換し、しかも変換は可逆である必要がある。
データヘッダはだいたい身元確認用で、プロトコル識別、サイズ、リクエスト種別、シリアライズ種別など。メッセージ本体は業務パラメータと拡張属性など。
デシリアライズ
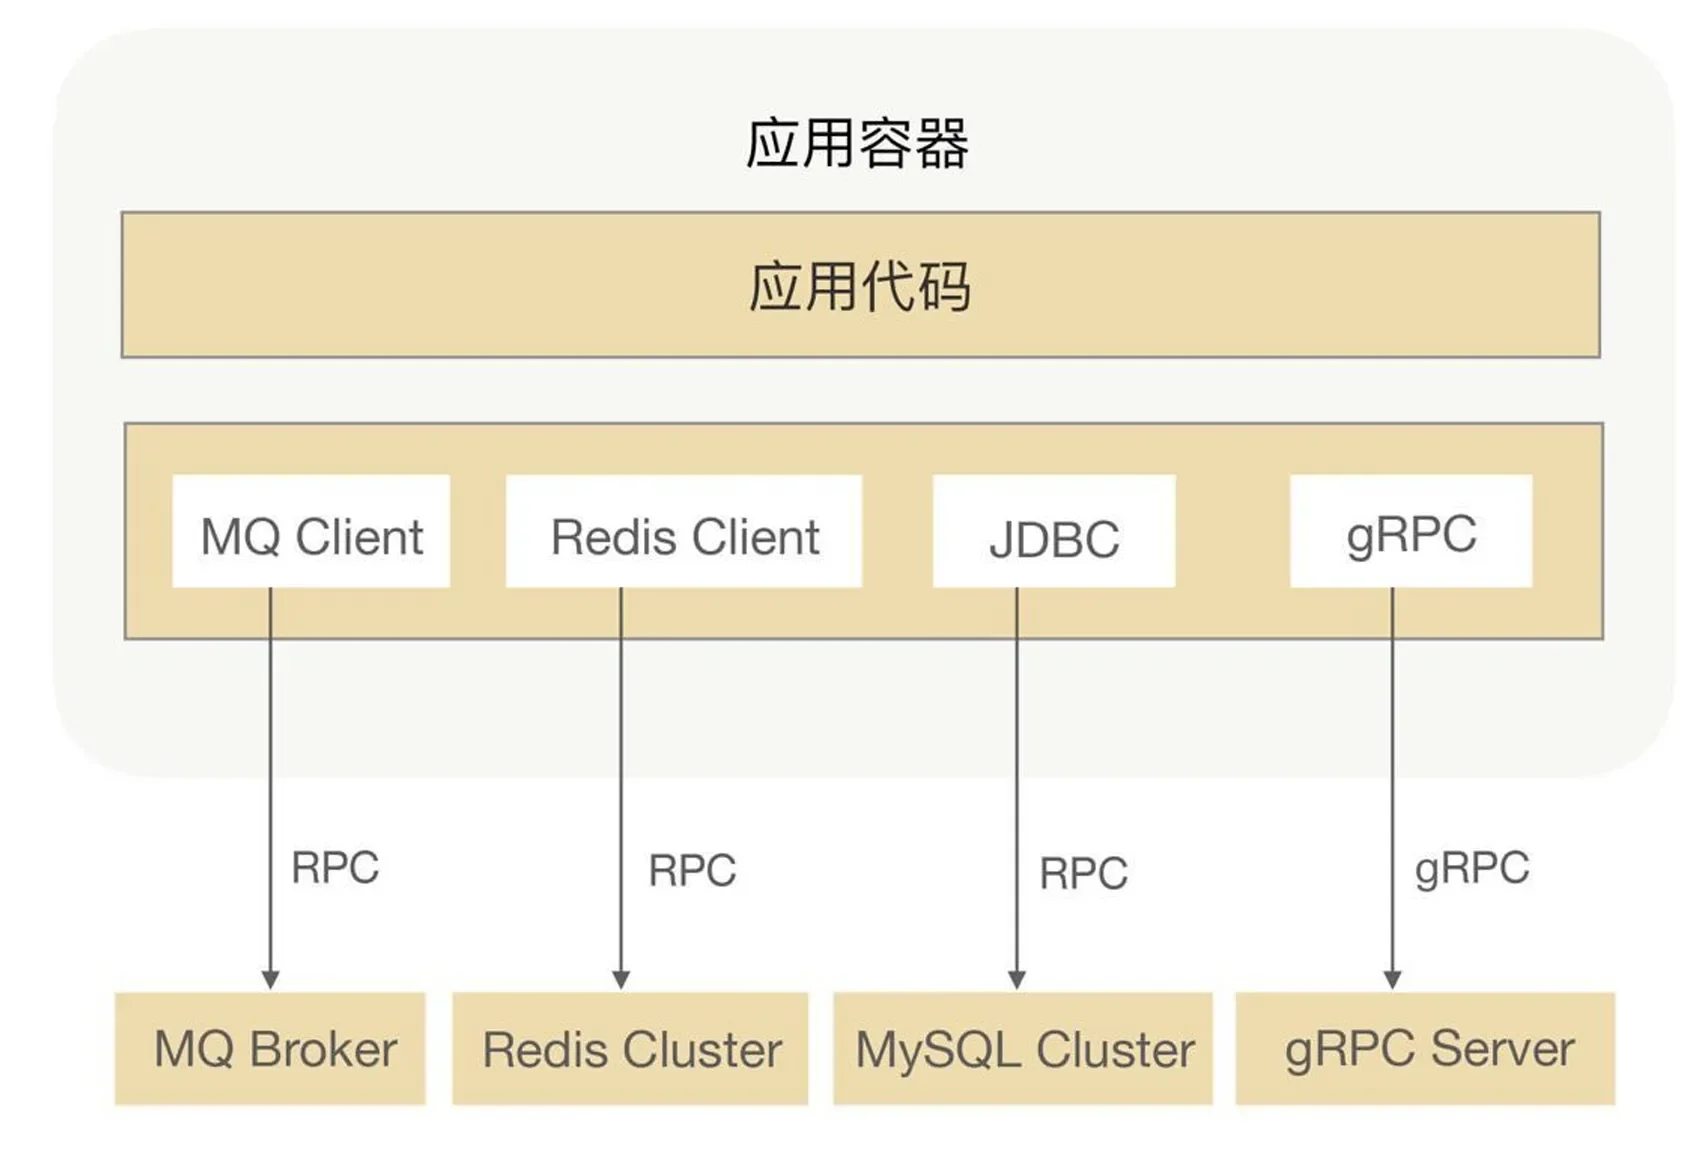
RPC は通信だけでなく、MQ、分散キャッシュ、データベースにも使える。
RPC も HTTP もアプリケーション層のプロトコルだ。
RPC リクエストがネットワークに出る前に、メソッド呼び出しの引数をバイナリにする。バイナリにしたあとローカル Socket に書き、NIC がネットワーク機器へ送る。
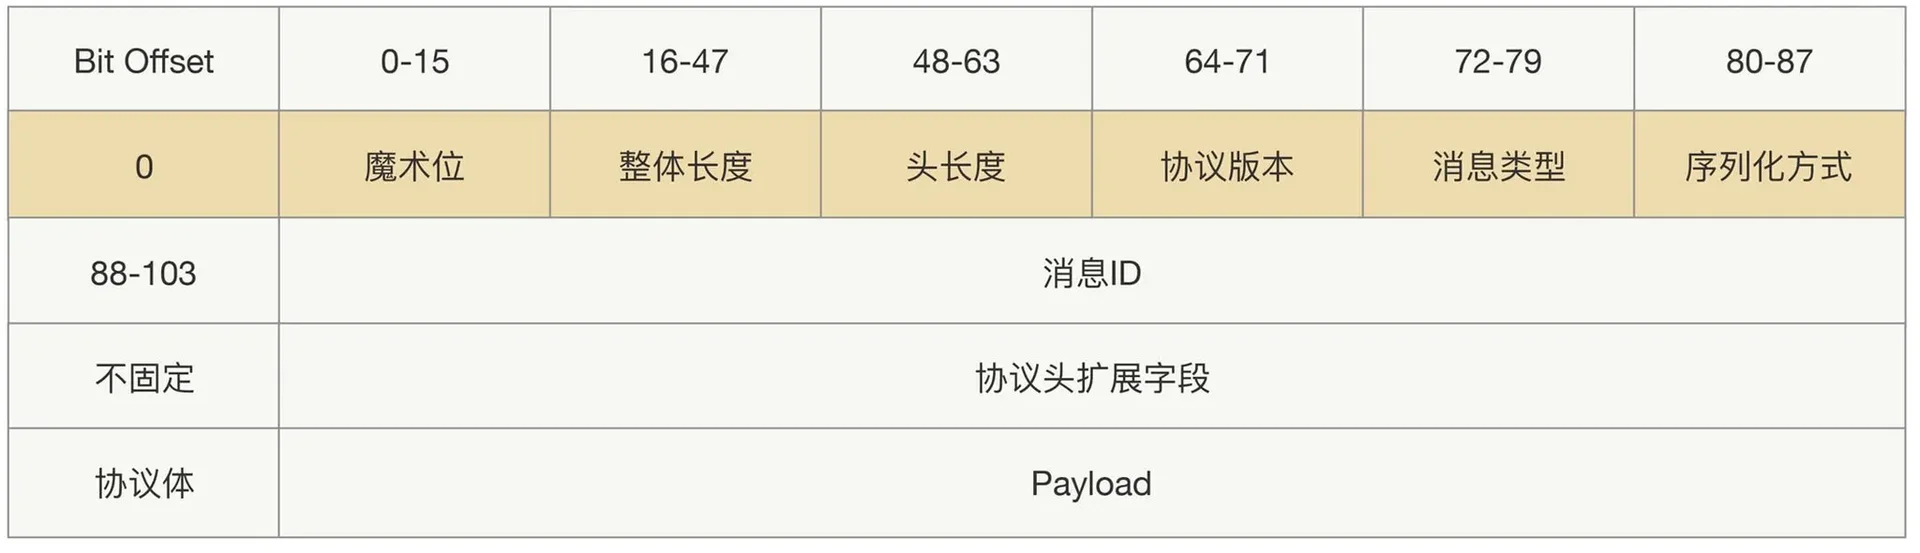
拡張でき、後方互換なプロトコルを設計する要点は、Header と Payload の拡張フィールドを使うこと。拡張フィールドで後方互換する。
場面に合わせてシリアライズを選ぶ。
よく使うシリアライズ:
- JDK ネイティブシリアライズ
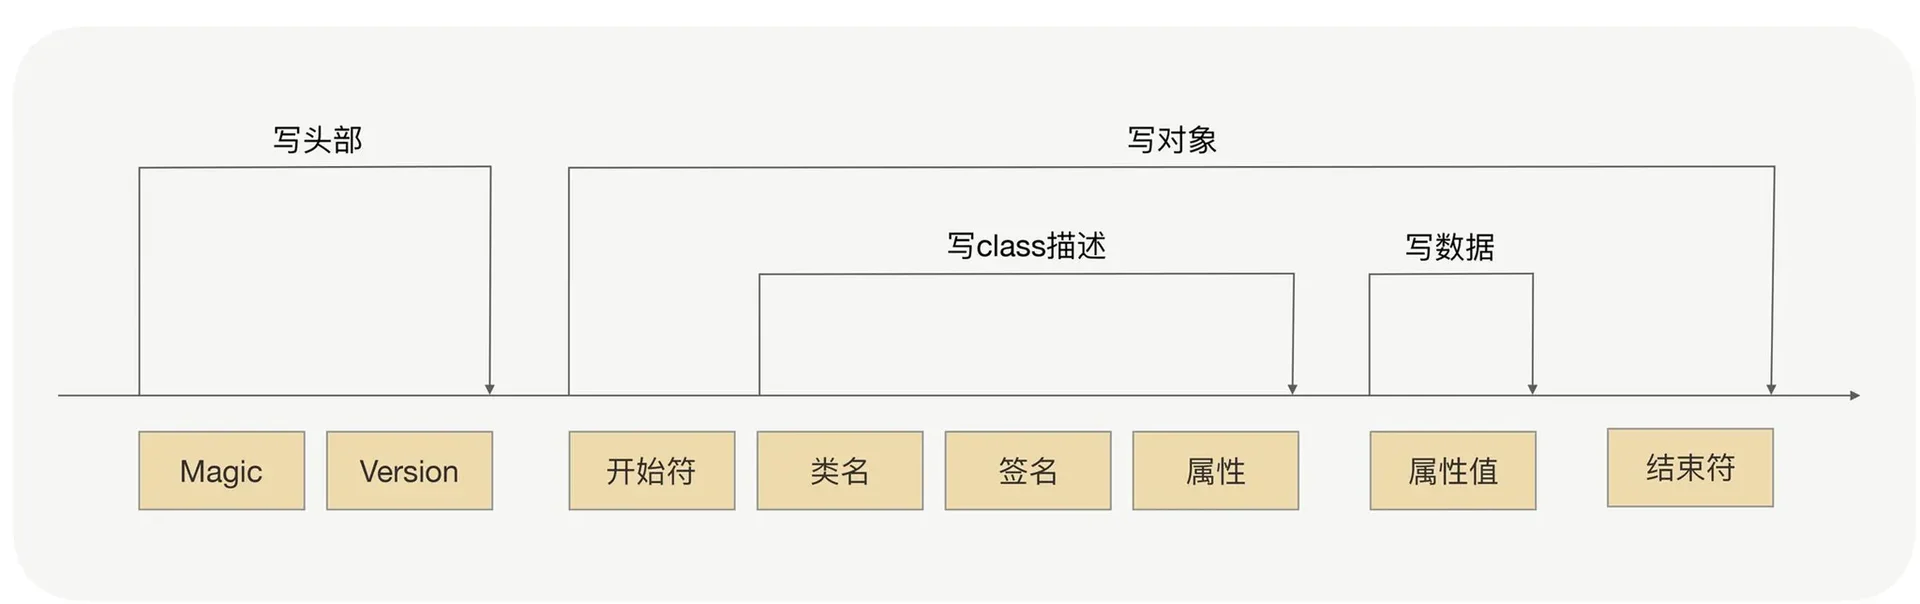
どのシリアライズフレームワークも、核心はシリアライズプロトコルを設計することだ。
- JSON:典型的な Key-Value。型がなく、テキスト型のシリアライズ。
JSON シリアライズには二つの問題がある:
- 余分な空間コストが大きい。データ量の多いサービスではメモリとディスクが膨大になる;
- JSON に型がない。Java のような強い型の言語はリフレクションでまとめて解く必要があり、性能が悪い。
だから RPC で JSON を選ぶなら、提供側と呼び出し側の間のデータは相対的に小さくないと、性能がひどくなる。
- Hessian:動的型、バイナリ、コンパクト、言語をまたげる。JDK や JSON よりコンパクトで、性能もかなり良く、生成バイト数も少ない。
- ただし Hessian 自体に問題がある。公式版は Java のよくある型の一部をサポートしない。
- Linked 系、LinkedHashMap、LinkedHashSet など。CollectionDeserializer を拡張すれば直せる;
- Locale クラス。ContextSerializerFactory を拡張すれば直せる;
- Byte/Short がデシリアライズ時に Integer になる
- ただし Hessian 自体に問題がある。公式版は Java のよくある型の一部をサポートしない。
- Protobuf:Google 社内の多言語データ標準。構造化データの保存形式で、シリアライズにも使える。Java、Python、C++、Go などをサポート。使うときは IDL(Interface description language)を定義し、言語ごとの IDL コンパイラでツールクラスを生成する。利点は
- シリアライズ後のサイズが JSON、Hessian よりかなり小さい;
- IDL が意味をはっきり書けるので、アプリ間で型が落ちない。XML パーサのようなものは不要;
- シリアライズ/デシリアライズが速く、リフレクションで型を取る必要がない;
- メッセージ形式のアップグレードと互換性がよく、後方互換できる。
IDL ファイルに頼らず、Java のドメインオブジェクトを直接デシリアライズできるものもあり、効率は Protobuf とほぼ同じ、バイナリ形式も完全に同じで、Java 版 Protobuf と言ってよい。使っている途中で、サポートされないケースにも当たった:
ほかに Message Pack、kryo など。
シリアライズを選ぶときに見るもの:
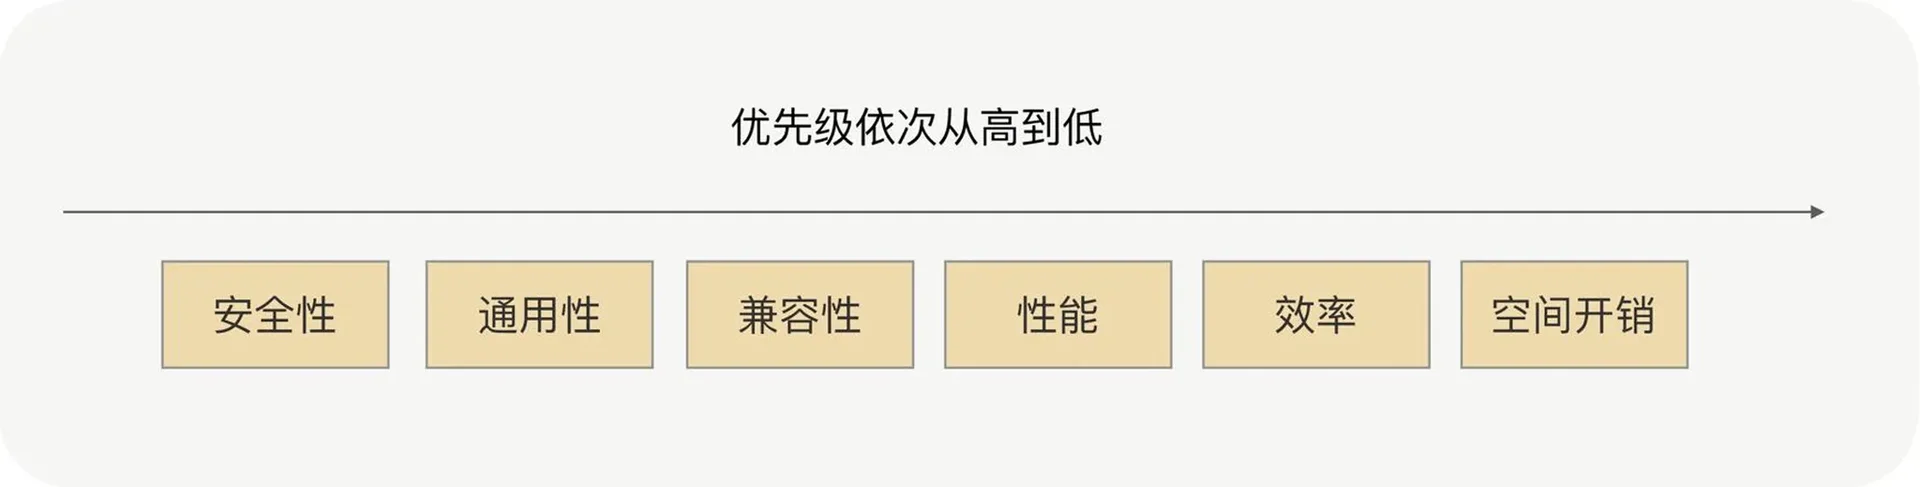
第一候補はやはり Hessian と Protobuf。性能、時間、空間、汎用性、互換性、安全性が要件を満たす。Hessian は使いやすく、オブジェクトの互換性がよい。Protobuf はより効率的で、汎用性で勝る。
RPC フレームワークを使うとき注意すること?
- オブジェクトの組み立てが複雑すぎる。属性が多く、何層もネストしている。
- オブジェクトが大きすぎる。
- シリアライズがサポートしないクラスを入力クラスにする。
- オブジェクトの継承が複雑。
RPC のネットワーク通信はどの IO モデル寄りか?
よくあるネットワーク IO モデル
- 同期ブロッキング IO(BIO)
- 同期ノンブロッキング IO(NIO)
- IO 多重化
- 非同期ノンブロッキング IO(AIO)
非同期 IO なのは AIO だけで、ほかは同期 IO。
ブロッキング IO がいちばん単純でよくあるモデル。Linux ではデフォルトですべての socket が blocking。流れはこうだ。
まずアプリが IO システムコールを出し、プロセスはブロックしてカーネル空間に移る。カーネルはデータを待ち、届いたらユーザメモリにコピーし、IO が終わってプロセスに戻る。最後にアプリのブロックが解け、業務ロジックが走る。
カーネルの IO は二段階——データ待ちとデータコピー。この両方で、アプリの IO スレッドはずっとブロックする。Java のマルチスレッドなら、IO が終わるまでスレッドを一つ占有する。
IO 多重化
高並行でいちばん使われる IO モデル。Java の NIO、Redis、Nginx の下回りがこれ。古典的な Reactor もこのモデルだ。
複数接続の IO を一つの多重化器(select)に登録できる。ユーザプロセスが select を呼ぶと、プロセス全体がブロックする。カーネルは select が見ている socket を「監視」し、どれかのデータが準備できたら select が戻る。そのときユーザプロセスが read を呼び、カーネルからユーザプロセスへコピーする。
select を呼ぶとブロックし、準備できた socket を見つけてから read する。ブロッキング IO より手順は多く、性能を無駄にしているようにも見える。最大の利点は、一つのスレッドで複数 socket の IO を扱えることだ。複数の socket を登録し、select を呼び続けて起きた socket を読む。同じスレッドで複数の IO を処理できる。 同期ブロックではスレッドを増やさないと同じことはできない。
なぜブロッキング IO と IO 多重化が一番よく出てくるのか。
実際のネットワーク IO には、カーネルのサポートとプログラミング言語のサポートが要る。
カーネル側では、今のほとんどのシステムがブロッキング IO、ノンブロッキング IO、IO 多重化をサポートする。シグナル駆動 IO や非同期 IO は、新しい Linux だけだ。
言語側では、C++ でも Java でも、高性能なネットワークフレームワークの多くは Reactor パターンで、典型が Java の Netty。Reactor は IO 多重化に基づく。高負荷でない場面では、同期ブロッキング IO がいちばんよくある。
RPC のネットワーク通信はどの IO モデルを選ぶか。
RPC 呼び出しの多くは高並行だ。カーネル、言語、モデル自体の特徴を考えると、RPC の実装では IO 多重化を選ぶ。言語の通信フレームワークは Reactor 実装が最適で、Java なら Netty(ほかの NIO フレームワークもあるが、今は Netty がいちばん使われている)。Linux では epoll を有効にして性能を上げる(Windows ではカーネルが対応していないので epoll は使えない)。
Reactor パターンに基づくネットワーク IO モデルとは?
Reactor のネットワーク IO は、イベント駆動の高性能ネットワークモデルだ。I/O イベントの監視・配送と業務処理を切り離し、高並行な接続をまとめて扱い、速く応える。核心は 多重化(Select、epoll、kqueue)で複数の接続イベントを監視し、種類に応じてハンドラへ渡す。伝統的なブロッキング IO のようにスレッドを浪費しない。
コア部品:
- Reactor(リアクタ):すべての I/O イベントを聞き、Event Loop で準備できたイベントを対応するハンドラへ渡す。モデルの中枢で、通常は独立スレッド。多重化器(Selector)で登録した Channel をポーリングし、接続・読み・書きを検出する。
- Acceptor(接続ハンドラ):接続確立を専門に扱い、クライアント接続を受け、新しい SocketChannel を Reactor に登録して、あとで読み書きを聞く。
- Handler(イベントハンドラ):具体的な業務(読み、処理、書き戻し)。だいたい:
読みハンドラ:読み準備イベント、Channel から読んでデコード。書きハンドラ:書き準備イベント、結果をエンコードしてクライアントへ。業務ハンドラ:計算や DB など時間のかかる処理。スレッドプールで非同期にすることもある。
ゼロコピー zero copy
カーネルの IO は二段階——データ待ちとデータコピー。待ちは、NIC がデータを受けてカーネルに書くのを待つこと。コピーは、カーネルがデータをユーザプロセス空間へコピーすること。
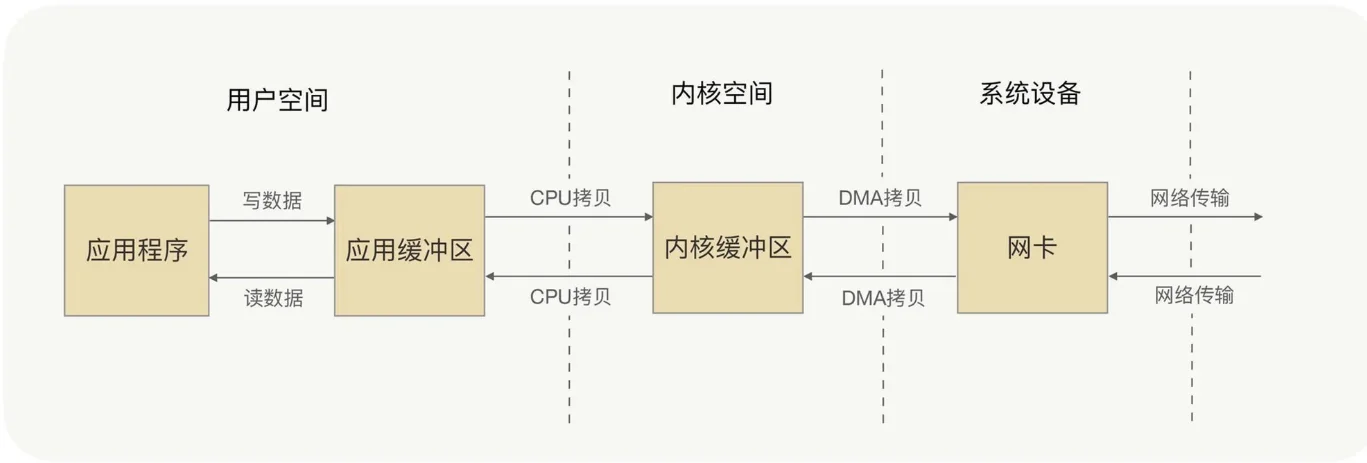
アプリの書き込みのたびに、データはユーザ空間のバッファに書かれ、CPU がカーネルバッファへコピーし、DMA が NIC へコピーし、NIC が送る。一回の書きで二回コピーしてから出る。読みはその逆で、やはり二回コピーしてからアプリが読む。
一回の読み書きで、ユーザ空間とカーネル空間を往復コピーし、コピーのたびに CPU がコンテキストスイッチする(ユーザ→カーネル、またはカーネル→ユーザ)。
ゼロコピー
ゼロコピーは、ユーザ空間とカーネル空間の間のコピーをやめることだ。アプリの読み書きが、ユーザ空間への読み書きでありながらカーネル空間への読み書きと同じになり、DMA がカーネル↔NIC をコピーする。
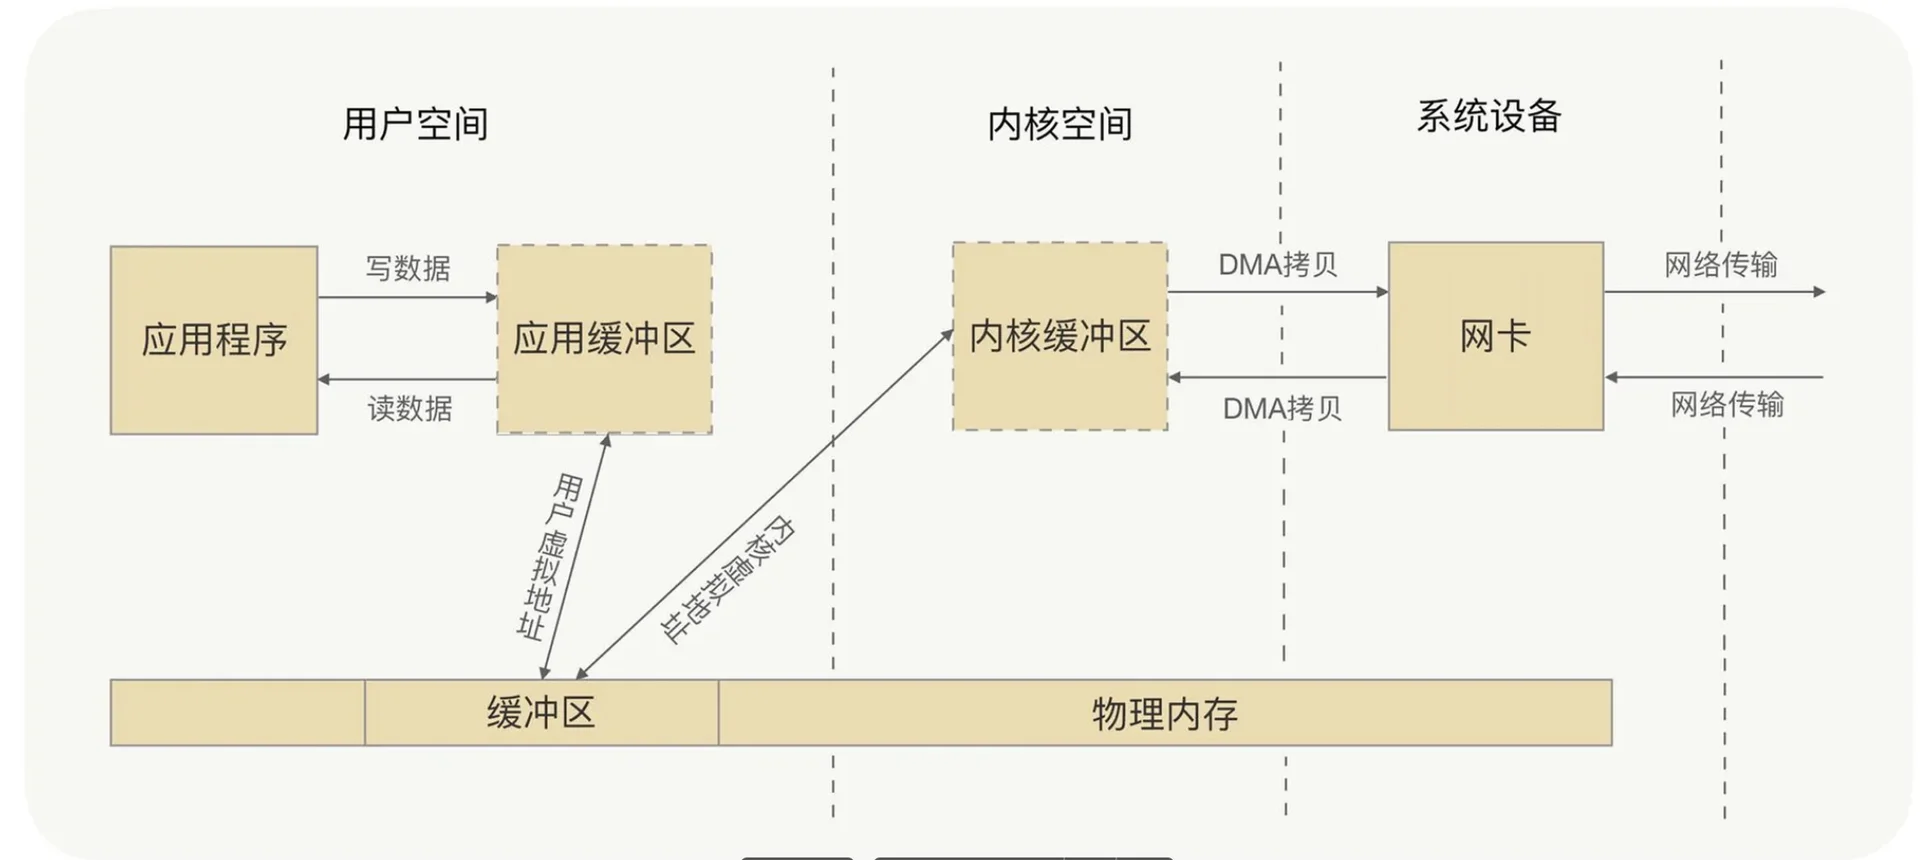
ゼロコピーには二つのやり方がある
- mmap+write:仮想メモリで解く。
- sendfile
mmap+write
原理:
- mmap でカーネル読みバッファをユーザプロセスの仮想アドレス空間に直接マップし、共有メモリにする。カーネルバッファからユーザバッファへのコピーはなく、アドレスの対応だけ。
転送の流れ:
- 一回目のコピー(DMA):ディスク→カーネル読みバッファ。
共有マップ:ユーザは仮想メモリ経由でカーネルバッファを見る。
- 二回目のコピー(CPU):write 時、CPU がカーネル読みバッファをカーネル Socket バッファへコピー。
- 三回目のコピー(DMA):DMA が Socket バッファを NIC へ。
利点と限界:
利点:
- CPU コピーが一回減る(カーネル→ユーザバッファがなくなる)。
- アプリがマップしたメモリを直接触れる。前処理(改変、圧縮)が要る場面に向く。
欠点:
- まだコンテキストスイッチ 4 回(システムコール 2 回)とデータコピー 3 回。
- マップの維持にコストがあり、ファイルが切られると例外(SIGBUS)になり得る。
sendfile
sendfile は read と write を一つのシステムコールにまとめ、カーネル空間だけで転送する。
転送の流れ(二モード)
基本(SG-DMA なし):
- 一回目のコピー(DMA):ディスク→カーネル読みバッファ。
- 二回目のコピー(CPU):カーネル読みバッファ→カーネル Socket バッファ。
- 三回目のコピー(DMA):Socket バッファ→NIC。
SG-DMA 最適化:
DMA コピーは二回だけ:カーネル読みバッファから DMA Scatter/Gather で NIC へ。CPU は Socket バッファへコピーしない。
利点:
- システムコールは 1 回、コンテキストスイッチは 2 回。
- SG-DMA 対応ハードウェアなら本当のゼロコピー(DMA 二回だけ)。
- スループットが大きく上がる。大きなファイル向き。
欠点:
- データがユーザ空間から全く見えない。送る前に処理できない。
- OS とハードウェアのサポートが要る。
前処理(ファイル内容の改変など)が要るなら mmap+write。
速く送るだけで中身を触らないなら sendfile を優先(特に SG-DMA 環境)。
Netty のゼロコピー
完全にユーザ空間、つまり JVM の話だ。データの操作を最適化する方向のゼロコピー。
- CompositeByteBuf:複数の ByteBuf を論理的な一つの ByteBuf にまとめる。互いのコピーを避ける。
- ByteBuf の slice:同じ記憶領域を共有する複数の ByteBuf に分ける。メモリコピーを避ける。
- wrap:byte[]、ByteBuf、ByteBuffer を Netty ByteBuf に包む。コピーを避ける。
Netty は FileRegion で NIO の FileChannel.transferTo() を包んでゼロコピーしている。Linux の sendfile と同じ原理だ。
動的プロキシ:インタフェース向きのプログラミング、RPC の処理を隠す(コードを読んでいないので、正直あまりはっきりしていない)
ネットワーク通信については——信頼できる転送、これだけ覚えておけばいい。
RPC はインタフェースにプロキシクラスを自動生成する。プロジェクトでインタフェースを注入すると、実行時に結びつくのは生成されたプロキシだ。インタフェースメソッドが呼ばれるとプロキシに横取りされ、そこにリモート呼び出しのロジックを入れられる。
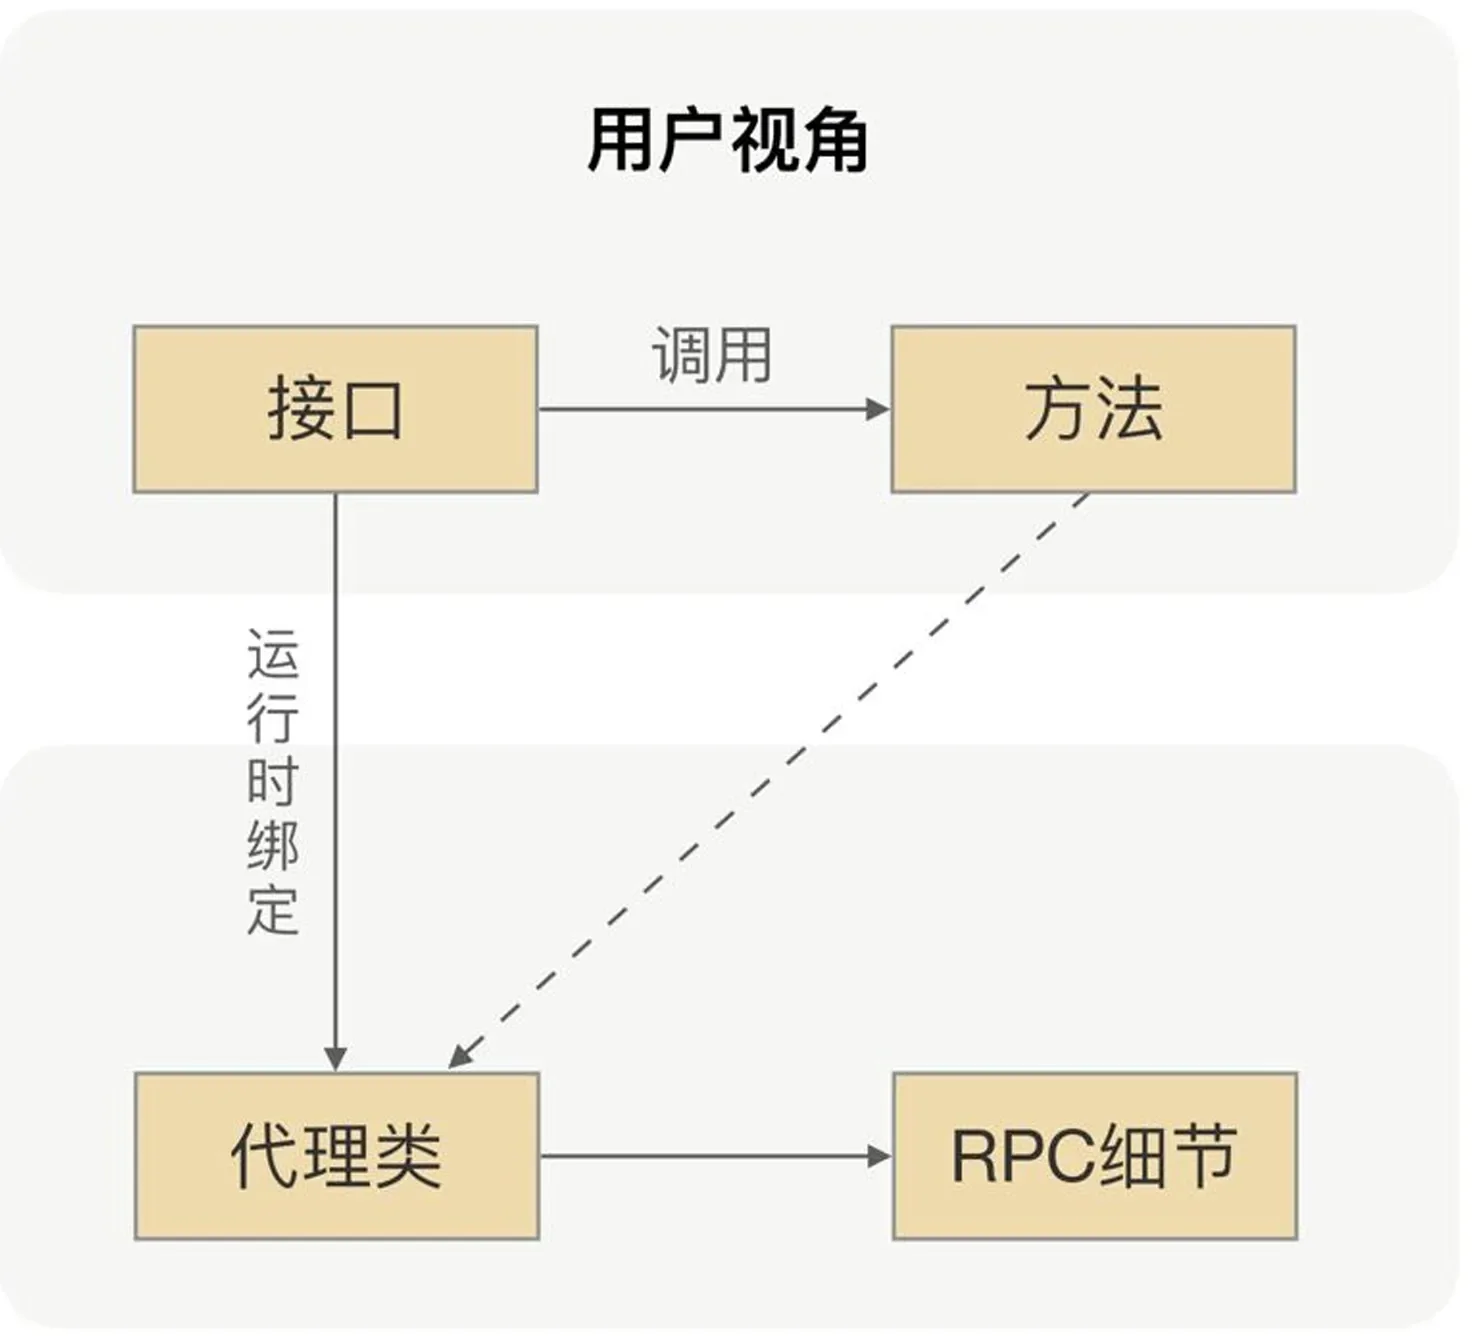
- プロキシは実行時に生成される。生成速度やバイトコードサイズなどが性能に効く——バイトコードが小さいほど実行時の資源は少ない。
- 生成したプロキシはインタフェース呼び出しの横取りに使うので、毎回実行される。だから実行効率が高くないと困る。
- 使いやすいプロキシフレームワークがほしい。API が分かるか、コミュニティ、依存の複雑さ。
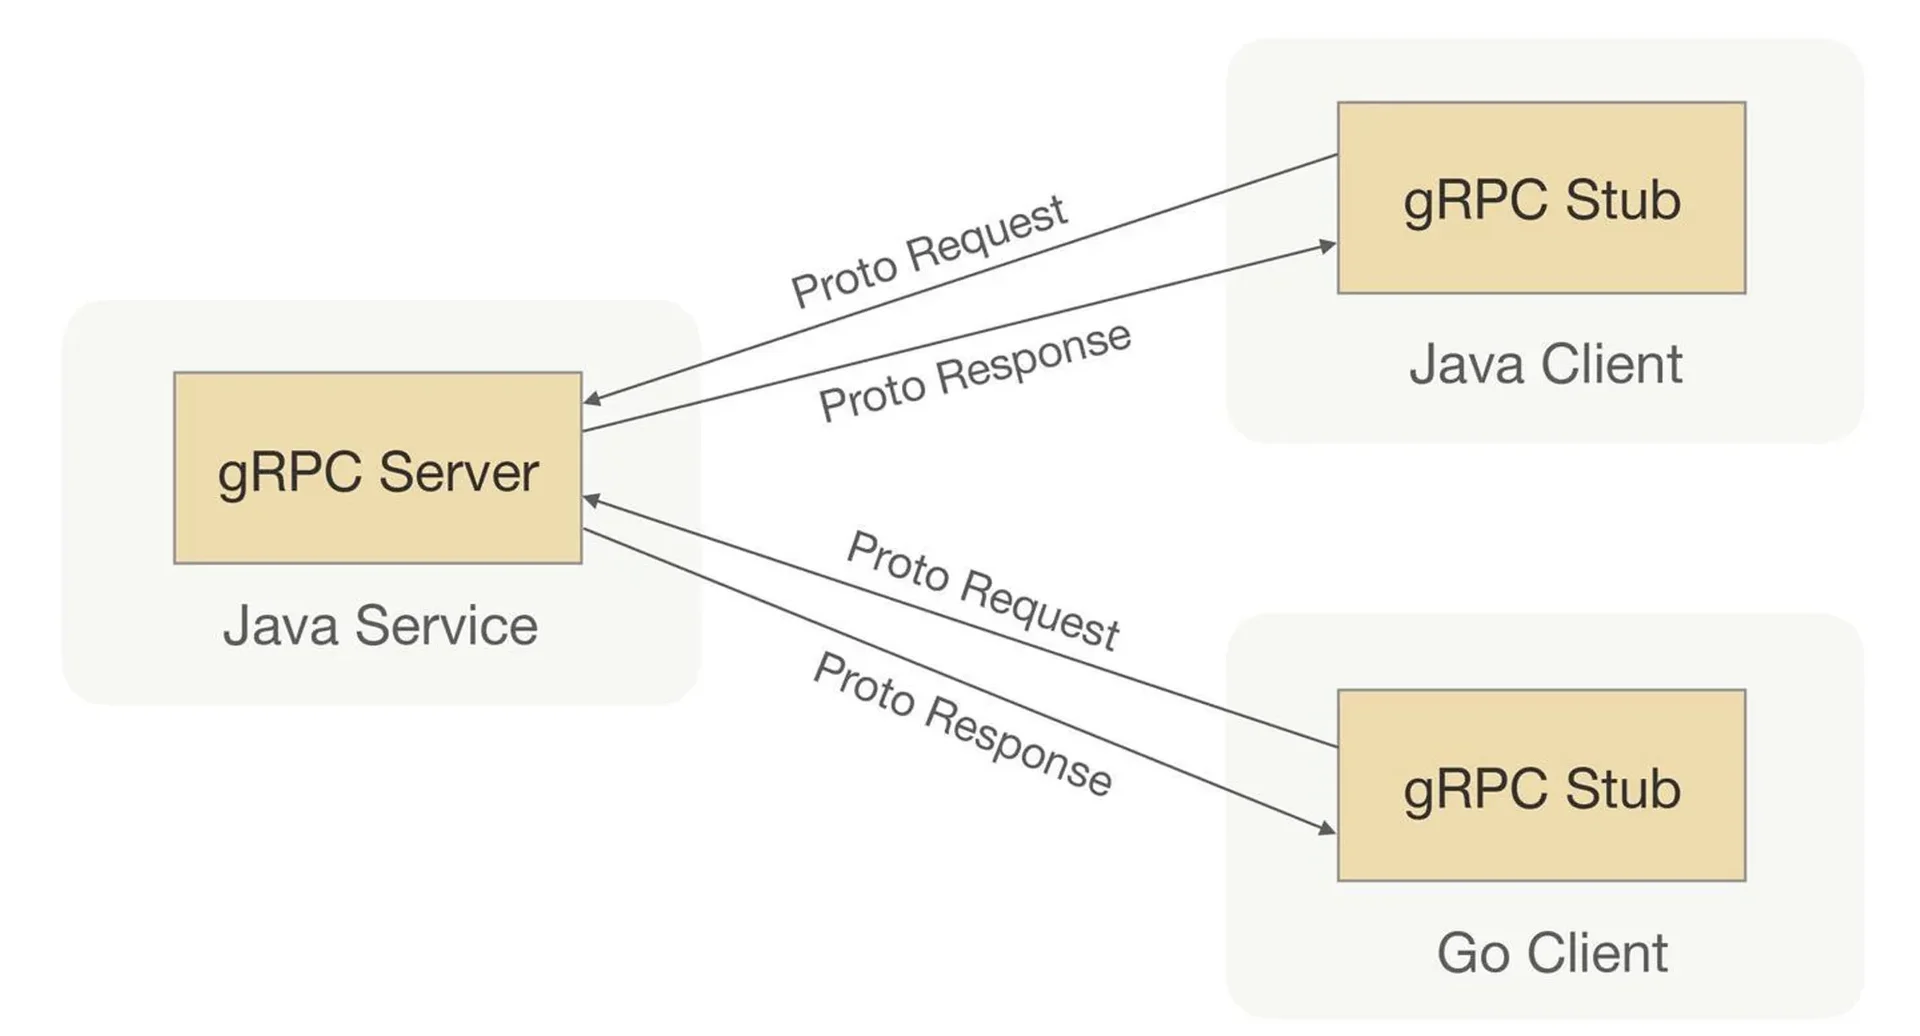
gRPC
プロトコルのカプセル化
メソッド引数のバイナリの後ろに「句点」を足してリクエストを区切る。二つの句点の間が一つのリクエストのバイナリ。これがプロトコルカプセル化だ。
サービス発見:CP か AP か?
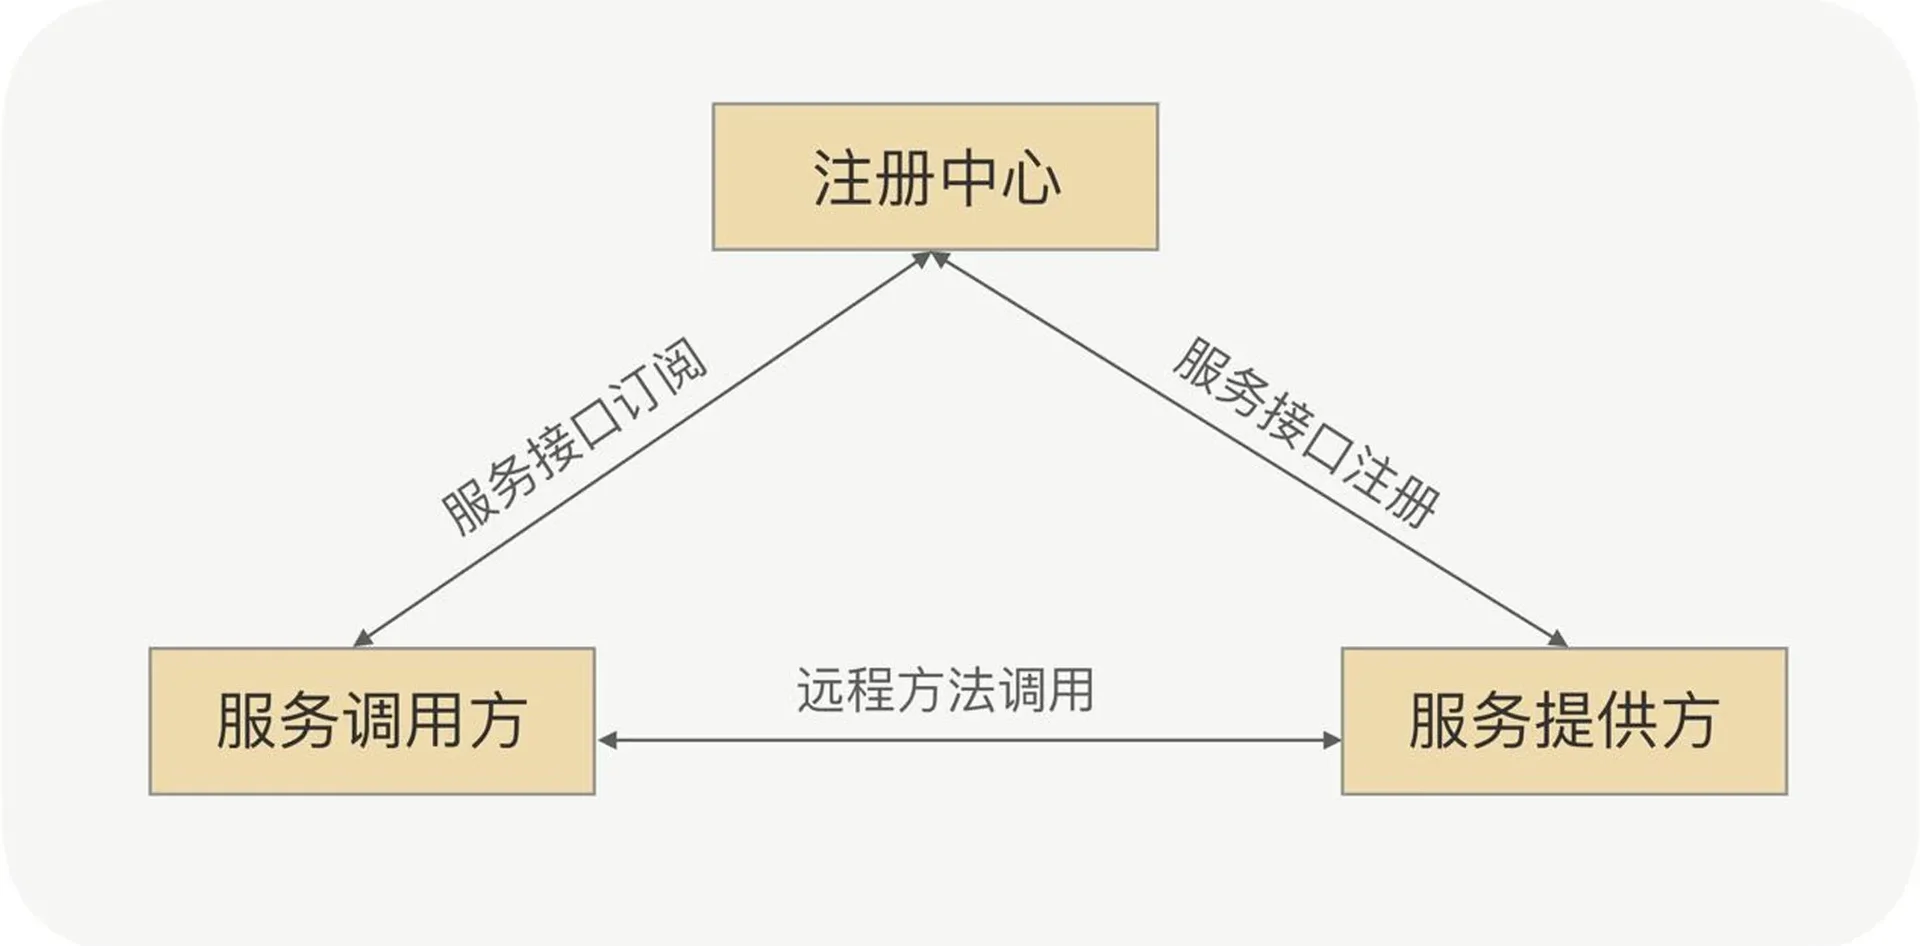
- サービス登録:提供側の起動時に、外に出すインタフェースを登録センターへ登録する。登録センターはそのノードの IP とインタフェースを保存する。
- サービス購読:呼び出し側の起動時に、登録センターで提供側の IP を探し購読し、ローカルにキャッシュして、あとのリモート呼び出しに使う。
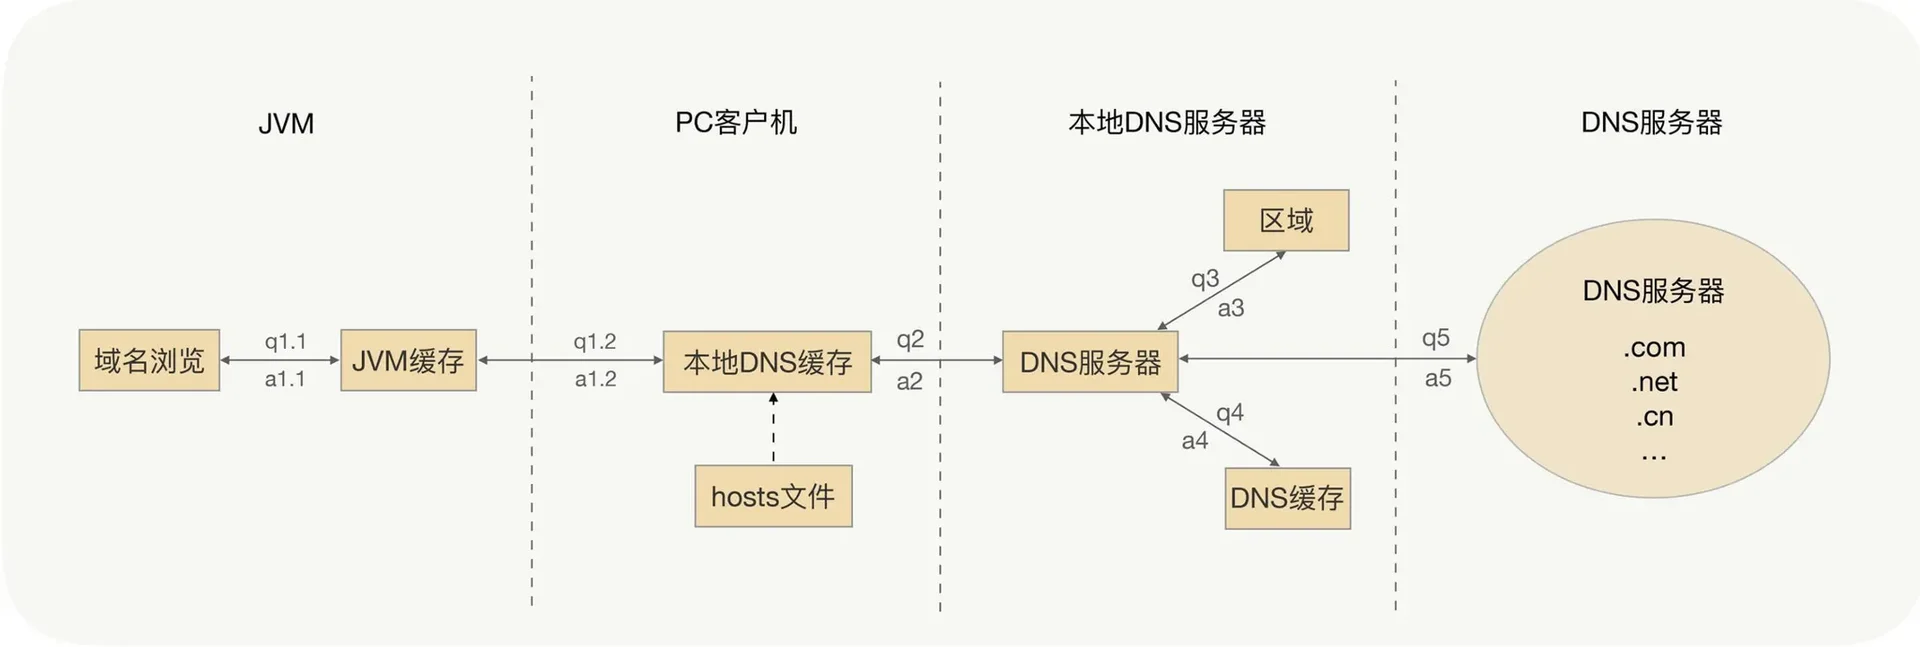
DNS でサービス発見する場合:
提供側ノードをすべて同じドメインに載せ、呼び出し側は DNS でランダムな提供側 IP を取り、長接続を張る。一見問題ないが、次を考える必要がある:
- IP ポートが落ちたとき、呼び出し側はノードをすぐ外せるか?
- すでに一部が上がっていて、そこで拡容したとき、新しいノードはすぐトラフィックを受けられるか?
答えは「できない」。性能のため、DNS 負荷を減らすため、DNS は多段キャッシュで、キャッシュ時間は長めに設定されることが多いからだ。
ZooKeeper ベースのサービス発見
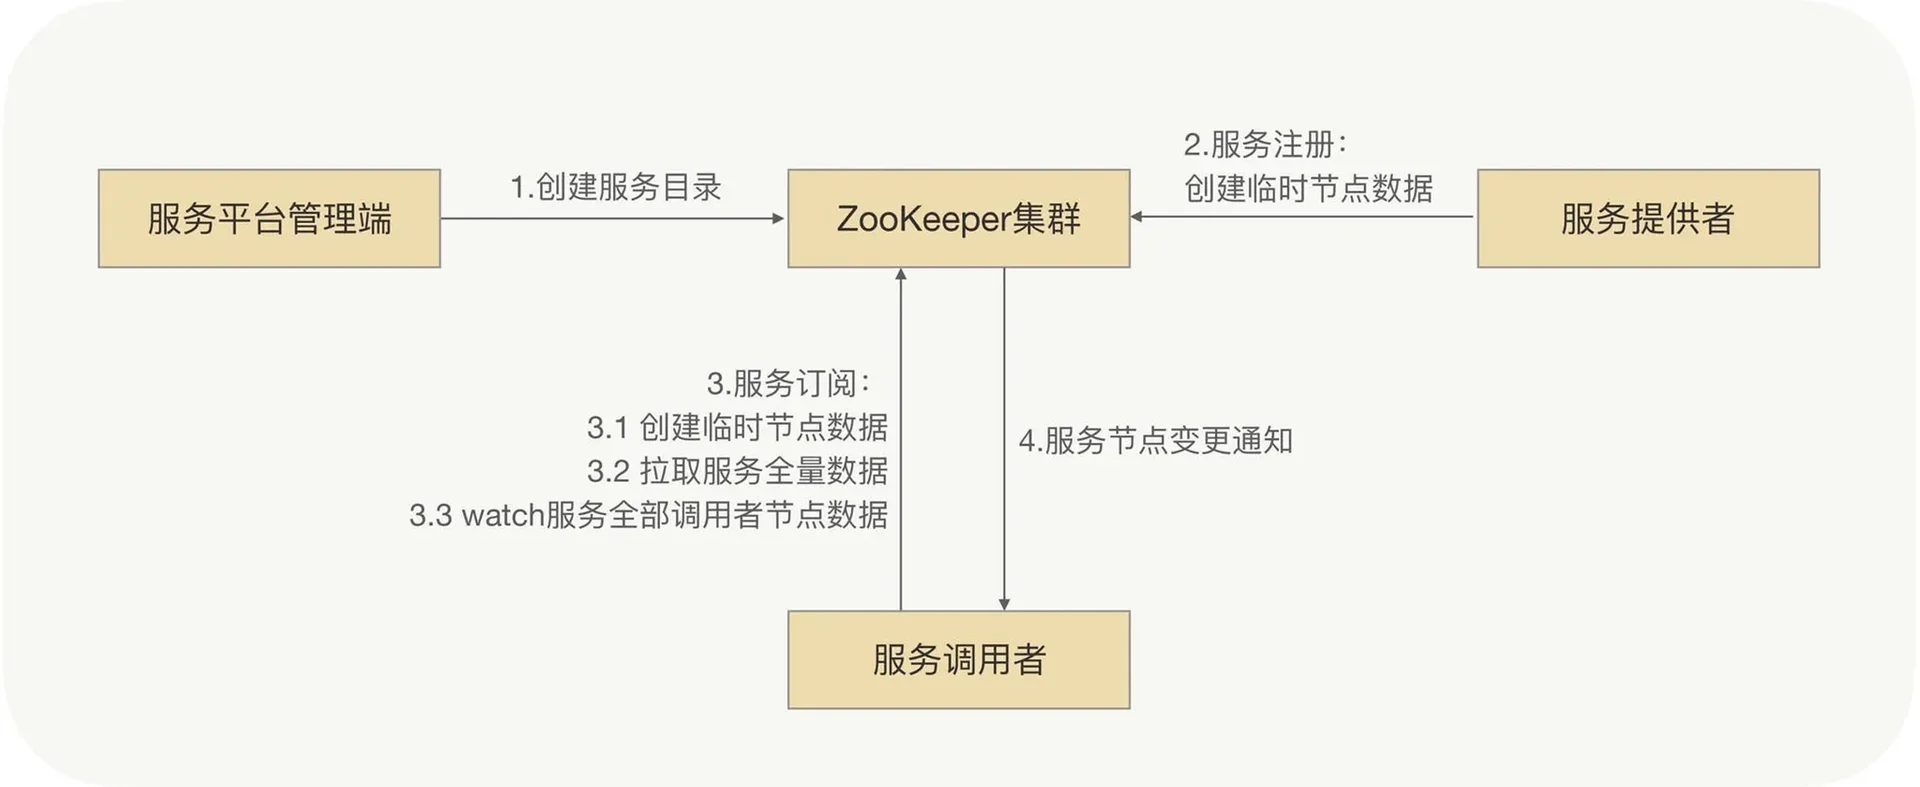
- サービス基盤の管理側が先に ZooKeeper にサービスの根パスを作る。インタフェース名でよい(例:
/service/com.demo.xxService)。その下に提供側ディレクトリと呼び出し側ディレクトリ(例:provider、consumer)を作り、それぞれのノード情報を置く。 - 提供側が登録すると、提供側ディレクトリに一時ノードを作り、登録情報を入れる。
- 呼び出し側が購読すると、呼び出し側ディレクトリに一時ノードを作り、自分の情報を入れ、同時にそのサービスの提供側ディレクトリ(
/service/com.demo.xxService/provider)の全ノードを watch する。 - 提供側ディレクトリのノードデータが変わると、ZooKeeper が購読している呼び出し側に通知する。
メッセージバスによる最終一貫性の登録センター
ZooKeeper の大きな特徴は強い一貫性だ。クラスタの各ノードのデータが更新されるたびに、他の ZooKeeper ノードにも同時更新を知らせる。各ノードのデータをリアルタイムで完全に一致させようとするので、クラスタの性能が落ちる。
RPC のサービス発見では、ノードが上がった直後、呼び出し側は(数秒後でも)そのノードを発見できれば耐えられる。上がって数秒、あるいはもっと長くリクエストが来なくても、クラスタ全体にはほとんど影響がない。だから CP(強制一貫性)を捨て、AP(最終一貫)を取って、登録センタークラスタの性能と安定性を換えることができる。
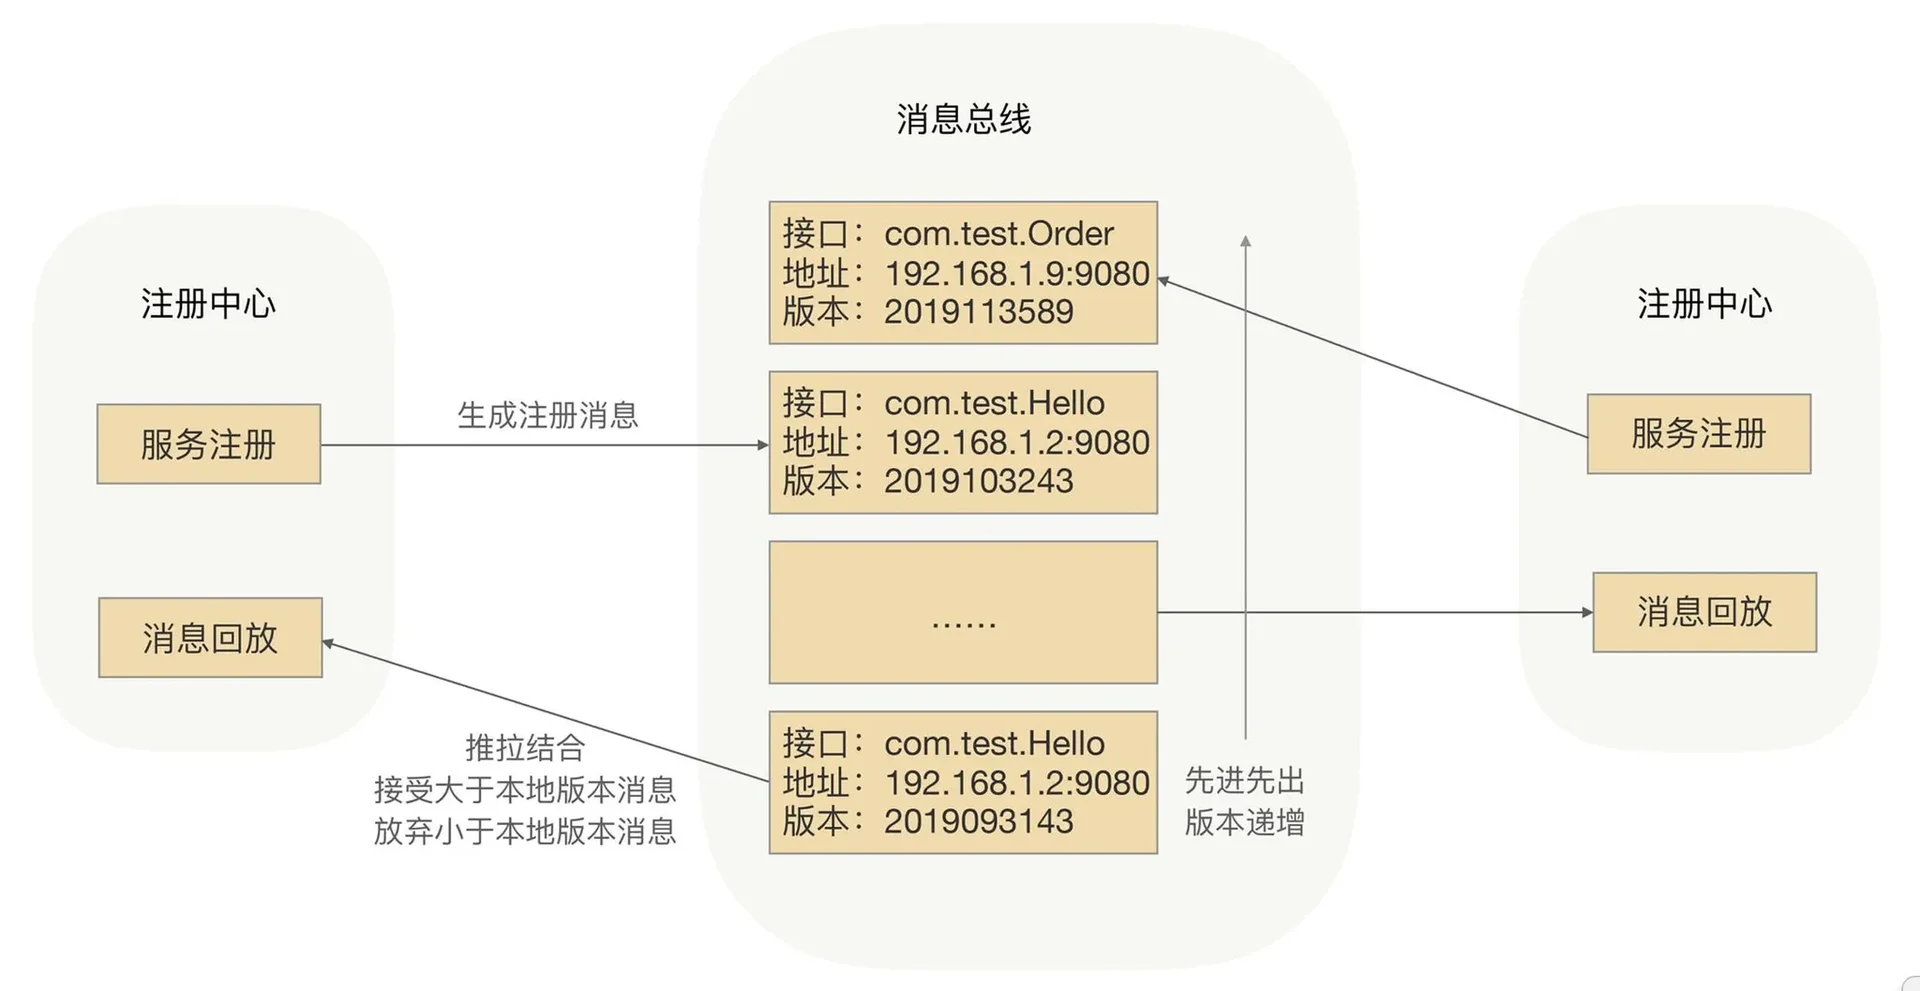
最終一貫が必要なら、メッセージバスを考えてよい。登録データは各登録センターのメモリに全量キャッシュし、バスで同期する。あるノードが登録を受けるとメッセージをバスへ出し、バスが他のノードに更新と下発を知らせ、最終的に登録センター間でデータが一致する。流れは下図:
あとがき
このあとは gRPC と Kitex のコードを読むべきだろう。ほかに ByteDance クラウドネイティブの公式アカウントの記事も勉強になる。本当に大事なのは、オープンソースプロジェクトをいったん置いて、もっと基礎の知識を身につけることだ。