
RPC - Remote Procedure Call - appel de procédure distante
Ça sert à la communication dans un système distribué. L’idée centrale : appeler du distant comme du local. RPC n’est pas réservé au microservices / cloud native — dès qu’il y a du réseau, tu peux tomber sur du RPC.
Deux exemples :
- Une grosse appli distribuée peut dépendre d’une file de messages, d’un cache distribué, d’une base distribuée, d’un centre de config unique, etc. L’appli parle à ces middlewares en RPC. etcd, par exemple, en service de config : le client parle au serveur via gRPC.
- Kubernetes lui-même est distribué. La comm entre kube-apiserver et chaque composant du cluster passe par gRPC.
Ce que RPC couvre :
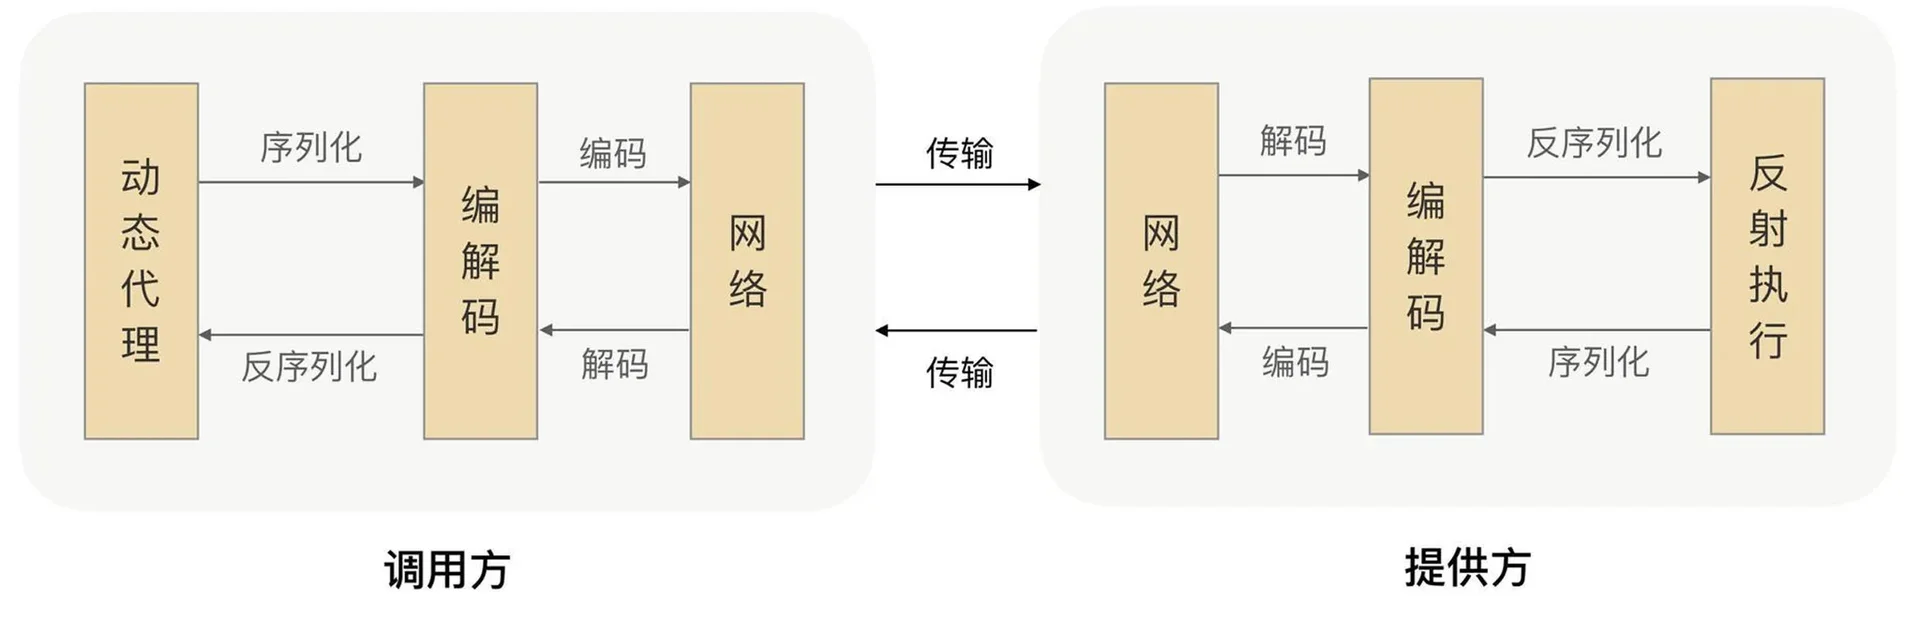
- Sérialisation : transformer un objet en flux d’octets transmissible (sérialiser) et l’inverse (désérialiser). Échange de données à travers le réseau et les langages.
- Compression : moins de data sur le fil, moins de bande passante et de latence.
- Protocole : règles client–serveur, format de transport et mode d’interaction : HTTP/2, TCP, UDP.
- Proxy dynamique : cacher la complexité de l’appel distant, pour utiliser un service distant comme une méthode locale : proxy dynamique JDK, enhancement bytecode.
- Enregistrement et découverte de services : gérer dynamiquement la dispo des instances, load balancing, failover. ZooKeeper, Consul, ETCD stockent adresses et métadonnées.
- Chiffrement : confidentialité et intégrité en transit, anti MITM et anti-tamper.
- Com réseau : modèles d’I/O, comm efficace et stable, gestion des connexions, envoi/réception. Ça a l’air simple, en vrai c’est sale : trouver le pair, ouvrir la connexion, encoder/décoder, gérer les connexions. RPC emballe tout ça, donc quand tu montes un système distribué, la logique réseau est plus simple, et aussi plus sûre.
Côté cluster RPC :
- Monitoring
- Circuit breaker / rate limit
- Démarrage et arrêt gracieux
- Multi-protocoles
- Tracing distribué
Là où RPC est vraiment fort :
- Gestion des connexions
- Health check
- Load balancing
- Start/stop gracieux
- Retry sur erreur
- Groupement métier
- Circuit breaker / rate limit
Sans framework RPC, comment tu appelles une API sur une autre machine ?
RPC cache le détail du réseau : appeler une méthode distante, ça doit ressembler à appeler une méthode locale (dans le même projet). Tu n’as pas à écrire un tas de code hors métier juste parce que c’est distant.
Deux rôles surtout :
- Cacher la différence remote / local, pour que ça ressemble à une méthode du projet ;
- Cacher la complexité du réseau en dessous, pour rester sur le métier.
Sérialisation
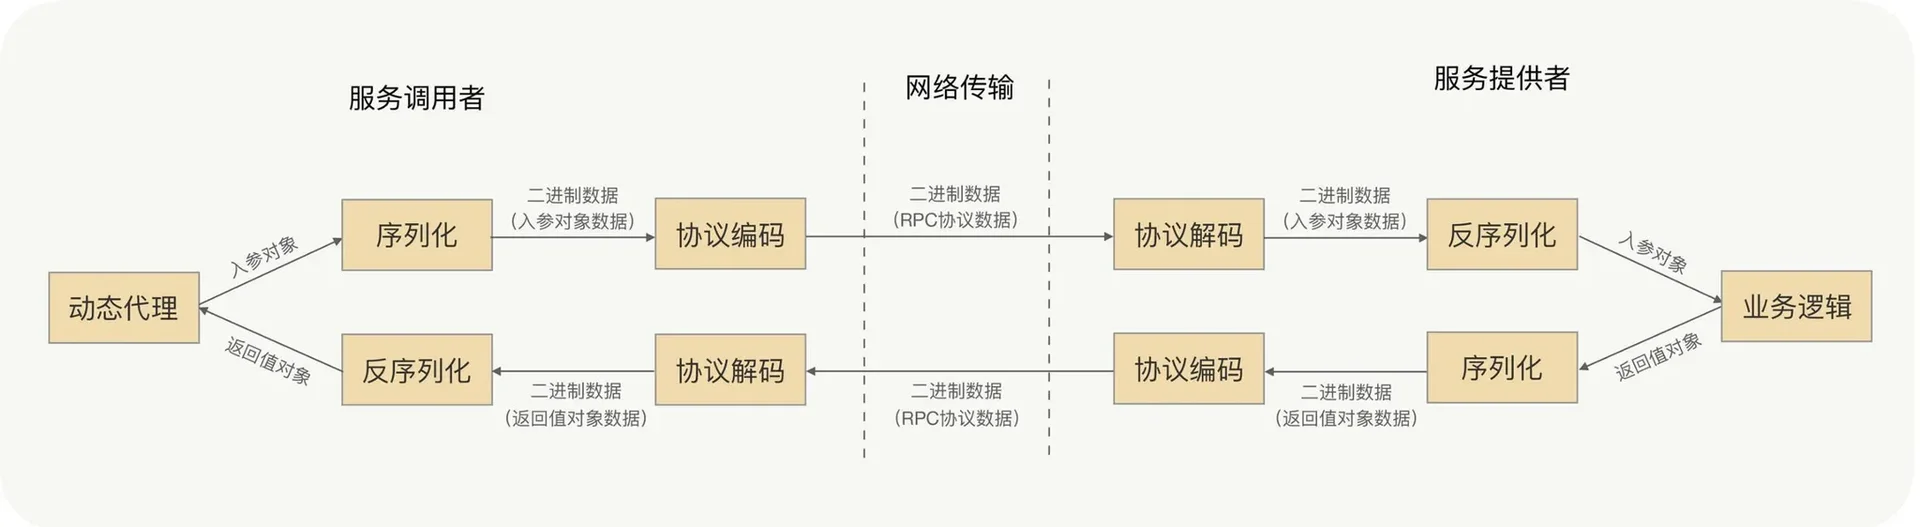
Sur le réseau, ça doit être du binaire. Les in/out de l’appelant, ce sont des objets. Il faut convertir en binaire transmissible, et l’algo doit être réversible.
Le header sert surtout à l’identité : id de protocole, taille, type de requête, type de sérialisation, etc. Le body, c’est surtout les params métier et des attributs en plus.
Désérialisation
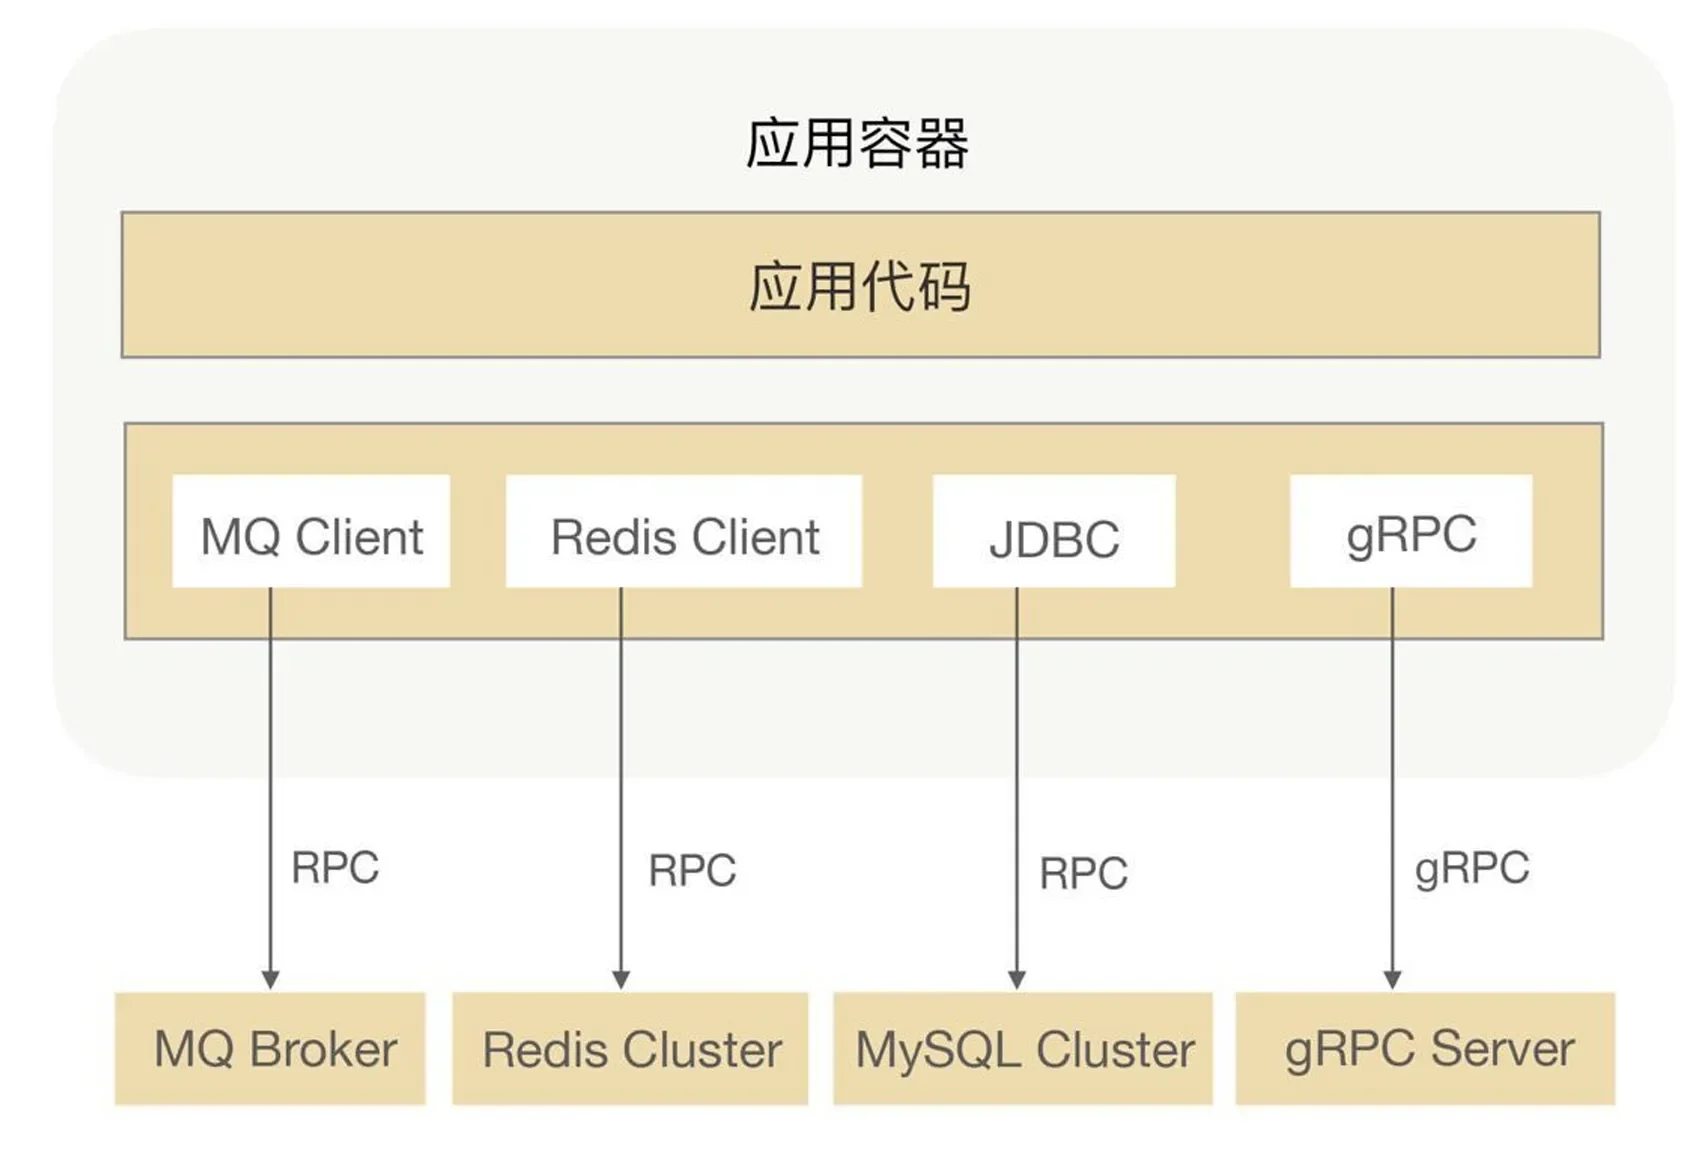
RPC ne sert pas qu’à communiquer — tu peux aussi viser une MQ, un cache distribué, une base.
RPC et HTTP sont tous les deux des protocoles de couche application.
Avant d’envoyer une requête RPC sur le réseau, on transforme les args de l’appel en binaire ; puis on écrit dans un Socket local, et la NIC envoie.
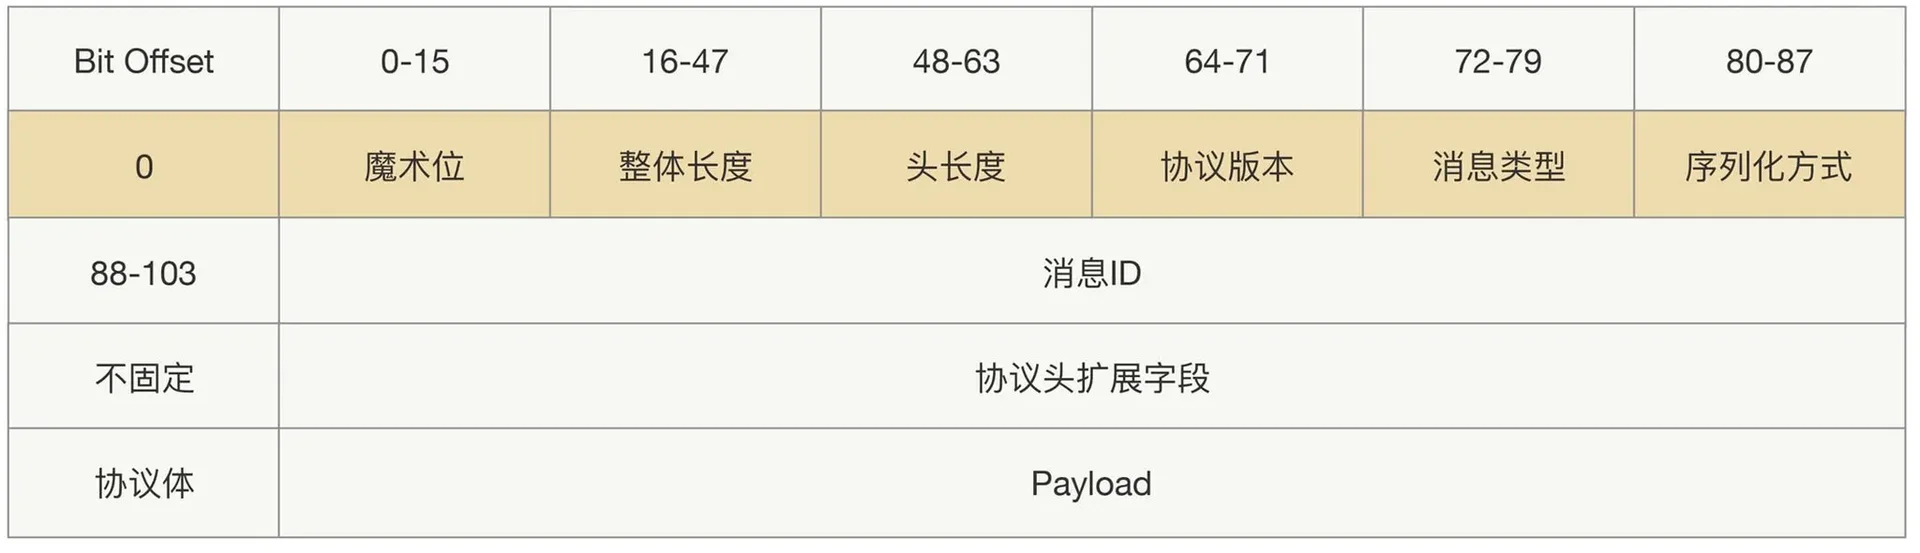
Pour un protocole extensible et rétrocompatible, le truc, c’est d’utiliser les champs d’extension du Header et du Payload, et de rester compatible via ces champs.
Choisir une sérialisation qui colle au cas.
Sérialisations courantes :
- Sérialisation native JDK
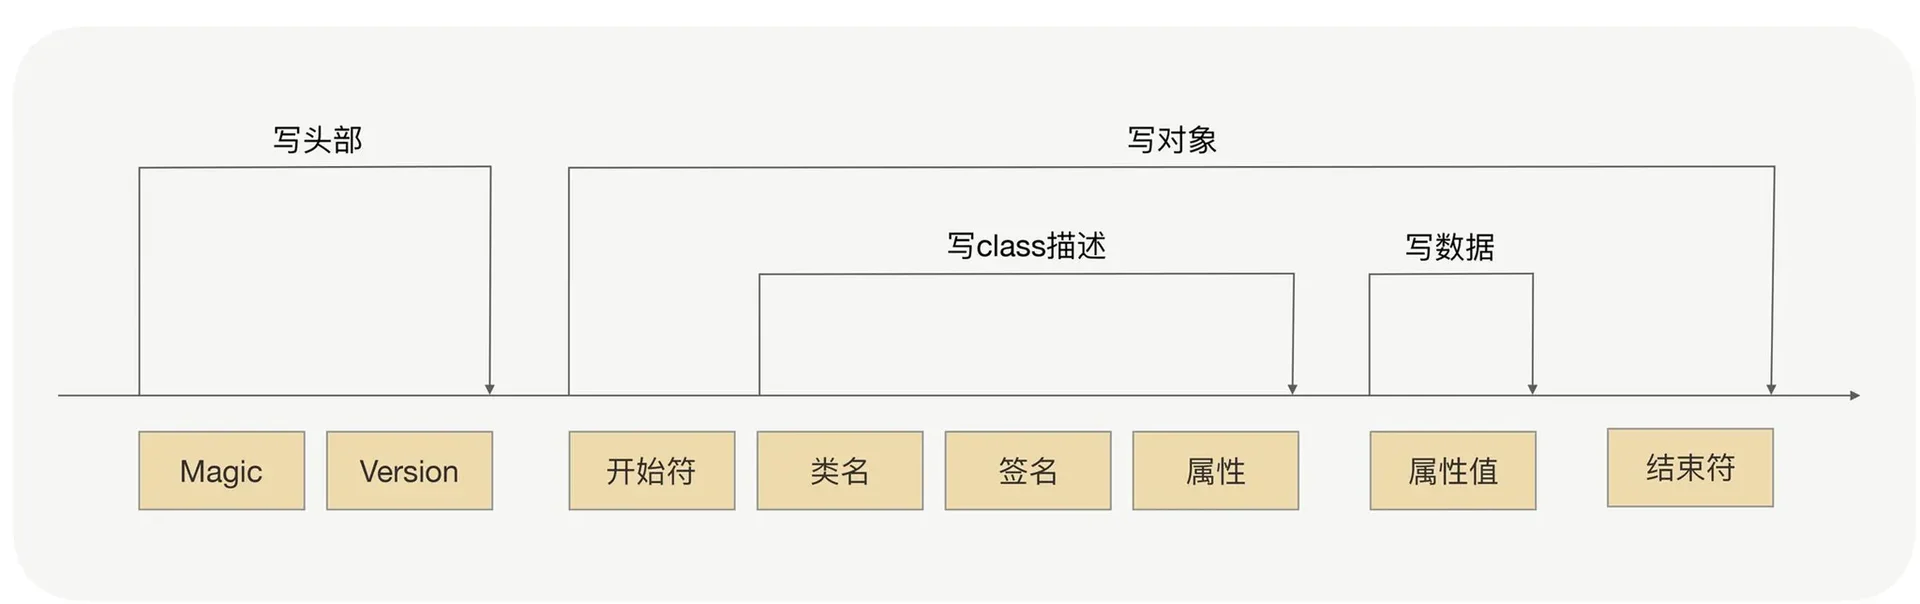
N’importe quel framework de sérialisation, au fond, c’est designer un protocole de sérialisation.
- JSON : key-value classique, pas de types, sérialisation texte.
Deux problèmes :
- Coût d’espace en plus, élevé — gros volumes = énorme mémoire et disque ;
- JSON n’a pas de types, donc un langage fortement typé comme Java passe par la réflexion, et c’est lent.
Donc si le RPC prend JSON, le volume entre provider et caller doit rester relativement petit, sinon la perf explose.
- Hessian : typage dynamique, binaire, compact, portable entre langages. Plus compact que JDK/JSON, bien plus rapide, moins d’octets.
- Hessian a ses bugs. La version officielle ne gère pas certains types Java courants.
- La famille Linked, LinkedHashMap, LinkedHashSet, etc. — on peut étendre CollectionDeserializer ;
- Locale — étendre ContextSerializerFactory ;
- Byte/Short deviennent Integer à la désérialisation
- Hessian a ses bugs. La version officielle ne gère pas certains types Java courants.
- Protobuf : standard interne Google, multi-langages, format de stockage structuré, utilisable pour sérialiser. Java, Python, C++, Go, etc. Tu définis une IDL (Interface description language), puis un compilateur IDL par langage génère les helpers. Avantages :
- Bien plus petit que JSON / Hessian après sérialisation ;
- L’IDL décrit clairement la sémantique, les types ne se perdent pas entre applis — pas besoin d’un parseur façon XML ;
- Sério / désério rapides, pas de réflexion pour les types ;
- Upgrades de format et compatibilité OK, on peut rester rétrocompatible.
Il existe un truc façon Protobuf Java qui n’a pas besoin d’IDL et désérialise des objets domaine Java directement. Efficacité proche de Protobuf, binaire identique — un Protobuf version Java. En vrai j’ai croisé des cas non supportés :
Autres : Message Pack, kryo, etc.
Ce qui pèse dans le choix :
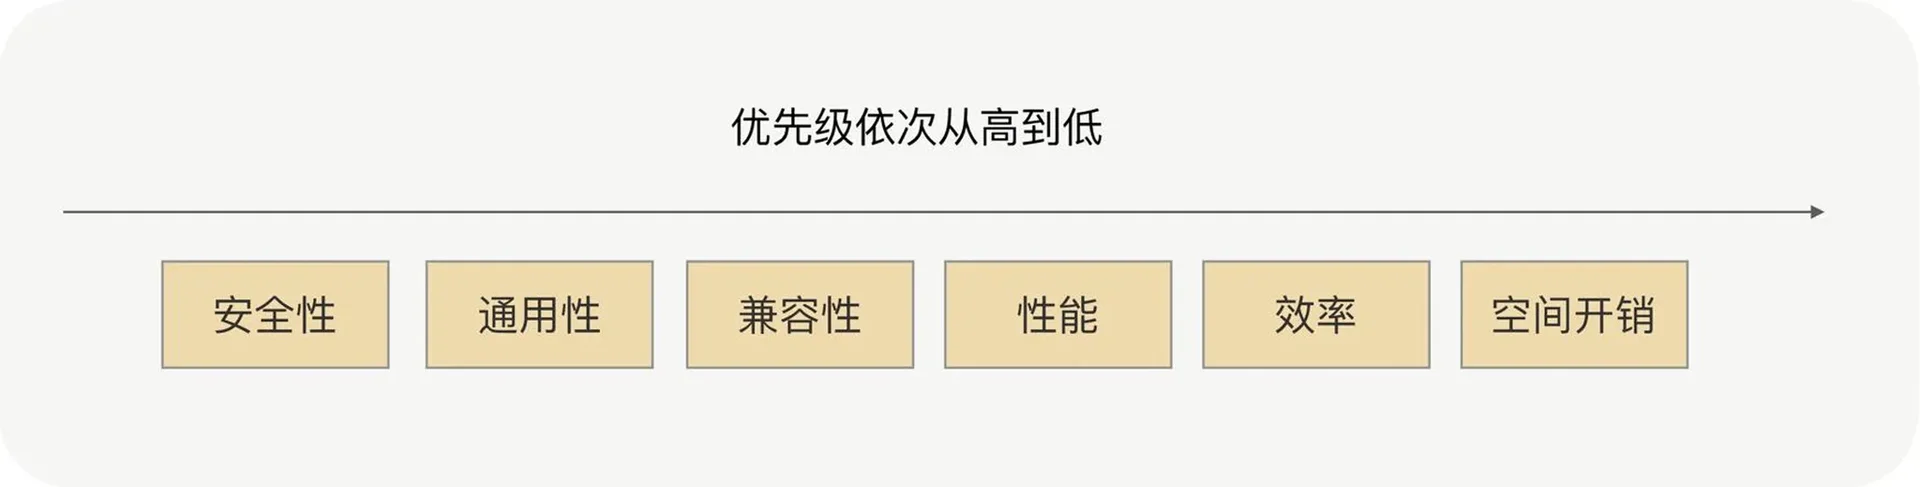
Le choix par défaut reste Hessian et Protobuf — perf, temps, espace, généricité, compat, sécu. Hessian plus simple à utiliser, mieux sur la compat des objets ; Protobuf plus efficace, plus général.
Points d’attention avec un framework RPC ?
- Objets trop tordus. Plein de champs, plusieurs niveaux d’imbrication.
- Objets trop gros.
- Une classe non supportée par le sérialiseur en param d’entrée.
- Héritage compliqué.
Quel modèle d’I/O réseau côté RPC ?
Modèles courants
- I/O bloquant synchrone (BIO)
- I/O non bloquant synchrone (NIO)
- Multiplexage I/O
- I/O non bloquant asynchrone (AIO)
Seul AIO est de l’I/O async ; le reste est sync.
L’I/O bloquant est le plus simple, le plus vu. Sous Linux, les sockets sont blocking par défaut. Le flux :
Le process fait un syscall I/O, il bloque, ça passe en kernel. Le kernel attend les data, copie vers la mémoire user, l’I/O est fini, retour au process. Puis le process se débloque et enchaîne le métier.
Deux phases côté kernel — attendre les data, copier les data. Pendant les deux, le thread I/O de l’appli reste bloqué. En Java multi-thread, chaque I/O tient un thread jusqu’à la fin.
Multiplexage I/O
Le plus utilisé en haute concurrence. Java NIO, Redis, Nginx en dessous, c’est ça. Reactor classique aussi.
L’I/O de plusieurs connexions s’enregistre sur un multiplexeur (select). Quand le process user appelle select, tout le process bloque. Le kernel « surveille » ces sockets ; dès qu’un a des data prêtes, select revient. Ensuite read, copie kernel → user.
Donc select bloque jusqu’à ce qu’un socket soit prêt, puis tu lis. Plus tordu que l’I/O bloquant, on dirait même plus coûteux. Le gain : un seul thread pour l’I/O de plein de sockets. Tu enregistres plusieurs sockets, tu boucles sur select, tu lis ceux qui se sont activés. En bloquant synchrone, il faut du multi-thread pour ça.
Pourquoi bloquant et multiplexage sont les plus courants ?
Il faut le kernel et le langage.
La plupart des kernels gèrent bloquant, non bloquant, multiplexage. I/O signal-driven et async, seulement les Linux un peu récents.
En C++ comme en Java, les frameworks réseau haute perf sont surtout Reactor, Netty côté Java. Reactor = multiplexage. Hors pic, le bloquant synchrone reste le plus vu.
Quel modèle pour RPC ?
La plupart des appels RPC sont haute concurrence. Kernel, langage, et le modèle lui-même : on prend le multiplexage. Pour le framework réseau du langage, le mieux c’est du Reactor — en Java, Netty (il y a d’autres NIO, Netty est le plus utilisé). Sous Linux, activer epoll (impossible sous Windows, le kernel ne l’a pas).
C’est quoi un modèle I/O réseau basé sur Reactor ?
Un modèle Reactor, c’est un modèle réseau haute perf, event-driven. Il découple l’écoute des événements I/O, leur dispatch, et le métier, pour gérer et répondre à beaucoup de connexions d’un coup. Cœur : multiplexage (Select, epoll, kqueue) qui surveille plein d’événements de connexion, et dispatch selon le type. Pas le gaspillage de threads de l’I/O bloquant.
Pièces :
- Reactor : écoute tous les I/O, et dans une Event Loop envoie les événements prêts au bon handler. Centre du modèle, souvent son propre thread. Un multiplexeur (Selector) poll les Channel enregistrés : connect, read, write.
- Acceptor : les nouvelles connexions, accepte le client, enregistre le nouveau SocketChannel sur le Reactor pour la suite.
- Handler : le boulot (lire, traiter, réécrire), typiquement :
Handler lecture : read-ready, lit le Channel, décode. Handler écriture : write-ready, encode le résultat, renvoie. Handler métier : calcul, DB, trucs lents, parfois un pool.
Zero copy
I/O kernel : attendre les data, copier les data. Attendre : la NIC reçoit, le kernel écrit chez lui. Copier : le kernel copie vers l’espace du process user.
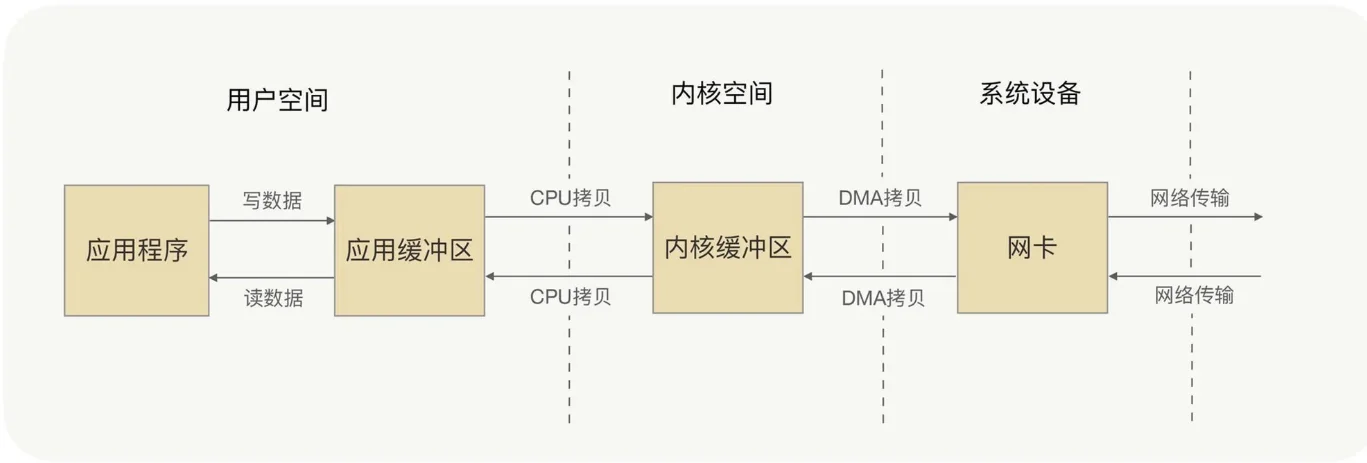
Chaque write de l’appli va dans un buffer user, le CPU copie vers le buffer kernel, le DMA copie vers la NIC, la NIC envoie. Deux copies avant de sortir. Le read, c’est l’inverse — encore deux copies avant que l’appli lise.
Un aller-retour complet copie user ↔ kernel, et chaque copie = un context switch CPU (user → kernel ou kernel → user).
Zero-copy
Zero-copy, c’est virer la copie entre user et kernel. Chaque read/write se fait comme si écrire/lire l’espace user, c’était écrire/lire le kernel, puis DMA kernel ↔ NIC.
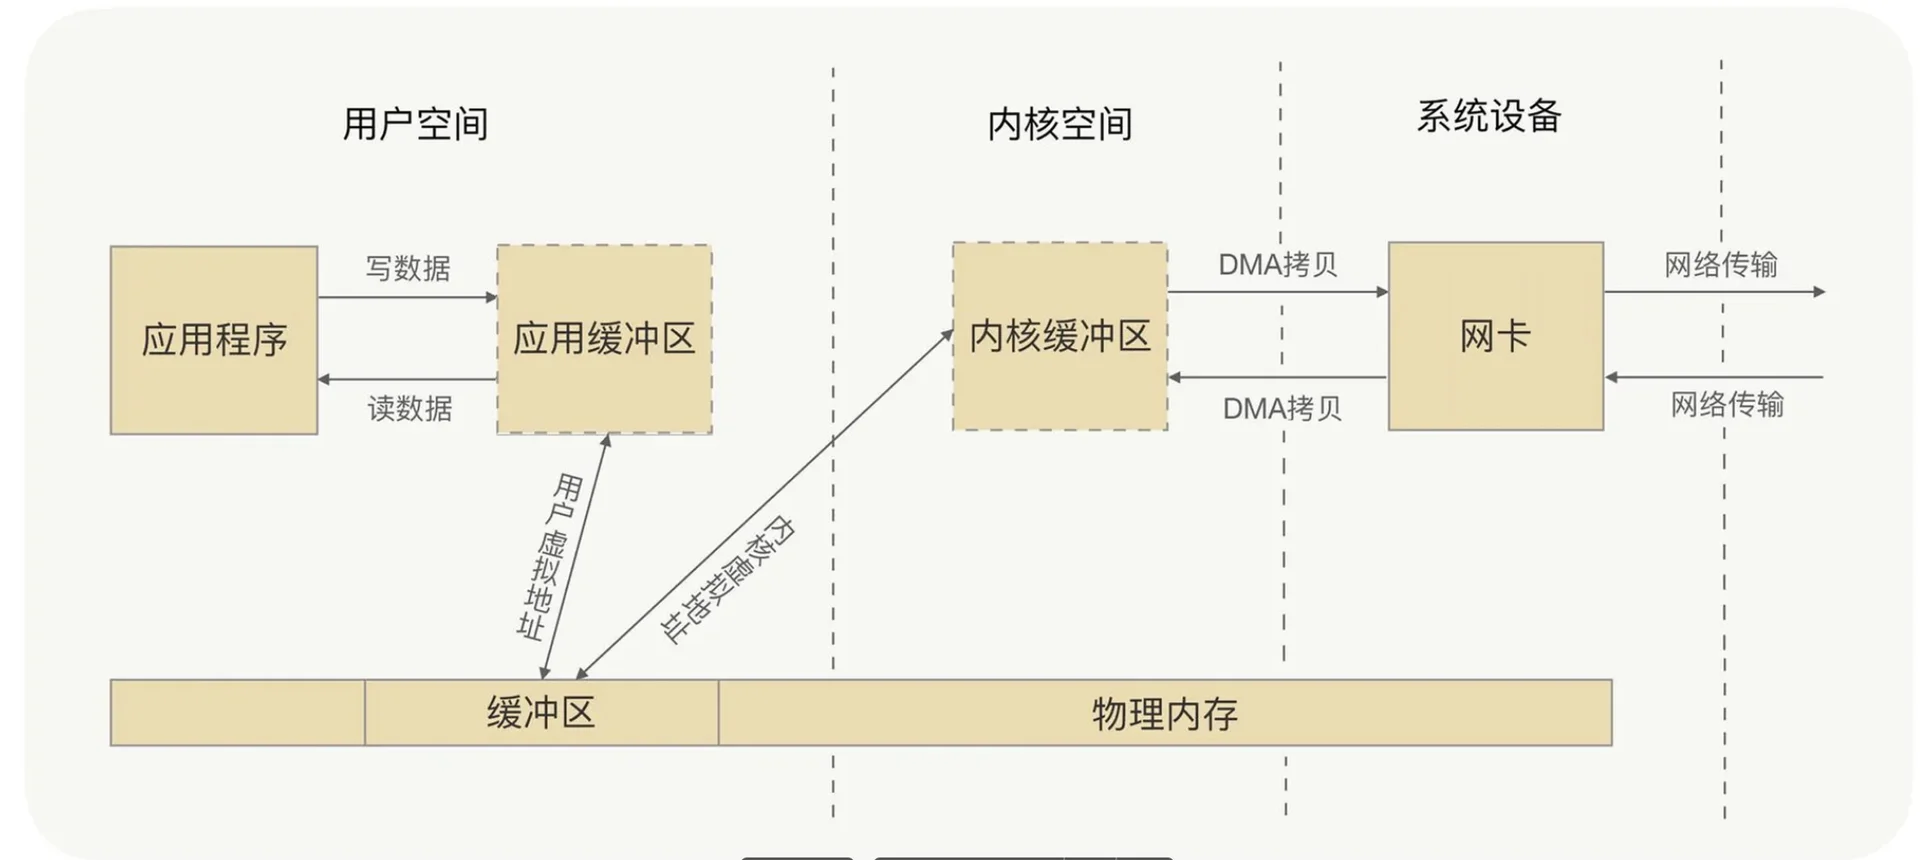
Deux voies
- mmap+write : mémoire virtuelle.
- sendfile
mmap+write
Principe :
- mmap mappe le buffer de lecture kernel dans l’espace d’adressage virtuel du process, mémoire partagée. Pas de copie kernel → buffer user, juste le mapping.
Transfert :
- 1re copie (DMA) : disque → buffer lecture kernel.
Mapping partagé : le user voit le buffer kernel via la VM.
- 2e copie (CPU) : au write, le CPU copie buffer lecture kernel → buffer Socket kernel.
- 3e copie (DMA) : buffer Socket → NIC.
Plus / moins :
Plus :
- Une copie CPU en moins (kernel → buffer user disparaît).
- L’appli peut toucher la mémoire mappée ; bien si tu dois prétraiter (modifier, compresser).
Moins :
- Encore 4 context switches (deux syscalls) et 3 copies.
- Le mapping a un coût ; un fichier tronqué peut péter (SIGBUS).
sendfile
sendfile fusionne read et write en un syscall ; le transfert reste en kernel.
Transfert (deux modes)
Base (pas de SG-DMA) :
- 1re copie (DMA) : disque → buffer lecture kernel.
- 2e copie (CPU) : buffer lecture kernel → buffer Socket kernel.
- 3e copie (DMA) : buffer Socket → NIC.
SG-DMA :
Deux copies DMA seulement : le buffer lecture kernel part vers la NIC en DMA Scatter/Gather, le CPU ne copie pas vers le Socket buffer.
Plus :
- Syscalls à 1, context switches à 2.
- Avec SG-DMA, vrai zero-copy (deux DMA seulement).
- Throughput clairement mieux ; gros fichiers.
Moins :
- Data invisible côté user ; tu ne peux pas la traiter avant d’envoyer.
- Dépend de l’OS et du hardware.
S’il faut prétraiter (modifier le fichier), mmap+write.
S’il faut juste envoyer vite sans toucher, sendfile d’abord (surtout avec SG-DMA).
Zero-copy dans Netty
Entièrement côté user, donc JVM. Le zero-copy de Netty, c’est surtout optimiser les manips de data.
- CompositeByteBuf : fusionner plusieurs ByteBuf en un ByteBuf logique, sans copie entre eux.
- slice sur ByteBuf : découper en plusieurs ByteBuf qui partagent la même zone, sans copie.
- wrap : wrapper byte[], ByteBuf, ByteBuffer en ByteBuf Netty, sans copie.
Netty wrappe aussi FileChannel.transferTo() de NIO dans FileRegion — même idée que sendfile Linux.
Proxy dynamique : programmer aux interfaces, cacher le pipeline RPC (j’ai pas lu le code, donc c’est pas hyper clair)
Sur le réseau, retenir — transport fiable.
RPC génère tout seul un proxy pour l’interface. Quand tu injectes l’interface, au runtime c’est ce proxy qui est bind. L’appel de méthode est intercepté, et c’est là que tu mets la logique d’appel distant.
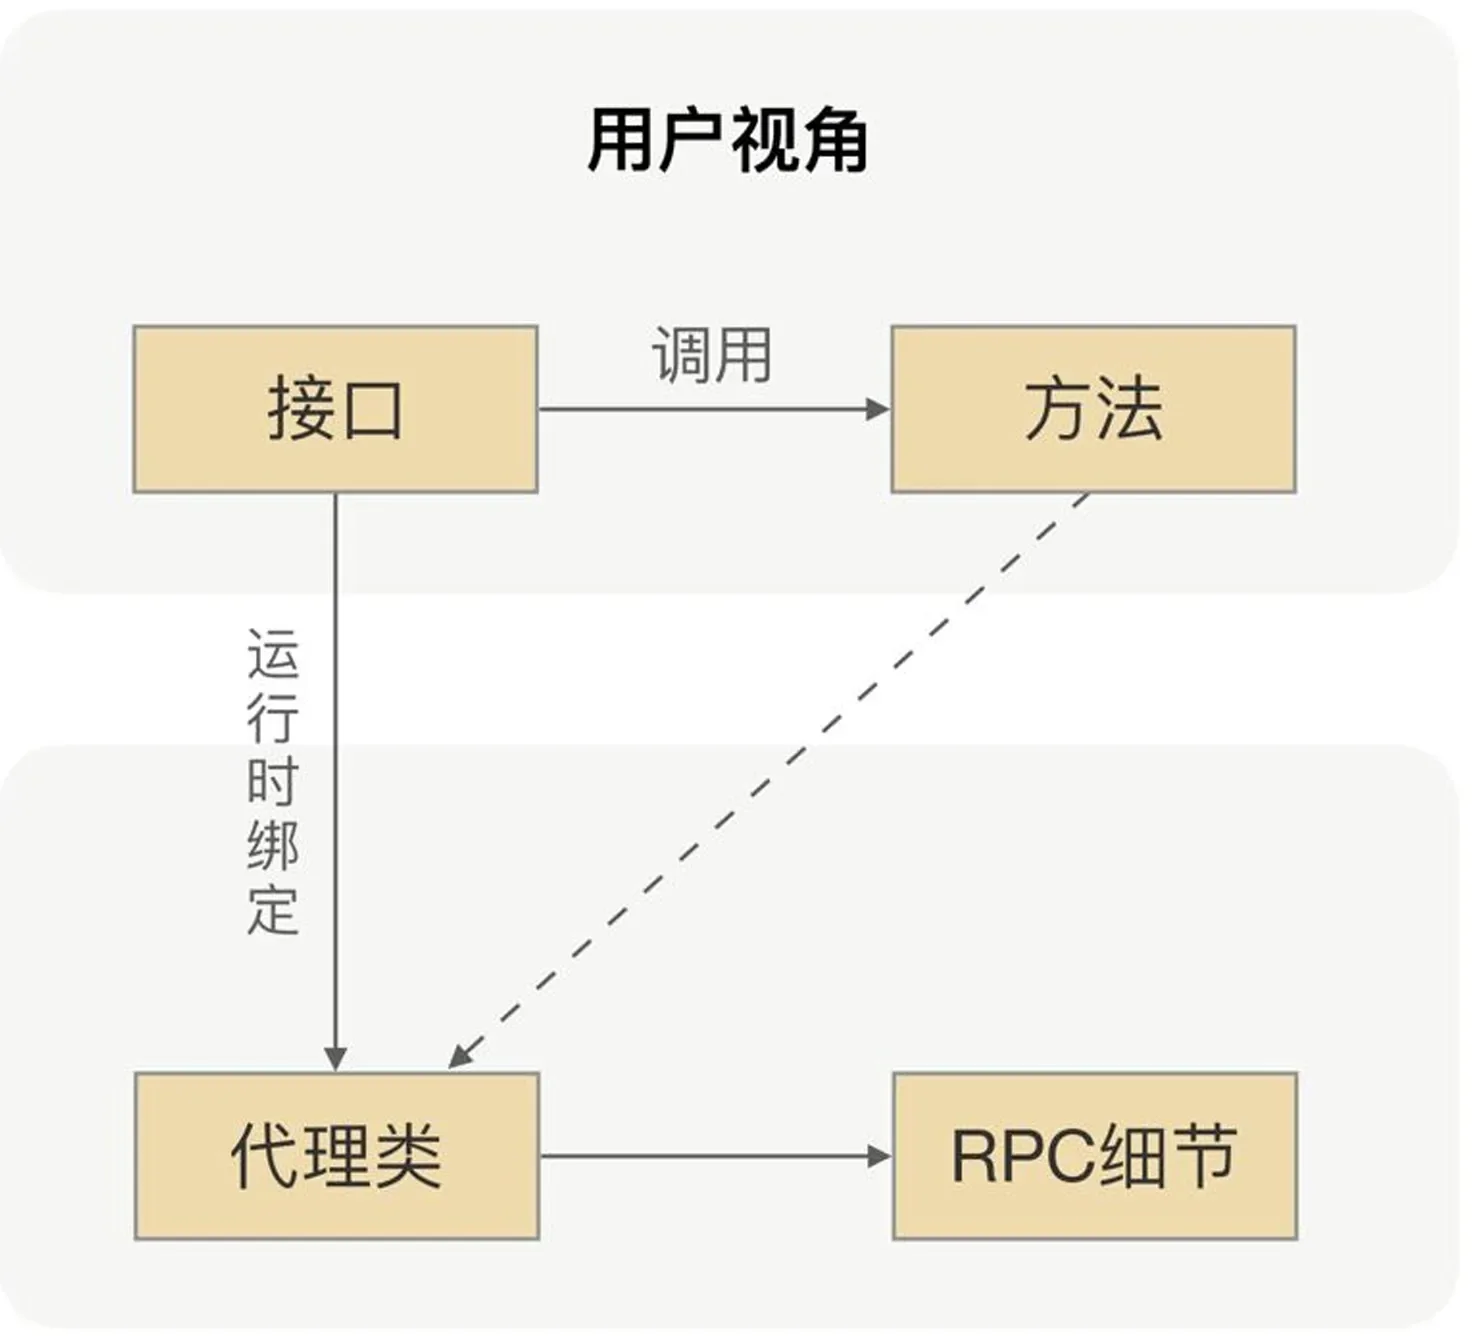
- Le proxy est généré au runtime, donc vitesse de génération, taille du bytecode, etc. pèsent sur la perf — plus le bytecode est petit, moins ça coûte.
- Le proxy intercepte chaque appel, donc il doit être rapide.
- Un framework de proxy simple à utiliser. API, communauté, complexité des deps.
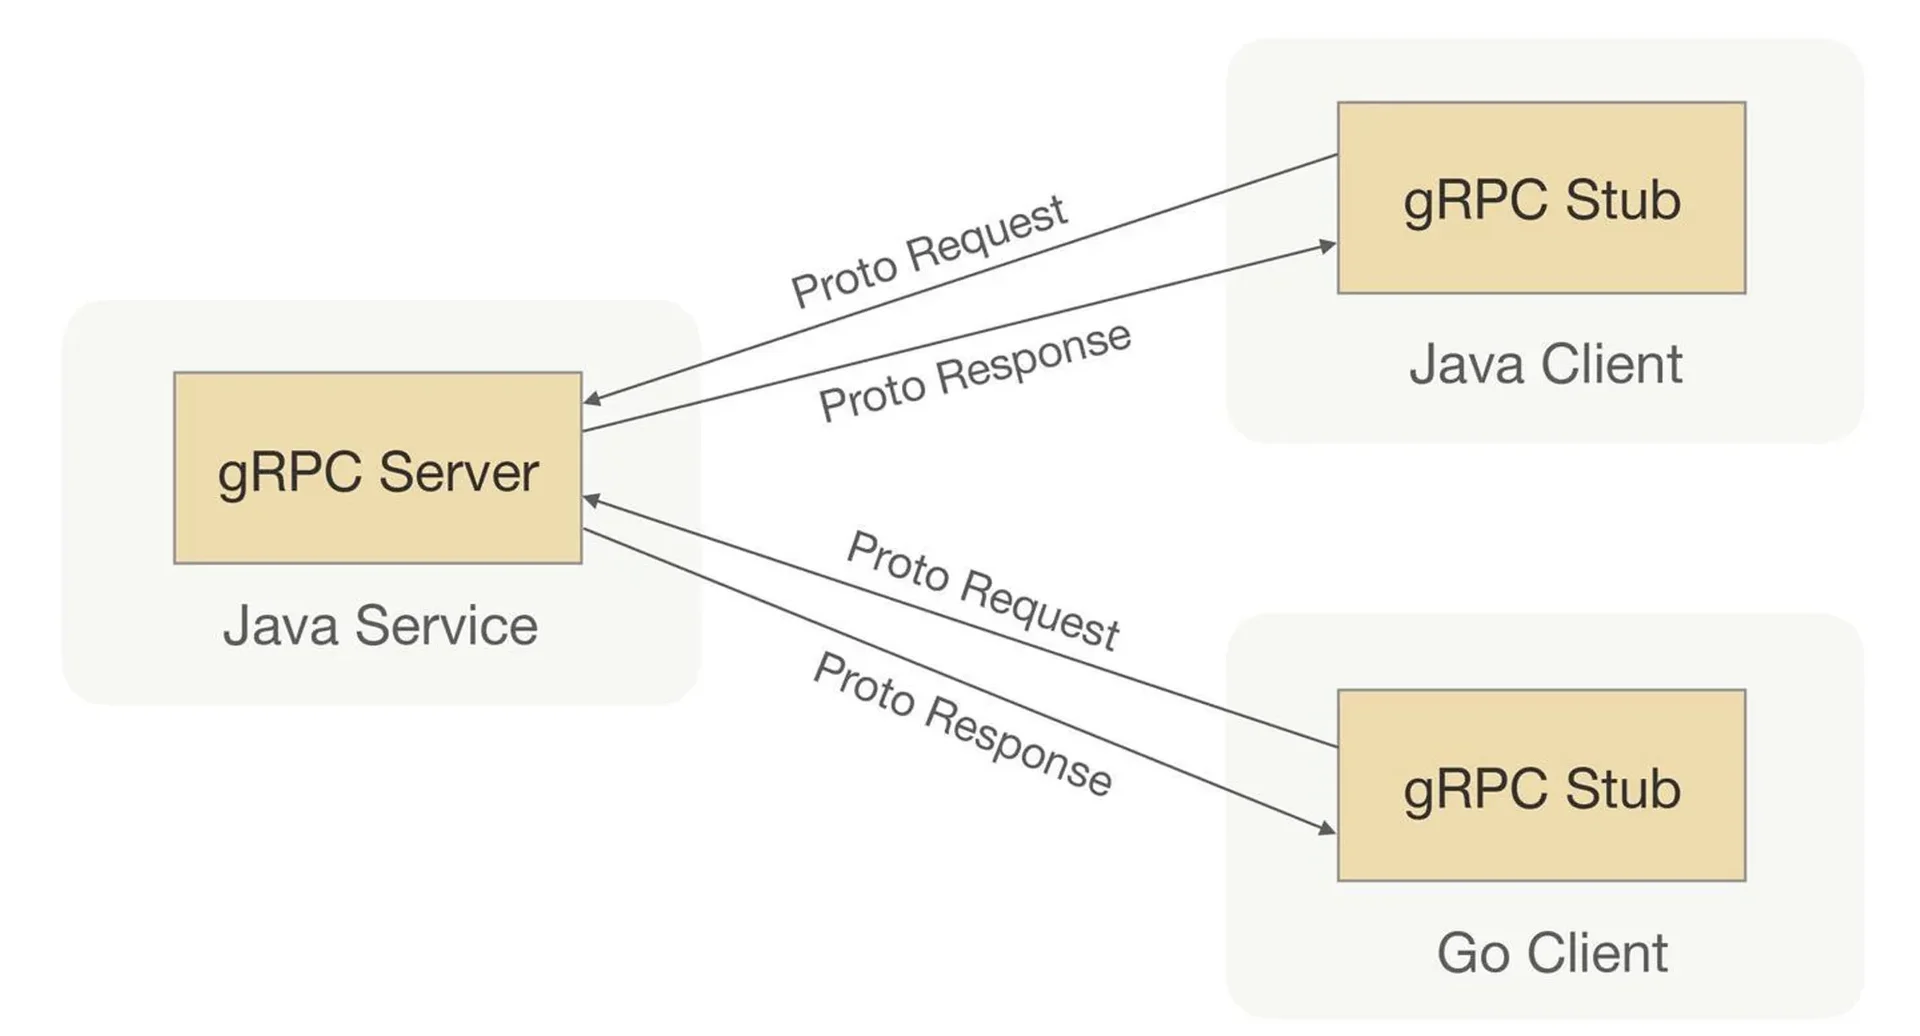
gRPC
Encapsulation de protocole
Après le binaire des args, il faut des « coupures de phrase » pour séparer les requêtes. Entre deux coupures, le binaire d’une requête. C’est l’encapsulation de protocole.
Découverte de services : CP ou AP ?
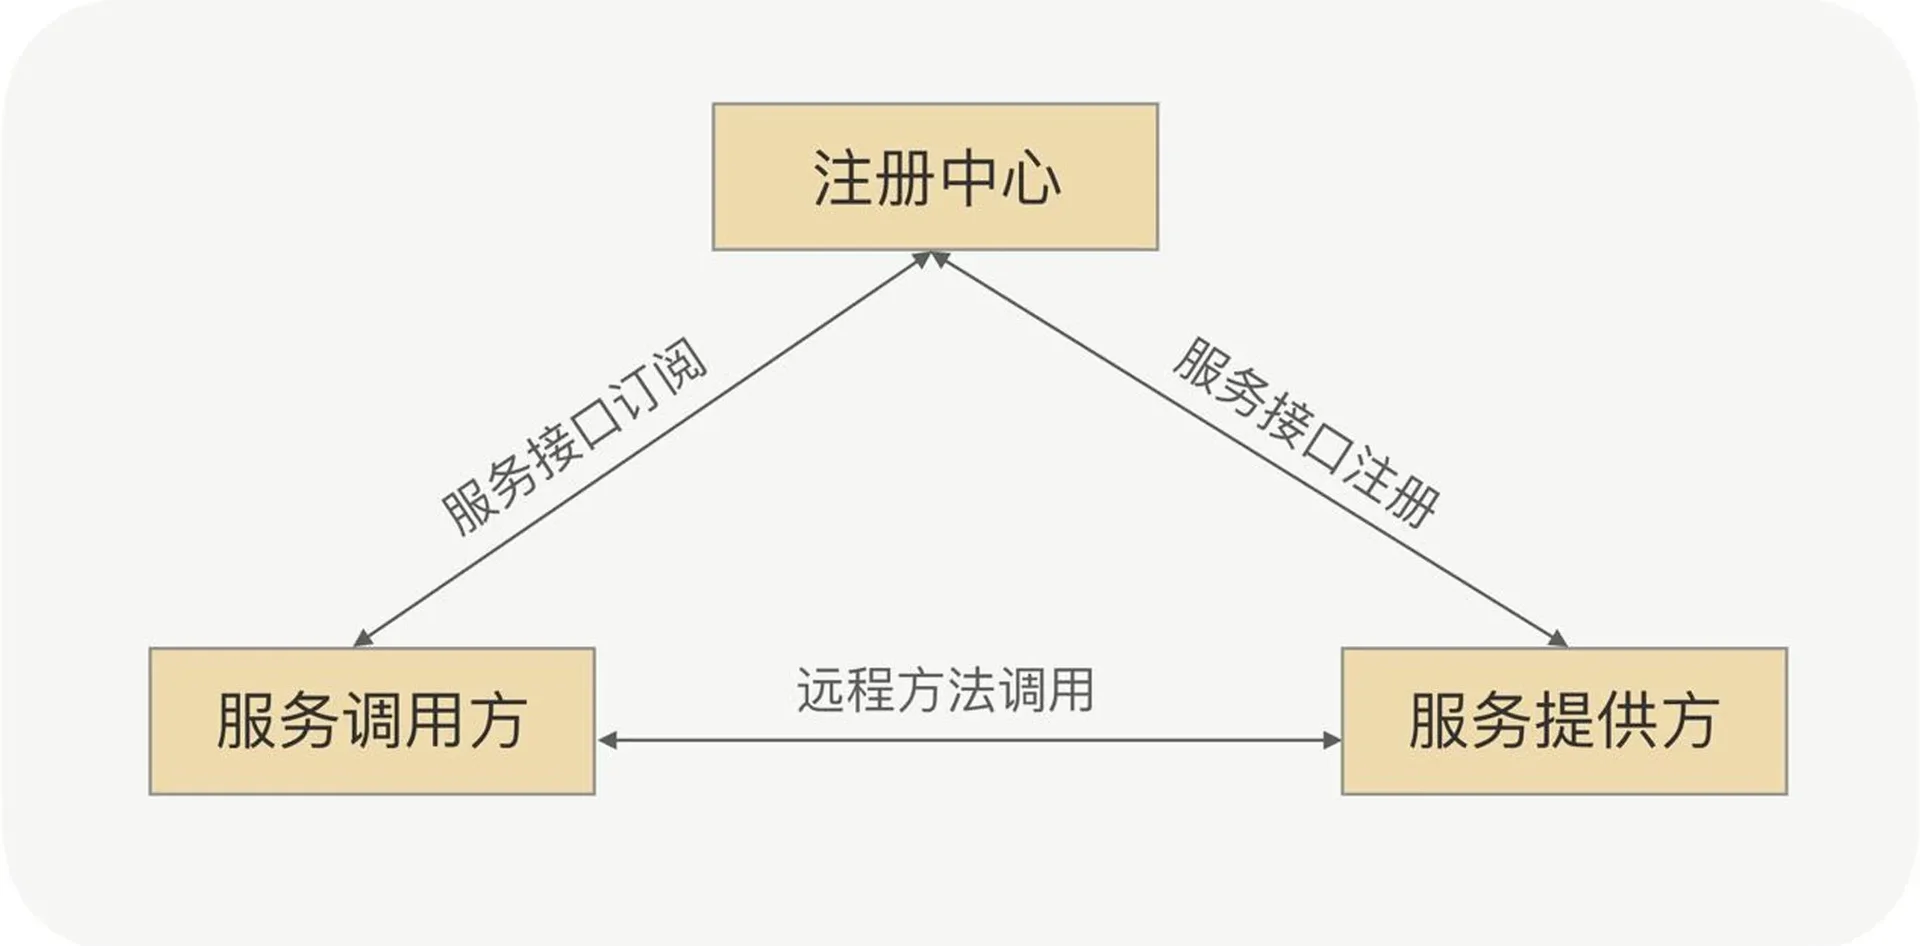
- Enregistrement : au démarrage du provider, il enregistre les interfaces exposées dans le registry ; le registry garde IP et interfaces de ce nœud.
- Abonnement : au démarrage du caller, il cherche et s’abonne aux IP des providers, cache en local, s’en sert ensuite.
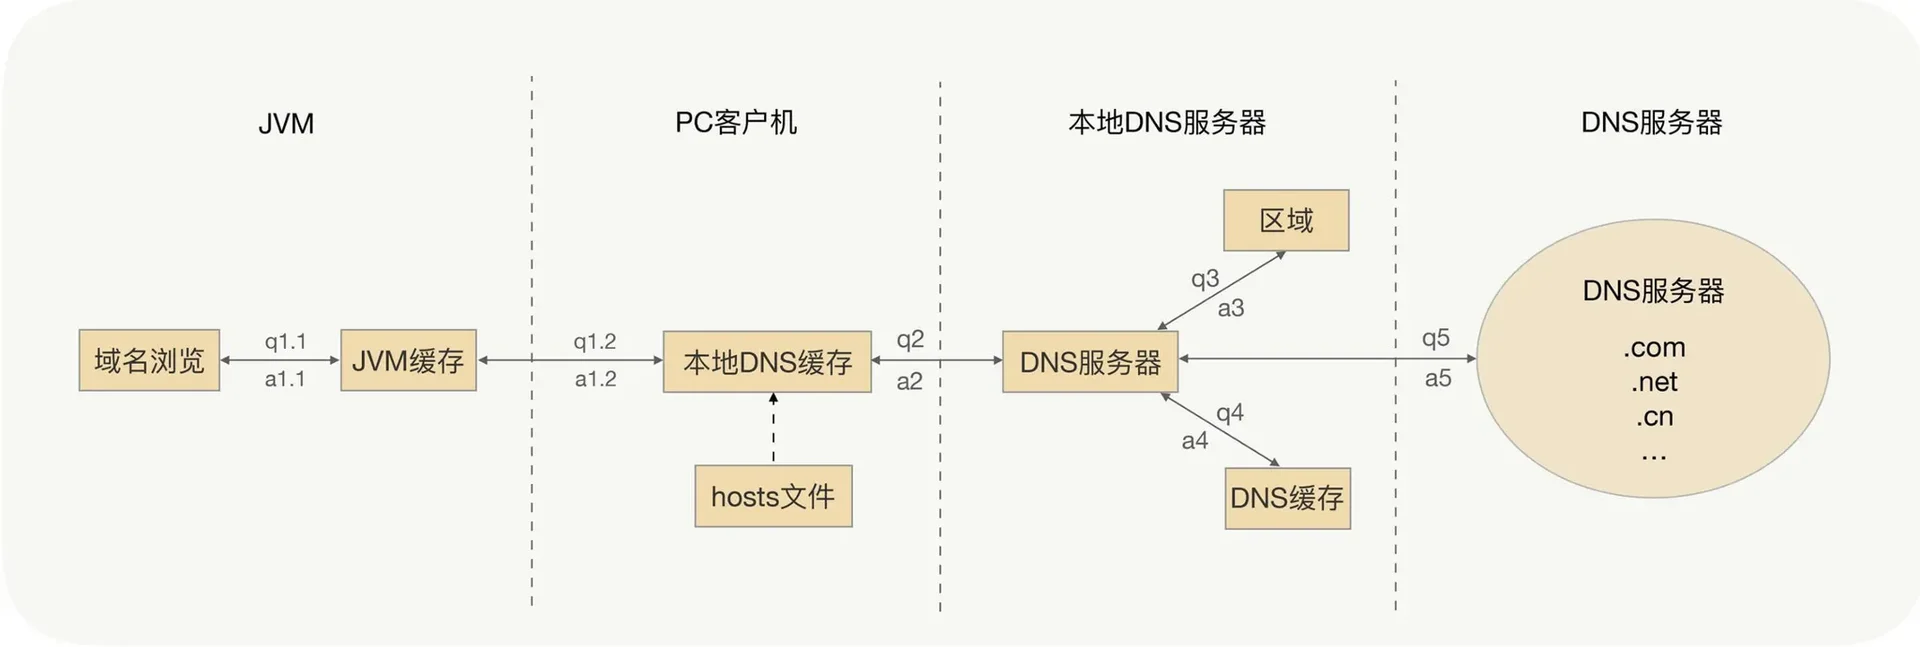
Si tu fais la découverte en DNS :
Tous les providers sous le même domaine, le caller peut tirer une IP au hasard via DNS et tenir une longue connexion. Ça a l’air ok, mais :
- Si un IP:port tombe, le caller peut-il retirer le nœud à temps ?
- Si une partie était déjà up et que tu scales, les nouveaux nœuds prennent-ils du trafic à temps ?
Réponse : non. Pour la perf et pour ménager le DNS, le DNS a plusieurs caches, souvent longs.
Découverte basée ZooKeeper
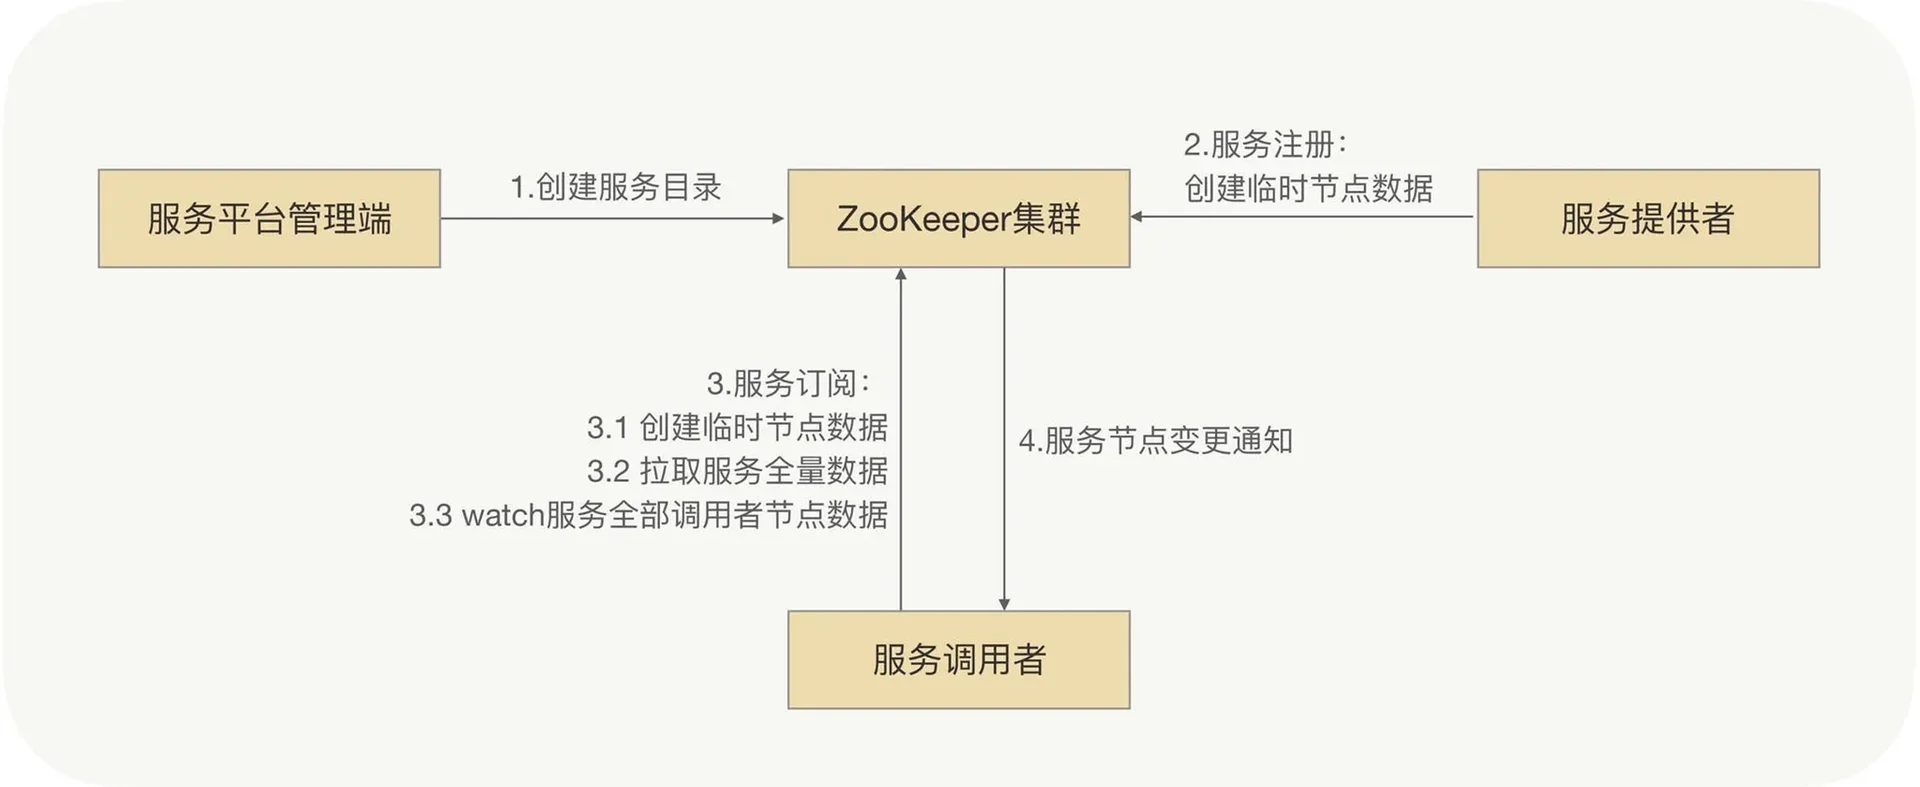
- L’admin de la plateforme crée d’abord une racine de service dans ZooKeeper, souvent le nom d’interface (ex.
/service/com.demo.xxService), puis un dir provider et un dir consumer, pour stocker les infos des nœuds. - Quand un provider s’enregistre, il crée un nœud éphémère sous le dir provider avec ses infos.
- Quand un caller s’abonne, il crée un nœud éphémère sous le dir consumer, et watch tous les nœuds sous le dir provider (
/service/com.demo.xxService/provider). - Quand les data sous le dir provider changent, ZooKeeper notifie les callers abonnés.
Un registry finalement cohérent, sur un bus de messages
Le gros trait de ZooKeeper, c’est la cohérence forte. Chaque update sur un nœud est appliquée en même temps sur les autres. Data identiques en temps réel sur chaque nœud — d’où la baisse de perf du cluster.
Pour la découverte RPC, quand un nœud vient de monter, le caller peut vivre avec le découvrir quelques secondes plus tard. Quelques secondes (ou plus) sans trafic après le start, ça ne change rien au cluster. On peut lâcher CP (cohérence forte) et prendre AP (cohérence à terme) pour la perf et la stabilité du registry.
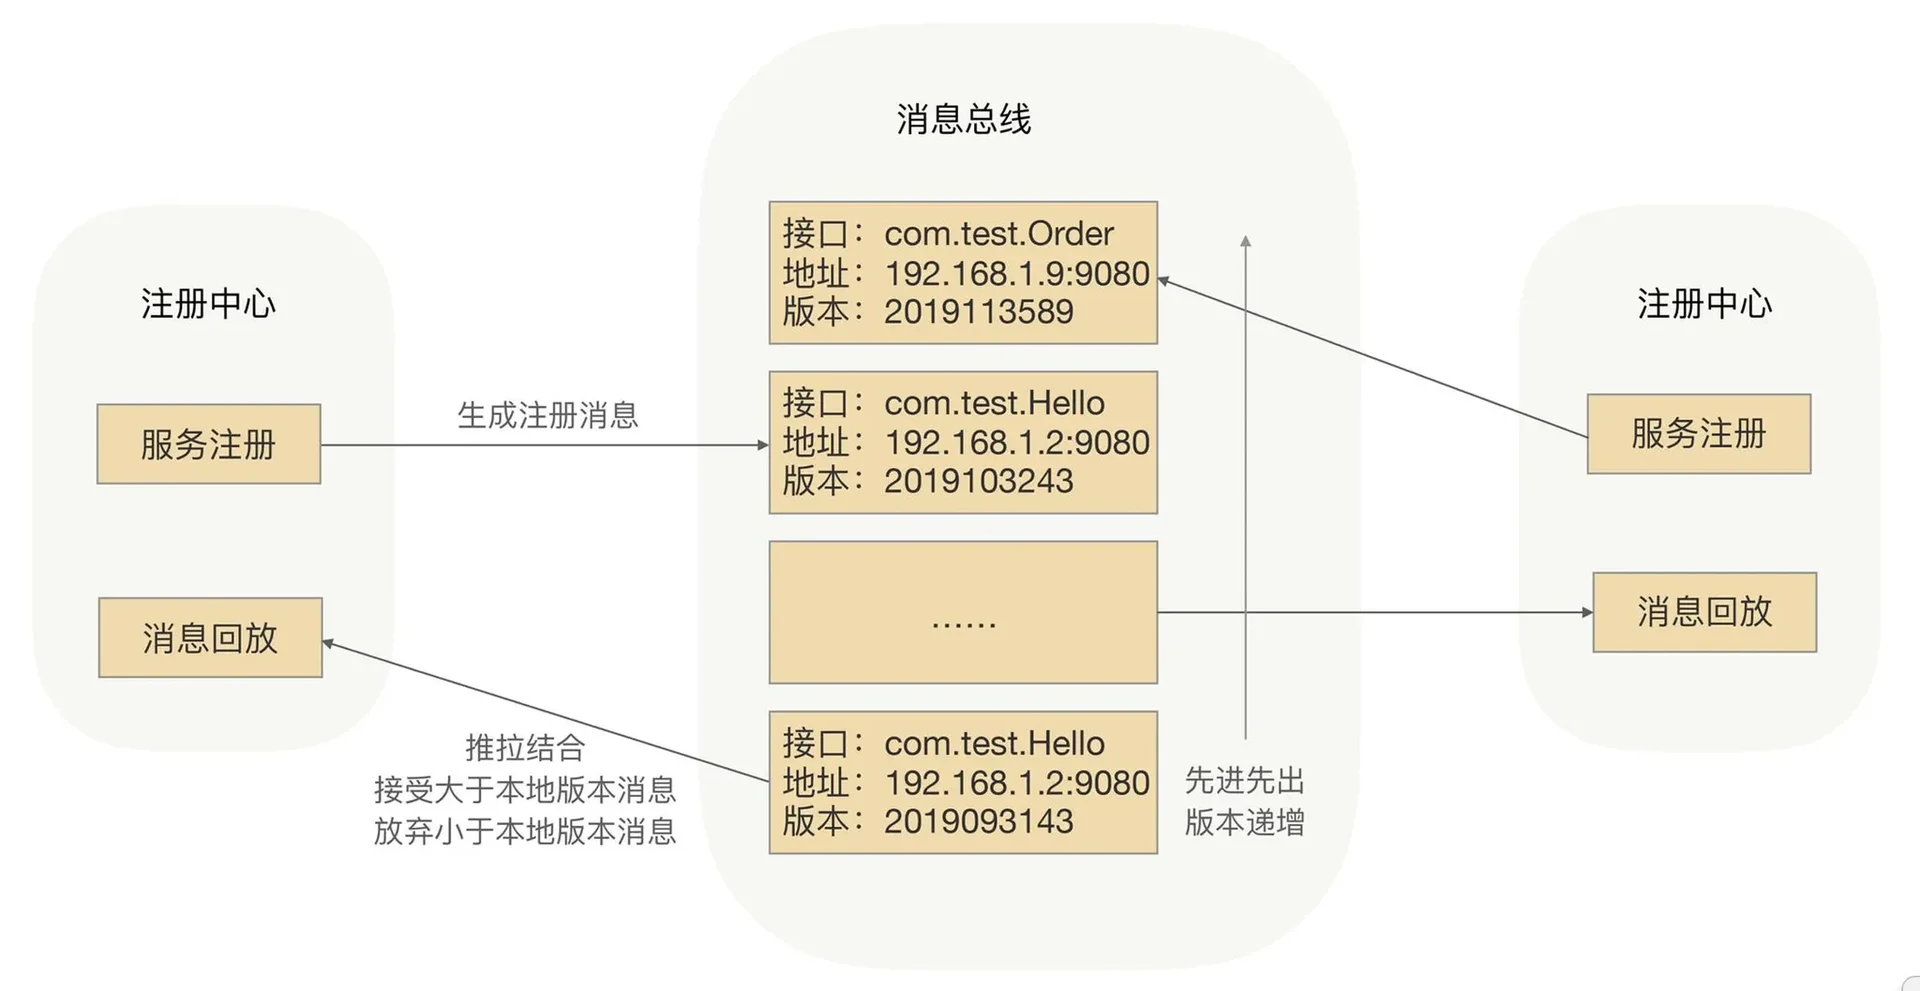
Si tu veux la cohérence à terme, un bus de messages est une option. Les data d’enregistrement peuvent être entièrement en cache dans chaque registry, sync via le bus. Un nœud reçoit un register, pousse sur le bus, les autres mettent à jour et redistribuent — cohérence à terme entre registries :
Postface
Ensuite je devrais lire un peu de code gRPC et Kitex, et il y a les articles du compte cloud native ByteDance à bosser. Le vrai truc important, c’est de poser les projets open source et d’accrocher les bases.