
幾個月前 Manus 發了一篇講 Context Engineering 的博客。
https://manus.im/blog/Context-Engineering-for-AI-Agents-Lessons-from-Building-Manus
你不需要把所有 context 都放在 agent 的 messages history 裡,所以我們需要 context offloading。
Langchain experience
Offload context to a file system
這裡最流行的想法之一就是用 file system。
以 tool message 的輸出為例,把它 dump 到檔案系統,只把最必要的一小段資訊送回給 agent,讓它需要時能引用完整 context,但那個完整 payload,比如非常吃 token 的網頁搜尋結果,就不會永遠塞進你的 context window。
offloading context 就是拿一塊很吃 token 的資訊,比如 tool message,不要整段塞回 messages list,而是 dump 到檔案系統,只在需要時再取。
Reduce context
用摘要或壓縮來減少 context。總結 tool call 輸出是一種很直覺的做法。所以這種把舊的 tool call、tool output 或 tool message 剪掉的想法,Claude 現在差不多已經內建進他們的 SDK 了。
Cognition(一個 agent 應用)也講過在 agent-to-agent handoff 時做 summarization / pruning。
Retrieve Context
Claude Code Force 只用檔案系統和簡單搜尋工具,主要是 glob 和 grep。所以 agent 按需取回 context 有不同做法。
Indexing 和語義搜尋,檔案系統和簡單檔案搜尋工具,兩者都可以非常有效。
Context isolation
Context isolation 很重要,尤其是把 context 拆到多個 agent。
每個 sub-agent 有自己的 context window,sub-agent 可以做 separation of concerns。
Caching Context
langchain open deep research
https://github.com/langchain-ai/open_deep_research
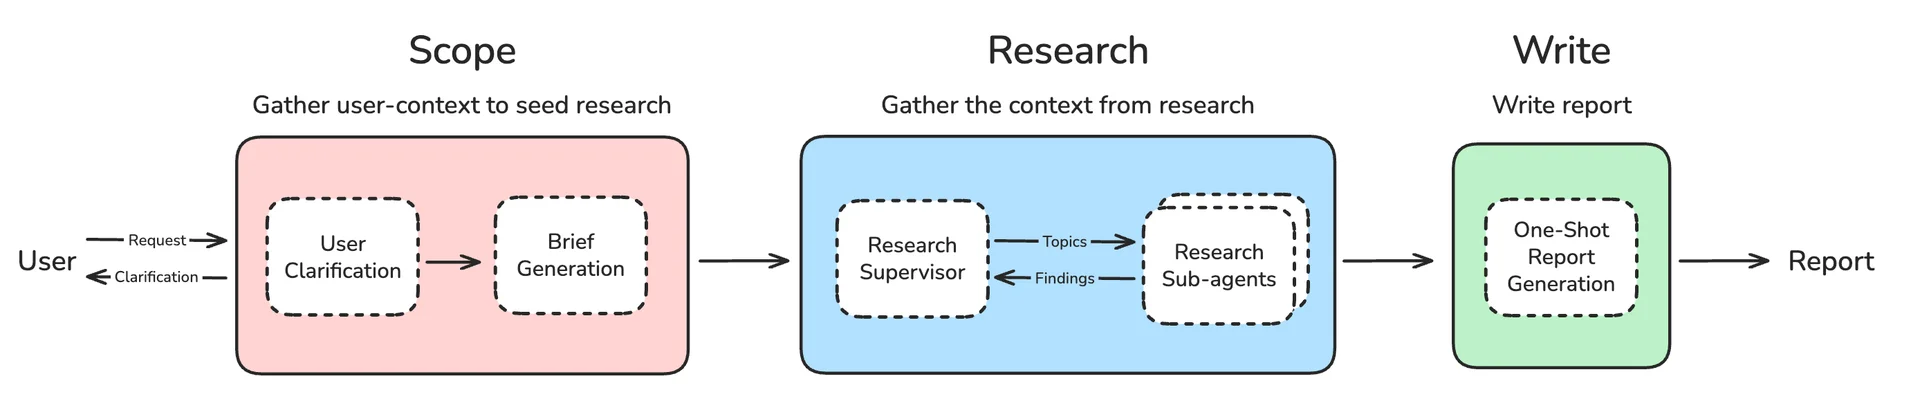
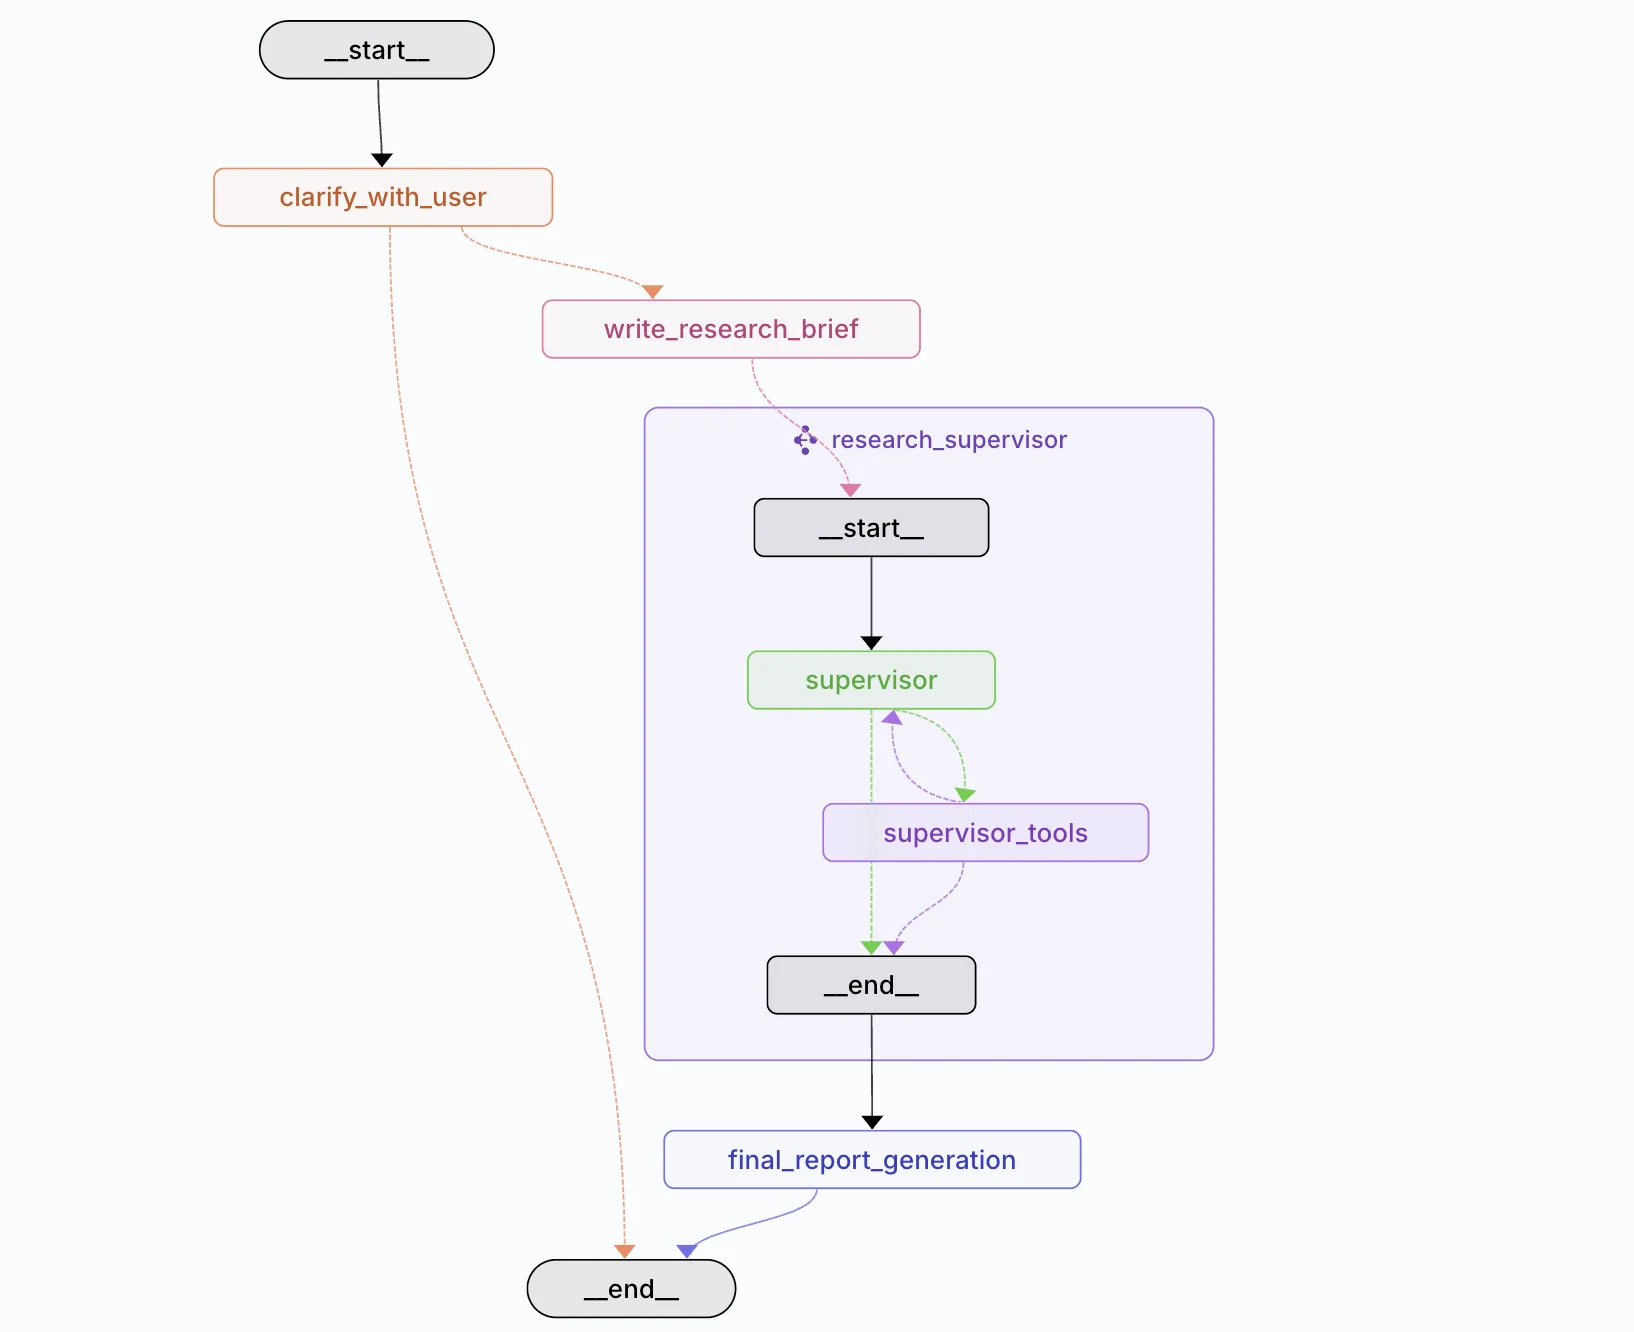
它有三個階段:研究的 scoping、用 multi-agent 架構做研究本身,然後最後一個 one-shot 寫作階段。我們用 offloading,基本上先寫一份 brief 來框定研究計畫。
我們把它 offload 出去,而不是只存在 context window 裡,因為那個 window 後面還會被別的東西塞滿。
我們把它獨立存起來,我們這邊是從 LangGraph state 取,也可以從檔案系統取,是同一個想法。
所以你建立研究計畫,offload 它,它永遠可取。你去做一堆工作,再按需拉回來,放到 message list 末尾,讓 agent 隨時能拿到,比如寫作階段。
可以看到我們用 offloading 來引導研究和寫作階段。我們用 reduction 去總結那些很吃 token 的 surf tool call 的 observation,這是在研究內部做的。
研究內部的 sub-agent 之間也用 context isolation。這大概是把很多專案裡這些不同想法總結了一下。
Manus experience
不要太早去做 specialized models,startup 應該盡可能長時間靠 general models 和 context engineering。
Context Reduction: Compaction vs. Summarization
compaction 這塊,在 Manus,每個 tool call 和 tool result 其實有兩種格式:full 和 compact。
compact 版本會剝掉任何能從檔案系統或外部狀態重建的資訊。比如你有一個寫檔工具,大概有兩個欄位,path 和 content。
工具返回之後,你可以確保檔案已經在環境裡了。所以 compact 格式裡我們可以安全丟掉超長的 content 欄,只留 path。
如果 agent 夠聰明,下次要讀這個檔,用 path 再取就行。資訊沒有真的丟,只是外置了。
我們覺得這種可逆性很關鍵,因為 agent 會根據先前的 action 和 observation 做鏈式預測,你永遠不知道哪個過去的動作十步之後會突然變得超重要。
你預測不了。所以這是用 compaction 做的可逆 reduction。
當然 compaction 只能走到這一步。最終 context 還是會漲,會撞到天花板,那時我們把 compaction 和更傳統的 summarization 合在一起,但做得非常小心。
比如摘要之前,我們可能先把 context 的關鍵部分 offload 進檔案。有時更激進,把整個摘要前的 context dump 成文字檔或 log 到檔案系統,以後隨時能恢復。
Lance 剛也提到,有人就用 glob 和 grep。glob 對 log 檔也適用。模型夠聰明的話,它甚至知道怎麼把那些被摘要掉的、摘要前的 context 找回來。
差別在於 compaction 可逆,summarization 不可逆。兩者都縮短 context,但行為很不一樣。
要讓兩種方法共存,我們得追蹤一些 context 長度閾值。最上面是模型的硬上限,比如 100 萬 token,今天很常見。
但實際上大多數模型更早就開始退化,大概 200k 左右,你會開始看到我們說的 context rot,重複、推理變慢、品質下降。
所以大量 evaluation 很重要,你要找出那個 rot 前的閾值,通常是 128K 到 200K,用它當 context reduction 的觸發點。
context 大小靠近它時,就要觸發 reduction,但從 compaction 開始,不是 summarization。
compaction 也不是把整段歷史都壓掉。我們可能只 compact 最舊 50% 的 tool call,新的仍保留完整細節,讓模型還有新鮮的 few-shot 範例,知道工具該怎麼用。
否則最壞情況,模型會模仿 compact 格式,輸出缺欄位的東西,那就完全錯了。
compaction 之後,我們還要看這次到底騰出了多少 context。有時像圖裡,多輪 compaction 之後收益很小,因為 compact 了也還佔 context。
那時才去做 summarization,但記住,摘要時永遠用 full 版本的資料,不是 compact 的。
最後幾個 tool call 和 tool result 仍保留完整細節,不做摘要,讓模型知道自己停在哪,能更順地繼續。
否則摘要之後模型有時會換風格、換語氣,我們發現留幾個 tool call / tool result 範例真的有幫助。
Context Isolation: Communicating vs. Sharing Memory
Cognition 的博客警告不要用 multi-agent,因為多個 agent 之間同步資訊會變成噩夢。
Multi-process 或 multi-thread 協調 在早期程式設計就是經典難題,我覺得這裡可以借一點智慧。
Go 社群有句有名的 gopher 話:「Do not communicate by sharing memory, instead share memory by communicating.」
https://chatgpt.com/share/68f4f8c3-baac-8004-9cf7-421375260909
當然這不是直接講 agent,對 agent 有時甚至是錯的,但重點是它標出兩種不同模式:by communicating 或 by sharing memory。
如果把這裡的 memory 翻譯成 context,對應就很清楚。「By communicating」比較好懂,就是經典的 sub-agent 設定。
比如主 agent 寫一個 prompt,送給 sub-agent,sub-agent 的整個 context 只有那條指令。
我們覺得如果任務指令短而清楚、只關心最終輸出,比如在 codebase 裡搜一段 snippet,就用 communication pattern,保持簡單。
因為主 agent 不在乎 sub-agent 怎麼找到程式碼,只要結果。
這就是 Claude Code 做的,通常用它的 task tool 把一個分開的、清楚的任務委派給 sub-agent。
更複雜的場景,「by sharing memory」意味著 sub-agent 能看到先前全部 context。所有 tool use、tool 歷史,但 sub-agent 有自己的 system prompt 和 action space。
比如 deep research,最終報告依賴大量中間搜尋和筆記。那時你該考慮 share memory,或我們說的「by sharing context」,因為就算你把筆記和搜尋都存檔再讓 sub-agent 全部重讀,你只是在浪費延遲和 context。
算 token 的話,可能還用得更多。所以需要完整歷史的場景,就用 share memory。
但要注意 sharing context 很貴,每個 sub-agent 的 prefill 輸入更大,input token 花更多,而且 system prompt 和 action space 不同,KV cache 不能複用,得付全價。
Context Offloading: Layered Action Space
人們說 offload,通常是指把工作 context 的一部分挪到外部檔案。
但系統長大之後,尤其有一天你要接 MCP,會發現工具本身也會佔很多 context,context 裡工具太多就會混亂。
我們叫它 context confusion,模型可能調錯工具,甚至調不存在的。
所以工具也得 offload。現在常見做法是對 tool description 做 dynamic RAG,比如按當前任務或狀態按需載入工具。
但這也有兩個問題。第一,tool definition 坐在 context 最前面,KV 每次都會 reset。
更重要的是,模型過去對已移除工具的呼叫還在 context 裡,可能騙模型去調無效工具或用無效參數。
為了解這個,Manus 在實驗一種新的 layered action space。本質上讓 Manus 從三層抽象裡選:一、function calling;二、sandbox utilities;三、packages and API。
我們再往這三層走。先從 level one,function calling,這是經典,大家都知道。靠 constraint decoding 是 schema safe 的,但缺點也都知道。
比如我們提到會打破 cache,工具太多會造成混亂。
所以 Manus 用固定數量的 atomic function,比如讀寫檔、執行 shell、在網路上搜檔、還有一些瀏覽器操作。
這些 atomic function 邊界非常清楚,可以組合出更複雜的 workflow。
其餘全部 offload 到下一層,sandbox utilities。你知道每個 Manus session 跑在完整的虛擬機 sandbox 裡,跑在我們自己客製的 Linux 上,所以 Manus 可以用 shell 去跑我們為它開發的預裝工具。
比如格式轉換、語音辨識,還有一個很特別的,我們叫 MCP CLI,就是我們怎麼調 MCP。
我們不把 MCP 工具注入 function calling space。全部在 sandbox 裡透過命令列做。
utilities 很好,因為你可以加新能力而不動模型的 calling space,就是電腦上預裝的一些命令。
熟悉 Linux 的話,你永遠知道怎麼找新命令,甚至可以跑 --help 搞懂新工具怎麼用。
另一個好處是大輸出可以直接寫檔,或分頁返回結果。
你還能用 grep、cat、less、more 這些 Linux 工具當場處理結果。trade-off 是對大輸出超好,但對跟前端低延遲來回互動不太好。
因為你總要把 agent 的互動視覺化給使用者看。
然後還有最後一層,packages and APIs。這裡 Manus 可以寫 Python script 去調預授權的 API 或自訂套件。
比如用 3D 設計庫建模,或調金融 API 拉行情。這些 API 其實是我們替使用者買的、替他們付錢。
包含在訂閱裡。所以 Manus 裡預裝了很多 API key,它能用這些 key 去訪問。
我覺得這很適合需要大量記憶體內計算、但不需要把所有資料推進模型 context 的任務。
比如分析一支股票一整年的價格,不要把所有數字餵給模型。應該讓腳本算完,只把摘要放回 context。
而且 code 和 API 非常 composable,你可以在一步裡串很多事。
比如典型 API,拿城市名、拿 city ID、拿天氣,全寫在一個 Python script 裡。
我朋友還有一篇叫 Code Act 的論文,很多人在討論。我覺得是同一個想法,因為 code 可組合,一步能做很多事。
但它不是 schema safe。對 code 做 constrained decoding 非常非常難。
所以要為這些能力找對場景。我們這邊,能在 compiler 或 interpreter runtime 裡處理的,就用 code。
否則用 sandbox utilities 或 function calls。
好處是從模型角度看,這三層仍然都走標準 function call,介面保持簡單、對 cache 友好、各 function 正交。
因為 sandbox utilities 你還是用 shell tool、shell function 去訪問。
用第三方 API 時,你也只是用 file function 寫讀檔,再用 shell function 執行。
所以它沒有給模型加 overhead。還是模型訓練過、已經熟悉的那些東西。
Connecting the Five Dimensions and Avoiding Over-engineering
拉遠一點,把五個維度連起來:offload、reduce、retrieve、isolate、cache。它們不是獨立的。
可以看到 offload 和 retrieve 讓 reduction 更有效,穩定的 retrieve 讓 isolation 安全,但 isolation 也會拖慢 context、降低 reduction 頻率。
然而更多 isolation 和 reduction 也會影響 cache 效率和輸出品質。所以說到底,我覺得 context engineering 是一門需要在多個可能衝突的目標之間找到平衡的科學與藝術。
最後想留一個想法,跟我剛講的幾乎相反:請避免 context over-engineering。
回頭看 Manus 上線這六七個月,我們見過最大的躍進,其實不是加更多花俏的 context 管理層或聰明的 retrieval hack。
它們都來自簡化,或拿掉不必要的花招,然後多信任模型一點。
每次我們簡化架構,系統就更快、更穩、更聰明,因為我們覺得 context engineering 的目標是讓模型的工作更簡單,而不是更難。
所以今天如果只帶走一件事,我覺得應該是 build less and understand more。
Q&A
Q&A - Shell Tools and Sandboxing
Q: LLM 怎麼調各種 shell 工具?它怎麼知道有哪些工具、怎麼呼叫?
也可以講一下你們 Manus 用的那種多層 sandbox 設定。
A: 首先 system prompt 裡有提示告訴 Manus,嘿,有很多預裝命令列工具在某個特定資料夾。
最常用的那些我們已經注進 system prompt,但非常 compact。我們不告訴 agent 工具怎麼用。
只列出來,並告訴 agent 可以安全用 --help,因為這些工具都是我們團隊開發的,格式一樣。
Q&A - Indexing vs. File System for Context Retrieval
Q: 你講了很多用檔案系統。對 indexing 怎麼看?如果 context 變得夠大,會不會當場起 vector store?
A: 這個領域沒有對錯,你也提到了,但 Manus 不用 index database,因為現在每個 sandbox session 都是新的,使用者想快,我們沒時間當場建 index。
所以我們更像 Claude Code,靠 grep 和 glob。但我覺得如果你要做更長期的 memory,或接企業知識庫,還是得靠外部 vector index,因為那只關乎你能訪問多少資訊。
但 Manus 是在 sandbox 裡操作,coding agent 是在 codebase 裡操作,取決於規模。
Q: 假設我是使用者,有 Manus 帳號,跨很多 session 互動。你們有 memory 這個概念嗎?
Claude 有 CLAUDE.md,會跨 Claude Code 的各個 session 持久化。你們長期記憶怎麼做?
A: 其實 Manus 有一個叫 knowledge 的概念,有點像 explicit memory。
比如你可以跟 Manus 說,記住每次我要東西就用 Excel 交,它不會自動塞進某個 memory。
會彈一個對話說,這是我從先前對話學到的,你要接受還是拒絕?這是顯式的,需要使用者確認。
我們也在找更自動的做法。比如 agent 裡一個挺有意思的點是,跟 chatbot 比,使用者更常糾正 agent。
Manus 常見錯誤之一是做資料視覺化時,如果你用中日韓,常常有字型問題,渲染出來會錯。
使用者就會說,你該用 CJK 字型。這類事情,不同使用者會給同樣的糾正,我們需要找到辦法利用這種集體回饋。
我們叫它 parameter free 的、帶 online learning 的 self-improving agent。
Q&A - Adapting to Evolving Models
Q: 你在 talk 結尾說拿掉東西收穫很大,很大一部分大概也是因為模型在變強。
模型能力在漲,你就可以慢慢拆掉 scaffolding。你怎麼看這個?
這是我面對過最大的挑戰之一:模型變好,我就能拿掉 scaffolding 的某些部分,你是建在水位一直上漲的地基上。
你們會不會每隔幾個月跟著新 release 回顧架構、模型變好就刪東西,怎麼處理這個問題?
A: 這問題超好,因為我們其實已經重構 Manus 五次了,三月上線,現在已經十月,五次。
我們覺得停不下來,因為模型不只是在變強,也在變。模型行為隨時間在變。
一個辦法是跟 model provider 緊密合作,我們內部還有另一套理論,關於怎麼評估、怎麼設計 agent 架構。
我以前在 Twitter 講過一點。基本上我們不在乎靜態 benchmark 的靜態表現。
而是固定 agent 架構,然後在模型之間切換。
如果你的架構從弱模型切到強模型能拿到很多增益,那這個架構某種程度上更 future-proof,因為明天的弱模型可能就跟今天的強模型一樣好。
所以我們覺得在弱模型和強模型之間切換,能給你一些明年會發生什麼的早期信號,讓你有時間準備架構。
Manus 大概每一兩個月做這類 review,也會用開源模型和可能的 proprietary 早期訪問,在下一個模型發佈之前就準備下一版。
Q&A - Data Storage Formats
存資料的格式有什麼 best practice 或考量?
markdown、純文字、log,有特別偏好嗎?
A: 我覺得重點不是純文字還是 markdown,我們永遠優先 line based 格式,因為模型可以用 grep,或按行範圍讀。
markdown 有時也會惹麻煩。模型被訓練得非常會用 markdown,有的模型我不想點名,你 markdown 用太多,它就會輸出太多 bullet。
所以我們其實更想用純文字。
Q&A - Prompting for Summarization
compaction 對 summarization 呢?
先講 summarization。這個我以前被問很多次,怎麼 prompt 才能產出好摘要?
你說 summarization 不可逆,prompt 不好就真的會丟資訊。
我自己最好的答案是把 prompt 調成 high recall,你們怎麼做?
A: 我們試過很多優化 summarization prompt,結果一個簡單做法很好用:不要用自由格式 prompt 讓 AI 生成一切。
而是定義一種 schema。就是一張表,很多欄位,讓 AI 去填。
比如這是我改過的檔、這是使用者的目標、這是我停在哪。
用這種更結構化的 schema,至少輸出比較穩,你可以 iterate,所以不要用自由格式摘要。
Q&A - Compaction of Search Results
那 compaction 呢?
我想確認我理解對了。compaction 時,假設是搜尋工具,你有原始搜尋輸出當 raw message,compaction 之後就只剩一個檔名之類的,對嗎?
A: 對。不只是 tool call,也套用在 tool 的結果上。
我們有趣地發現,Manus 裡幾乎每個 action 只要能 offload 到檔案系統或外部狀態,就都是可逆的。
大多數這類任務本來就有唯一識別符。檔案操作當然有 path。
瀏覽器操作有 URL,搜尋動作有 query。
所以它本來就在那。
Lance: 我想再打一次,因為我經常碰到這個問題。比如我是一個用搜尋的 agent,它返回一個很吃 token 的 tool call。
我不想把整段 tool message 還給 agent。
我做過某種 summarization 或 compaction 再把摘要送回去,但你怎麼處理?因為下一個決策可能還需要全部資訊,你又不想讓那一大塊 context 永遠住在 message history 裡。
怎麼做?可以把整段送回去再之後刪掉,Claude 現在就是這樣。
可以先摘要再送摘要。也可以先全送再 compaction,讓後面的 message history 裡不再有完整 context。
只留一個檔案連結。你具體怎麼想,如果你懂我在說什麼?
A: 其實取決於場景。比如複雜搜尋,我說的複雜搜尋不是一個 query。
比如多個 query,你想收集重要的、丟掉其餘的。
這種情況我覺得該用 sub-agent,我們內部叫 agent as tool。從模型角度看它還是一種 function,也許叫 advanced search。
是一個叫 event search 的 function,但它觸發的其實是另一個 sub-agent,那個 sub-agent 更像有固定輸出 schema 的 workflow 或 agentic workflow,返回給 agent 的就是那個結果。
更簡單的搜尋,比如搜 Google,我們就用完整細節格式 append 進 context,靠 compaction。
我們也總是指示模型把中間 insight 或關鍵發現寫進檔案,以防 compaction 來得比模型預期更早。
這件事做得好,compaction 其實丟不了太多資訊,因為有時那些舊 tool call 過一段時間就不相關了。
Q&A - Agent-to-Agent Communication & MapReduce
Q: 我喜歡 agent as tool 這個想法,我們也常用,非常有效,但這又帶出另一個有意思的點,你也提過一點,agent 之間的溝通。
你們怎麼處理?
Cognition 的 Walden Yen 有一篇很好的博客,說這是他們 Devin 的大問題。
agent 之間溝通,你怎麼想,既保證足夠資訊傳過去,又不像你說的把 sub-agent 的 prefill 塞爆?
A: 我們一個月前上線了一個叫 Wide Research 的功能,內部叫 agentic map reduce,靈感來自 MapReduce 的設計。
對 Manus 比較特別,因為 session 後面有完整虛擬機,所以主 agent 把資訊或 context 傳給 sub-agent 的一種方式是共享同一個 sandbox。
檔案系統在那,你只要傳不同的 path。
我覺得把資訊發給 sub-agent 沒那麼難。更複雜的是怎麼從不同 agent 拿到正確輸出。
我們的技巧是,每次主 agent 要 spawn 一個新 sub-agent,或十個,必須讓主 agent 定義輸出 schema。
從 sub-agent 角度看,有一個特殊工具叫 submit_result,我們用 constraint decoding 確保它交回主 agent 的東西符合主 agent 定義的 schema。
你可以想像這種 MapReduce 會生成一種 spreadsheet,而 spreadsheet 被 schema 約束。
Lance: 這好像是你們設計 Manus 時反覆出現的主題,summarization 和 agent 溝通都用 schema 和 structured output。
就像把 schema 當 agent 與 sub-agent、或工具與 agent 之間的契約,保證資訊以結構化、完整的方式傳過去,做 summarization 時也用 schema。
Q&A - Model Choice and Open Models
再挖幾個有意思的問題。模型方面,我覺得你們用 Anthropic,但有沒有用開源模型?
有沒有做 fine-tuning?你講了很多 KV cache,那塊也許會用開源模型。
怎麼看模型選擇?
A: 其實我們現在不用任何開源模型,我覺得不是品質問題,有趣的是成本問題。
我們常常以為開源能降成本,但如果你在 Manus 這個規模、在做真正的 agent,input 遠長於 output,KV cache 就超重要。
用開源方案,分散式 KV cache 很難做。
用那些 frontier 的 LLM provider,他們有更紮實的全球分散式 cache 基礎設施。
有時算一算,至少對 Manus,用這些旗艦模型有時甚至比開源更便宜。
而且我們現在不只用 Anthropic。
Anthropic 的模型是 agentic 任務的最佳選擇,但我們也在看 Gemini 和 OpenAI 新模型的進展。
我覺得現在這些 frontier lab 方向還沒收斂。比如做 coding,當然用 Claude。
想做更多多模態,用 Gemini。
OpenAI 的模型在複雜數學和推理上超強。所以對我們這種應用公司,一個優勢是不必只建在一個模型上。
你可以做 task 級路由,甚至 subtask 或 step 級路由,如果你能算、能把那種 KV cache validation 拉進來。
這是我們的優勢,我們內部做很多 evaluation,知道哪個 subtask 用哪個模型。
Lance: KV cache 這塊,你們在用 provider 的哪些具體功能做 cache 管理?
我知道比如 Anthropic 有 input caching。
Q&A - Tool Selection and Layered Action Space (Revisited)
Q: tool selection 是個好問題。你剛才說你們不用 tool description 的 indexing、不按語義相似度當場拉工具。
那怎麼處理?工具太多的閾值是什麼?
tool choice 是經典問題。怎麼想?
A: 首先取決於模型。不同模型對工具的容量不一樣,但經驗法則是盡量不要超過大概 30 個工具。
這只是我腦子裡的隨機數字,但其實如果你在做我們說的 general AI agent 像 Manus,你會希望那些 native function 非常 atomic。
所以真的需要放進 action space 的 atomic function 沒那麼多。
Manus 現在大概只有 10 或 20 個 atomic function,其餘都在 sandbox。
我們不必動態去拉。
Lance: 再解釋一下,假設有 10 個工具 agent 能直接調,但如你所說 agent 也可以選擇寫腳本再執行腳本。
這就把 action space 擴得很大,又不用為每種可能的腳本各做一個獨立工具,那當然瘋了。
所以那個很 generic 的「寫腳本再跑」工具能幹很多。
A: 為什麼我們很有信心叫 Manus 是 general agent?
因為它跑在電腦上,電腦是圖靈完備的。電腦是人類最好的發明。
理論上,agent 能做一個初級實習生用電腦能做的任何事。
有了 shell tool 和 text editor,我們覺得已經完備,很多東西可以直接 offload 到 sandbox。
Lance: 你提到 code agent。我的理解是模型總會產出一段腳本,然後在 code sandbox 裡跑,所以每個 tool call 實際上都是生成並執行腳本。
聽起來你們是混合的,有時 Manus 直接調工具,有時選擇在 sandbox 裡做,對嗎?
A: 這點超重要,因為我們其實試過讓 Manus 完全用 CodeAct,問題是用 code 就用不上 constraint decoding,事情會出錯。
CodeAct 有一些特殊場景,我前面 slides 提過,比如處理大量資料。
你不必把所有東西都 port 進 tool result。
而是放進 Python 的 runtime memory,只把結果拿回給模型。
所以我們覺得應該用混合方式。
Q&A - Planning and To-Do Lists
Q: 講講 planning。我知道 Manus 有 to-do 工具,或任務開始時會生成 to-do list。
A: 一開始 Manus 用的是 to-do.md 範式。
我不想用 stupid 這個詞,但它確實浪費很多 turn。
大概三四月的時候,你去看某些 Manus 任務的 log,可能三分之一的 action 都在更新 to-do list。
浪費很多 token。
所以現在我們用更結構化的 planning。比如你用 Manus,系統底部有一個 planner。
內部也是一種 tool,我們用 agent as tool 範式實現,有一個獨立 agent 在管計畫。
所以最新版 Manus 已經不再用 to-do.md 了。
todo.md 還能用,也能產出不錯的結果,但如果你想省 token,可以換別的辦法。
Q&A - Multi-Agent Design and Roles
你可能有一個 planning agent,自己的 context window,做出計畫,產出某種 plan object,也許是檔案,也許直接調 sub-agent。
你怎麼看這個,一般建議用多少種不同的 sub-agent?
A: 這也取決於你的設計,但在 Manus,Manus 其實不是那種典型的 multi-agent 系統。
我們見過很多按角色切分的 agent。
比如 designer agent、programming agent、manager agent,我們不做,因為我們覺得之所以這樣,是因為人類公司這樣運作,那是人類 context 的限制。
所以 Manus 是 multi-agent 系統,但我們不按角色切。
我們只有很少幾個 agent。比如一個很大的 general executor agent、一個 planner agent、一個 knowledge management agent,也許還有 data API registration agent。
我們對加更多 sub-agent 非常謹慎,因為前面講過,溝通很難。
更多種類的 sub-agent 我們用前面說的 agent as tools 來實現。
Lance: 我經常看到這個,不知道算不算錯,就是把 agent 擬人化,這是我的 designer agent,我覺得拿人類組織架構套到 sub-agent 上有點硬套。
就是 planner 和 knowledge manager。knowledge manager 會做什麼,它的任務是什麼?
A: 我們提過 Manus 有 knowledge 系統。
knowledge agent 做的是回顧使用者和 agent 的對話,判斷什麼該存進長期記憶。
Q&A - Safety and Guardrailing in Sandboxed Environments
guardrailing 呢?有人問安全和護欄。
A: 如果你有一個連網的 sandbox,一切都危險。所以我們在護欄上花了很多力氣,至少不讓資訊跑出 sandbox。
比如被 prompt injected,我們對出站流量有檢查。
確保 token 這類東西不會出 sandbox。
如果使用者想把東西印出 sandbox,我們有那種移除機制,確保沒有資訊出去。
另一件事是 Manus 裡面有瀏覽器,瀏覽器很複雜。
比如你登入某些網站,可以選擇讓 Manus 持久化登入狀態,這其實很棘手,因為網頁內容本身也可能惡意,可能在做 prompt injection。
我覺得這某種程度上超出應用公司的範圍。所以我們跟那些 computer use 的模型提供商合作很緊。
比如 Anthropic 和 Google。他們在加很多護欄。
所以現在 Manus 裡,每次做敏感操作,無論在瀏覽器還是 sandbox,Manus 都會要求手動確認,你必須接受,否則得自己接管做完。
我覺得我們很難設計一個非常完美的方案,但是漸進的。
現在我們讓使用者更頻繁地接管,但如果模型裡的護欄變好,我們就能少做一點。
Q&A - Evaluation Strategies
evals 呢?線上討論很多,你可能也看到,Claude Code 講過對 code 少做正式 eval,因為 code eval 差不多飽和了,很多內部 dogfooding。
你們怎麼看 evals?有用嗎?哪些真正有用?
你們的做法?
A: 對,Manus 剛上線時我們用公開學術 benchmark 比如 Gaia,但面向公眾之後發現超級 misaligned。
Gaia 高分的模型,使用者不喜歡。
所以現在我們有三種 evaluation。
第一也最重要,Manus 每個完成的 session 都會請使用者打一到五星回饋。
這是 gold standard。我們永遠關心平均使用者評分。這是第一。
第二,我們還在用內部自動化測試,結果可驗證。
比如我們自己建了有明確答案的資料集。也還用很多公開學術 benchmark,但又做了一些更偏 execution 的資料集,因為外面大多數 benchmark 更偏唯讀任務。
我們設計了一些執行任務或交易型任務,因為我們有 sandbox,可以頻繁重置測試環境。
這些是自動化部分。最重要的第三,我們有很多實習生,網站生成或資料視覺化這類東西,你必須用大量真人實習生去評,因為很難設計一個知道輸出好不好看的 reward model。
這關乎品味。
Q&A - RL with Verifiable Rewards vs. Tool Calling Agents
我想問這個正在出現的趨勢:帶可驗證獎勵的強化學習,對上直接做 tool calling agent。
比如 Claude Code 非常強,他們的好處是自己建了 harness,可以在 harness 上做 RL,對 harness 裡那些工具會變得非常非常好。
你們做 RL 嗎,怎麼看?
當然那樣你就得用開源模型。
我最近也玩了不少。你怎麼看,直接用模型提供商現成的 tool calling,對上在自己環境、自己的 harness 裡做 RL?
A: 我做 pre-training、post-training、RL 很多年了,但得說現在如果你資源夠,可以試。
但就像前面說的,MCP 是個大改變,因為要支援 MCP,你就不是固定 action space。
不是固定 action space,就很難設計好的 reward,也產生不了大量 rollout,feedback 會不平衡。
所以如果你想做一個支援 MCP 的模型,你幾乎是自己在做 foundation model。
我覺得社群裡模型公司都在做同一件事。
他們在替你做。所以我現在不覺得該花那麼多時間做 RL,但像前面說的,我們在探索新辦法,也許叫 personalization 或某種 online learning,但是 parameter free 的方式。
比如集體回饋。
Lance: 順著這條,比如 Anthropic 在 Claude Code 的某組工具上做了帶可驗證獎勵的強化學習。
你們有沒有試過把 harness 裡的工具名 mock 成類似的,去解鎖同樣的能力,懂我意思嗎?
比如他們顯然用了 glob、grep,還有一組操作檔案系統的工具。
你能不能靠在 harness 裡放完全一樣的工具、一樣的名字、一樣的描述,有效複現同樣功能?你怎麼看這種「解鎖」?
A: 這裡我知道清楚的答案,但對我們來說其實盡量不用同樣的名字,因為如果你設計自己的 function,需求可能不同,參數、輸入也可能不同。
你不想搞混模型,如果模型在大量含內部工具的 post-training 資料上訓過,你不想讓模型搞混。