
Il y a quelques mois Manus a publié un blog sur le Context Engineering.
https://manus.im/blog/Context-Engineering-for-AI-Agents-Lessons-from-Building-Manus
Tu n'as pas besoin que tout le context vive dans l'historique de messages de ton agent, donc il faut du context offloading.
Langchain experience
Offload context to a file system
Une des idées les plus populaires ici, c'est juste d'utiliser un file system.
Prends la sortie d'un tool message : dump-la dans le file system, renvoie à l'agent seulement le minimum pour qu'il puisse référencer le context complet s'il en a besoin, mais ce payload entier, par exemple un résultat de recherche web très gourmand en tokens, n'est pas spammé dans ta context window pour l'éternité.
Offloader le context, c'est prendre un bout d'info token-heavy, genre un tool message, ne pas tout renvoyer dans la liste de messages, et le dump dans un file system où on ne le récupère qu'au besoin.
Reduce context
Résumer ou compresser pour réduire le context. Résumer les sorties de tool call est une façon intuitive de le faire. Cette idée de pruner les vieux tool calls avec leurs outputs ou tool messages, Claude l'a maintenant un peu intégrée dans leur SDK.
Cognition (une appli agent) parle aussi de summarization / pruning aux handoffs agent-to-agent.
Retrieve Context
Claude Code Force n'utilise que le file system et des outils de recherche simples, surtout glob et grep. Il y a différentes façons de récupérer du context à la demande pour ton agent.
L'indexation et la recherche sémantique, le file system et les outils de recherche de fichiers simples, les deux peuvent être très efficaces.
Context isolation
L'isolation de context est majeure, surtout découper le context entre multi-agents.
Chaque sub-agent a sa propre context window, et les sub-agents permettent la séparation des préoccupations.
Caching Context
langchain open deep research
https://github.com/langchain-ai/open_deep_research
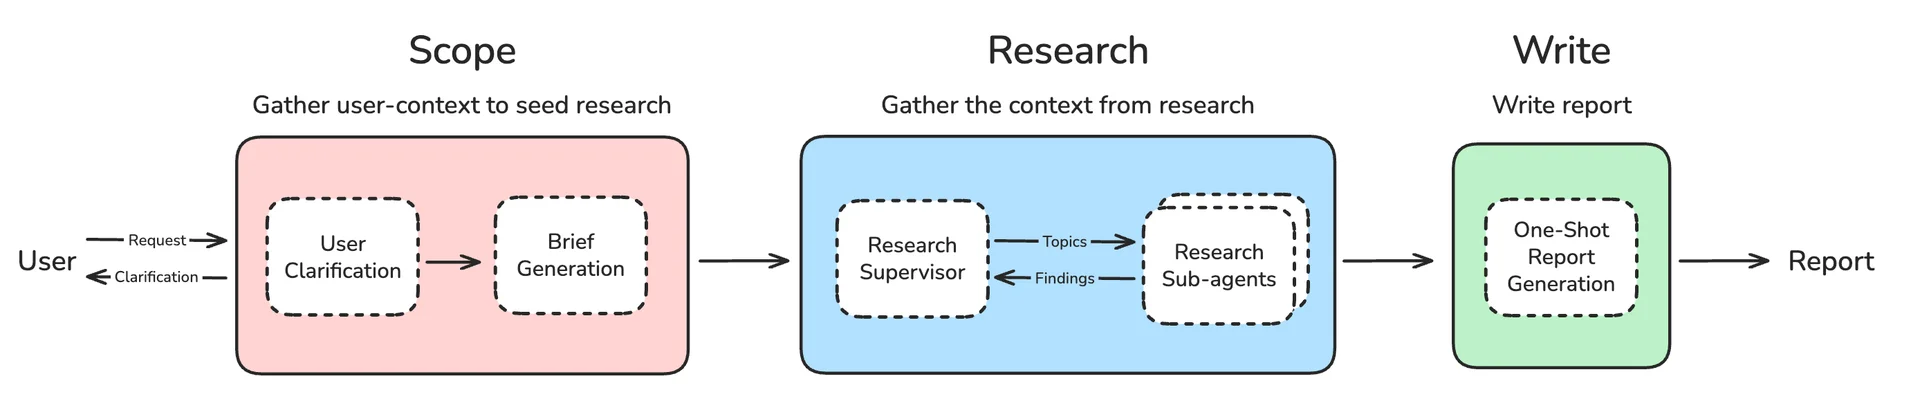
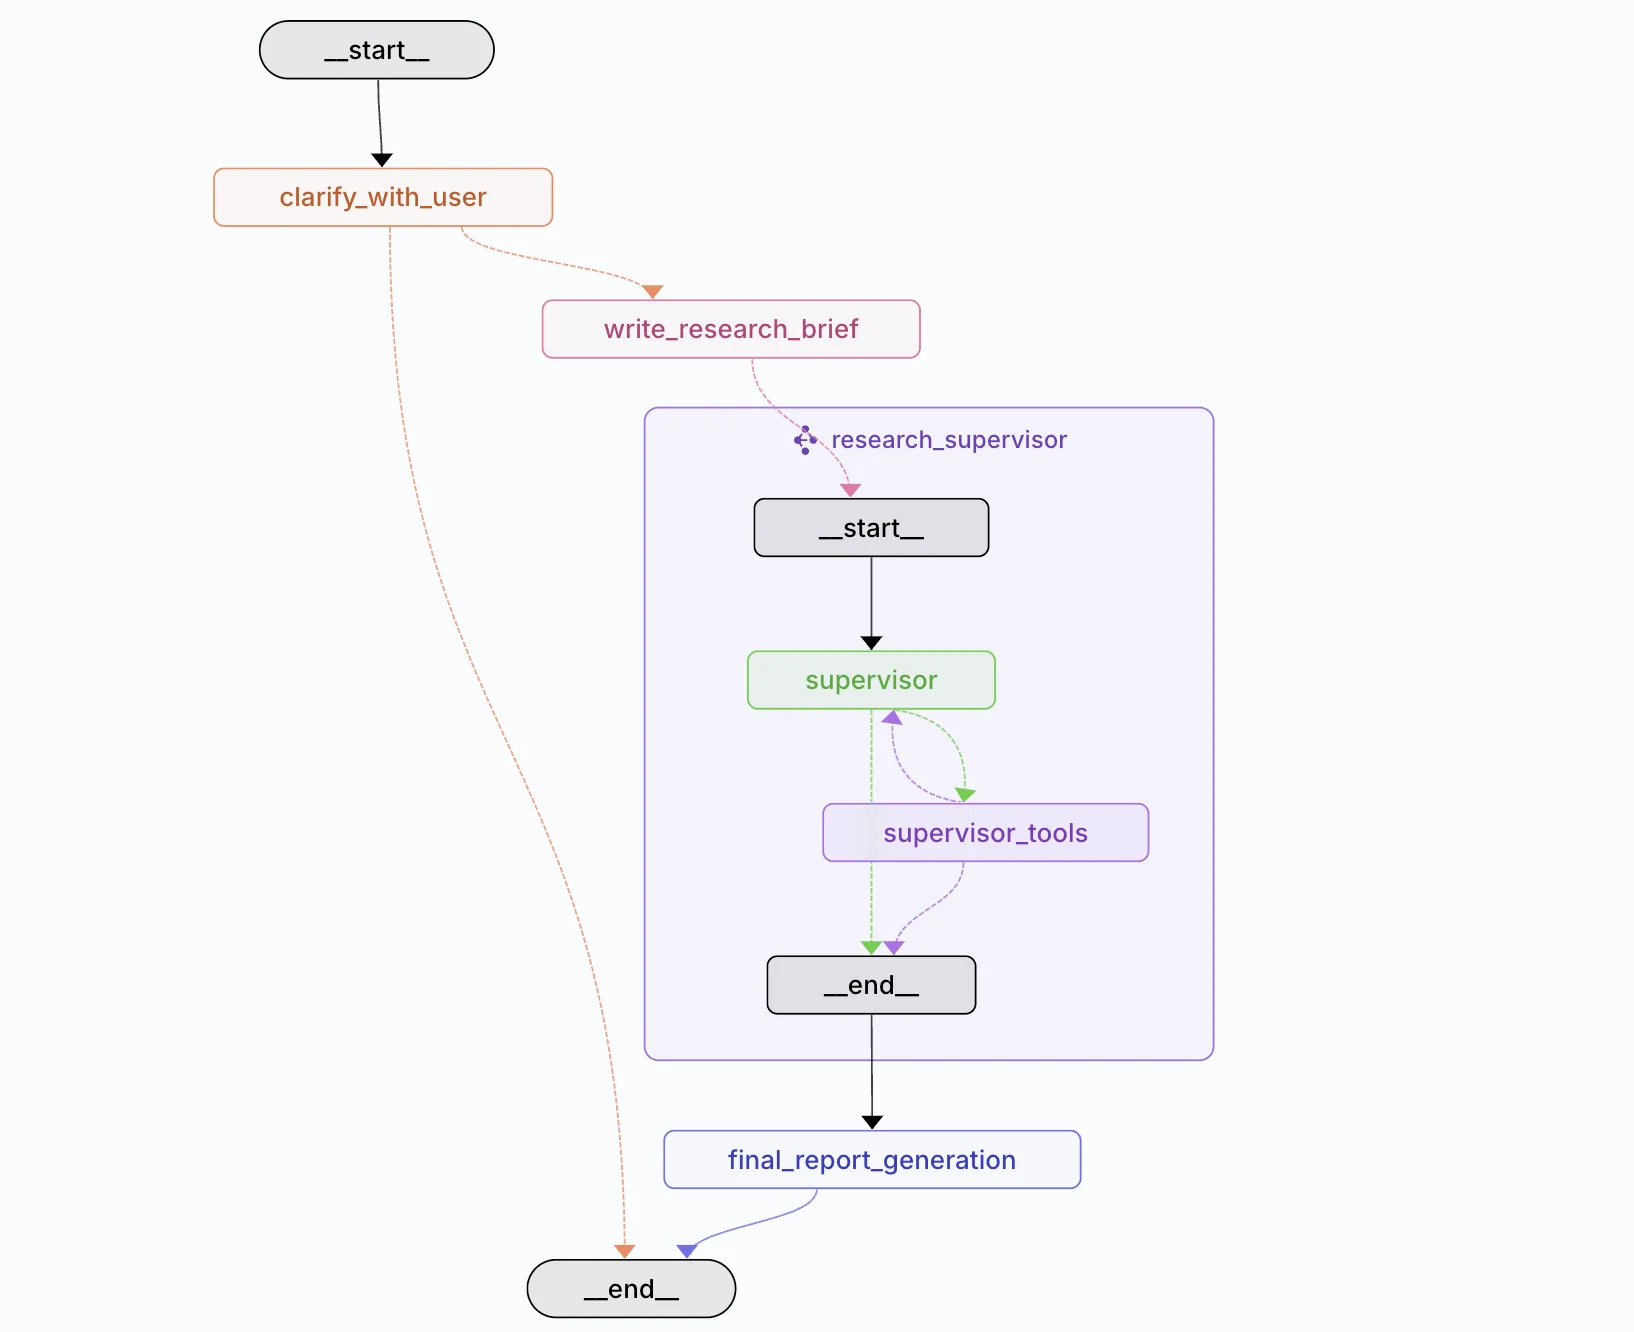
Trois phases : scoping de la recherche, la phase de recherche elle-même en architecture multi-agent, puis une phase d'écriture one-shot. On offload : on crée un brief pour cadrer le plan de recherche.
On l'offload pour ne pas le garder seulement dans la context window, parce que cette window va se faire poivrer d'autres trucs.
On l'offload pour qu'il soit sauvé à part. Chez nous c'est depuis le LangGraph state, ça pourrait aussi être le file system, même idée.
Tu crées un plan de recherche, tu l'offload, il reste accessible. Tu fais un tas de boulot, tu le rapatries à la demande, tu le mets vers la fin de la liste de messages pour que l'agent l'ait sous la main, par exemple pour l'écriture.
On se sert de l'offloading pour orienter recherche et écriture. On se sert de la réduction pour résumer les observations des surf tool calls token-heavy, ça se fait dans la recherche elle-même.
Et on isole le context entre sub-agents dans la recherche. C'est un peu un résumé de ces idées à travers plein de projets.
Manus experience
Au lieu de construire trop tôt des modèles spécialisés, les startups devraient s'appuyer le plus longtemps possible sur des modèles généraux et le context engineering.
Context Reduction: Compaction vs. Summarization
Pour la compaction, chez Manus chaque tool call et tool result a deux formats : full et compact.
La version compacte enlève ce qu'on peut reconstruire depuis le file system ou un état externe. Exemple : un outil qui écrit un fichier, deux champs, path et content.
Une fois l'outil revenu, tu sais que le fichier existe déjà dans l'environnement. Donc en compact on peut dropper le content super long et garder le path.
Si l'agent est assez malin, quand il doit relire le fichier, il le reprend via le path. Rien n'est vraiment perdu. C'est externalisé.
Cette réversibilité est cruciale : les agents enchaînent des prédictions sur les actions et observations passées, tu ne sais jamais quelle action passée va devenir ultra importante 10 steps plus tard.
Tu ne peux pas le prédire. Donc c'est une réduction réversible par compaction.
Évidemment la compaction ne t'emmène que jusqu'à un point. Le context continue de grandir, tu tapes le plafond, et là on combine compaction et summarization plus classique, mais très prudemment.
Par exemple, avant de résumer, on peut offloader des parties clés dans des fichiers. Parfois plus agressif : dump de tout le context pré-summary en texte ou log dans le file system, pour toujours le récupérer.
Comme Lance vient de le dire, certains utilisent juste glob et grep. glob marche aussi sur les logs. Si le modèle est assez malin, il sait même récupérer ce context pré-summarized.
La différence : la compaction est réversible, la summarization non. Les deux réduisent la longueur, mais elles se comportent très différemment.
Pour les faire coexister, il faut tracker des seuils de longueur. En haut, la limite dure du modèle, disons 1 million de tokens, assez courant aujourd'hui.
Mais en réalité la plupart des modèles se dégradent bien plus tôt, autour de 200k, et tu vois ce qu'on appelle le context rot : répétitions, inférences plus lentes, qualité en baisse.
Avec beaucoup d'évals, c'est important d'identifier ce seuil pré-rot, typiquement 128K à 200K, et de s'en servir comme trigger de réduction.
Quand la taille s'en approche, tu déclenches la réduction, en commençant par la compaction, pas la summarization.
Compacter ne veut pas dire compresser toute l'histoire. On peut compacter les 50 % d'appels les plus vieux et garder les plus récents en détail, pour que le modèle ait encore des few-shot frais sur comment utiliser les outils.
Sinon, au pire, le modèle imite le format compact avec des champs manquants, et c'est complètement faux.
Après compaction, on vérifie combien de context libre on a vraiment gagné. Parfois, comme sur le graphe, après plusieurs rounds le gain est minuscule : même compact, ça occupe encore du context.
Là on passe à la summarization, en gardant en tête qu'on résume toujours la version full des données, pas la compacte.
On garde aussi les derniers tool calls et tool results en détail, pas en résumé, pour que le modèle sache où il s'est arrêté et continue plus fluide.
Sinon après summarization le modèle change parfois de style, de ton, et on a vu que garder quelques exemples de tool call / tool result aide vraiment.
Context Isolation: Communicating vs. Sharing Memory
Le blog de Cognition prévient contre les setups multi-agents : synchro d'info entre plusieurs agents, cauchemar.
La coordination multi-processus ou multi-thread est un défi classique des débuts de la programmation, on peut emprunter un peu de sagesse.
Dans la communauté Go, une citation célèbre de ce gopher : « Do not communicate by sharing memory, instead share memory by communicating. »
https://chatgpt.com/share/68f4f8c3-baac-8004-9cf7-421375260909
Ce n'est pas directement sur les agents, et c'est parfois même faux pour les agents, mais ça met en lumière deux patterns : by communicating ou by sharing memory.
Si on traduit memory par context, le parallèle est clair. « By communicating » est le plus simple : le setup sub-agent classique.
L'agent principal écrit un prompt, l'envoie au sub-agent, et tout le context du sub-agent n'est que cette instruction.
Si la tâche a une instruction courte et claire et que seul l'output final compte, chercher un snippet dans un codebase, utilise le pattern communication et reste simple.
Le principal se fiche de comment le sub-agent a trouvé le code. Il veut le résultat.
C'est ce que fait Claude Code, typiquement avec son task tool pour déléguer une tâche séparée et claire.
Pour des cas plus complexes, « by sharing memory » veut dire que le sub-agent voit tout le context précédent. Tout l'historique d'outils, mais avec son propre system prompt et son action space.
Imagine du deep research : le rapport final dépend de beaucoup de recherches et notes intermédiaires. Là, envisage share memory, ou chez nous « by sharing context », parce que même si tu sauves tout en fichiers et que tu fais tout relire au sub-agent, tu gaspilless latence et context.
En tokens, tu en consommes peut-être encore plus. Pour les scénarios qui exigent l'historique complet, share memory.
Mais sharing context coûte cher : chaque sub-agent a un plus gros input à prefill, plus d'input tokens, et comme le system prompt et l'action space diffèrent, tu ne réutilises pas le KV cache, tu paies le prix fort.
Context Offloading: Layered Action Space
Quand les gens disent offload, ils veulent souvent dire déplacer une partie du context de travail vers des fichiers externes.
Mais à mesure que le système grandit, surtout si un jour tu intègres MCP, tu vois que les outils eux-mêmes prennent beaucoup de context, et trop d'outils dans le context mène à la confusion.
On appelle ça context confusion : le modèle peut appeler les mauvais, ou même des inexistants.
Il faut aussi offloader les outils. Approche courante : RAG dynamique sur les descriptions d'outils, charger à la demande selon la tâche ou l'état.
Ça pose deux problèmes. D'abord, les définitions d'outils sont en tête de context, le KV reset à chaque fois.
Surtout, les anciens appels vers des outils retirés restent dans le context, ce qui peut duper le modèle à appeler des outils invalides ou de mauvais paramètres.
Pour ça, Manus expérimente un layered action space. Trois niveaux d'abstraction : un, function calling ; deux, sandbox utilities ; trois, packages and API.
On creuse les trois. Level one, function calling, le classique. Schema safe grâce au constraint decoding, mais on connaît les défauts.
Casser le cache, trop d'outils, confusion.
Manus utilise un nombre fixe de fonctions atomiques : lire/écrire des fichiers, shell, chercher des fichiers sur internet, opérations browser.
Frontières très claires, composables en workflows plus complexes.
Le reste part à la couche suivante, sandbox utilities. Chaque session Manus tourne dans une VM sandbox complète, Linux custom, donc Manus peut lancer au shell des utilitaires préinstallés qu'on a développés.
Convertisseurs de format, reconnaissance vocale, et un MCP CLI très spécial, c'est comme ça qu'on appelle MCP.
On n'injecte pas les outils MCP dans l'espace function calling. Tout se fait dans la sandbox via CLI.
Les utilities sont bien : tu ajoutes des capacités sans toucher à l'espace d'appel du modèle, ce sont juste des commandes préinstallées.
Si tu connais Linux, tu sais toujours trouver les nouvelles commandes, et tu peux même faire --help.
Autre plus : les gros outputs peuvent aller en fichiers ou revenir paginés.
grep, cat, less, more pour traiter à la volée. Trade-off : super pour les gros outputs, moins bon pour l'aller-retour low latency avec le front.
Parce que tu dois toujours visualiser les interactions de l'agent pour l'utilisateur.
Dernière couche : packages and APIs. Manus écrit des scripts Python pour appeler des API pré-autorisées ou des packages custom.
Librairie 3D pour modéliser, API financière pour les marchés. On a acheté ces API pour le user, on paie pour eux.
Inclus dans l'abo. Beaucoup de clés préinstallées, Manus y accède.
Parfait pour les tâches qui demandent beaucoup de calcul en mémoire sans pousser toutes les données dans le context du modèle.
Analyser un an de cours d'une action : tu ne nourris pas le modèle avec tous les chiffres. Le script calcule, tu remets seulement le résumé.
Code et APIs sont super composables, tu chaînes beaucoup de choses en une step.
Noms de villes, city ID, météo, tout dans un script Python.
Il y a aussi un papier d'un ami, Code Act. Beaucoup de gens en ont parlé. Même idée : le code est composable, beaucoup de choses en une step.
Mais ce n'est pas schema safe. Le constrained decoding sur du code est très très dur.
Il faut le bon scénario. Chez nous, tout ce qui peut se traiter dans un compiler ou un interpréteur, on le fait en code.
Sinon sandbox utilities ou function calls.
Le plus : du point de vue du modèle, les trois niveaux passent encore par des function calls standard, interface simple, cache-friendly, orthogonale.
Les sandbox utilities, tu y accèdes encore via le shell tool / shell function.
Les APIs tierces : file function pour écrire/lire, shell function pour exécuter.
Pas d'overhead ajouté au modèle. Ce sont encore des choses sur lesquelles les modèles sont entraînés.
Connecting the Five Dimensions and Avoiding Over-engineering
On recule et on relie les cinq dimensions : offload, reduce, retrieve, isolate, cache. Elles ne sont pas indépendantes.
Offload et retrieve rendent la réduction plus efficace, un retrieve stable rend l'isolation sûre, mais l'isolation ralentit aussi le context et réduit la fréquence de réduction.
Plus d'isolation et de réduction affecte aussi l'efficacité du cache et la qualité de sortie. Au bout du compte, le context engineering est une science dans un art, un équilibre entre objectifs potentiellement conflictuels.
Une dernière pensée, un peu l'inverse de tout ce que je viens de dire : évitez le context over-engineering.
En regardant les six ou sept mois depuis le lancement de Manus, le plus grand saut n'est pas venu de couches fancy de gestion de context ou de hacks de retrieval.
Tout est venu de simplifier, d'enlever des trucs inutiles, et de faire un peu plus confiance au modèle.
Chaque fois qu'on simplifie l'archi, le système est plus rapide, plus stable, plus malin. Le but du context engineering est de rendre le job du modèle plus simple, pas plus dur.
Si tu retiens une chose d'aujourd'hui : build less and understand more.
Q&A
Q&A - Shell Tools and Sandboxing
Q : Comment le LLM appelle-t-il les outils shell ? Comment sait-il lesquels existent et comment les invoquer ?
Tu peux expliquer un peu le sandboxing multi-niveaux de Manus ?
A : D'abord un hint dans le system prompt : il y a plein d'utilitaires CLI préinstallés dans un dossier précis.
Les plus fréquents sont déjà injectés dans le system prompt, très compact. On ne dit pas à l'agent comment s'en servir.
On les liste, et on dit que --help est sûr, tous développés par notre équipe, même format.
Q&A - Indexing vs. File System for Context Retrieval
Q : Tu as beaucoup parlé du file system. Ton avis sur l'indexation ? Tu spins des vector stores à la volée si le context devient assez gros ?
A : Pas de bien ou de mal dans cet espace. Chez Manus on n'utilise pas de bases d'index : chaque sandbox de session est neuf, l'utilisateur veut interagir vite, on n'a pas le temps de builder l'index on the fly.
Plus comme Claude Code : grep et glob. Si tu veux de la mémoire plus long terme ou une knowledge base entreprise, il faudra un vector index externe : c'est juste la quantité d'info accessible.
Manus opère dans une sandbox, un coding agent dans un codebase, ça dépend de l'échelle.
Q : Je suis user, compte Manus, j'interagis sur beaucoup de sessions. Vous avez une notion de memory ?
Claude a des CLAUDE.md qui persistent entre sessions de Claude Code. Vous, la mémoire long terme ?
A : Chez Manus on a le concept knowledge, une sorte de mémoire explicite.
Tu peux dire : souviens-toi, chaque fois que je demande un truc, livre-le en Excel. Ce n'est pas inséré auto dans une mémoire.
Un dialogue pop : voici ce que j'ai appris de notre conversation, accept ou reject ? Explicite, confirmation user.
On cherche aussi des voies plus auto. Chez les agents, vs chatbots, les users corrigent plus souvent.
Erreur fréquente de Manus : visualisation de données, chinois / japonais / coréen, problèmes de polices, erreurs de rendu.
Le user dit d'utiliser une police CJK. Des users différents font la même correction. Il faut trouver comment tirer parti de ce feedback collectif.
On appelle ça un agent self-improving avec online learning, mais parameter free.
Q&A - Adapting to Evolving Models
Q : Vers la fin tu as dit que vous avez beaucoup gagné en enlevant des choses, probablement aussi parce que les modèles s'améliorent.
Les capacités montent, tu peux retirer du scaffolding. Comment tu vois ça ?
C'est un de mes plus gros défis : le modèle s'améliore, je peux enlever des bouts de scaffolding, tu construis sur une fondation dont l'eau monte.
Vous revisitez l'archi tous les X mois avec les nouvelles releases et vous deletez à mesure ? Comment vous abordez ça ?
A : Super question. On a déjà refactoré Manus cinq fois. Lancé en mars, on est en octobre, cinq fois.
On ne peut pas s'arrêter : les modèles ne font pas que s'améliorer, ils changent. Leurs comportements changent.
Une voie : travailler près des providers. On a aussi une théorie interne pour évaluer / designer l'archi agent.
J'en ai un peu parlé sur Twitter. On ne se soucie pas de la perf statique d'un benchmark statique.
On fixe l'archi agent et on switch de modèles.
Si ton archi gagne beaucoup en passant d'un modèle faible à un fort, elle est plus future-proof : le faible de demain peut valoir le fort d'aujourd'hui.
Switcher faible / fort te donne des signaux précoces de l'année prochaine et du temps pour préparer.
Chez Manus on revoit ça tous les un ou deux mois, recherche interne avec des modèles open source et parfois un early access proprietary, pour préparer la release suivante avant même le prochain modèle.
Q&A - Data Storage Formats
Best practices pour le format de stockage ?
Markdown, plain text, log, une préférence ?
A : Ce n'est pas tant plain text vs markdown. On priorise toujours les formats line based, pour que les modèles puissent grep ou lire une plage de lignes.
Le markdown peut aussi poser des soucis. Les modèles sont très bien entraînés dessus, et certains modèles — je ne veux pas citer le nom — sortent trop de puces si tu markdown trop.
Donc on veut plus de plain text.
Q&A - Prompting for Summarization
Compaction vs summarization.
La summarization. On me pose souvent la question : comment prompter de bons résumés ?
C'est irréversible, un mauvais prompt et tu perds de l'info.
Ma meilleure réponse : tuner le prompt pour un high recall. Vous ?
A : On a beaucoup optimisé le prompt de summarization. Une approche simple marche très bien : pas de prompt free form pour tout générer.
Définir une sorte de schema. Un formulaire, plein de champs, l'IA les remplit.
Fichiers que j'ai modifiés, but du user, où je me suis arrêté.
Avec un schema plus structuré, la sortie est plus stable, tu peux itérer. Pas de summarizations free form.
Q&A - Compaction of Search Results
Et la compaction ?
Je veux être sûr d'avoir compris. Outil de search, sortie brute = raw message, compaction = un nom de fichier, c'est ça ?
A : Oui. Pas seulement le tool call, aussi le résultat.
On a trouvé, c'est intéressant, que presque chaque action Manus est réversible si tu peux l'offloader vers le file system ou un état externe.
Pour la plupart de ces tâches tu as déjà un identifiant unique. Fichiers : le path.
Browser : l'URL. Search : la query.
C'est déjà là, naturellement.
Lance : Je reviens dessus, j'ai souvent ce problème. Agent qui search, tool call token-heavy.
Je ne veux pas renvoyer tout le tool message à l'agent.
J'ai fait de la summarization / compaction et renvoyé le résumé, mais comment tu fais ? Tu veux que toute l'info reste accessible pour la décision suivante, sans que le gros bloc vive dans l'historique.
Comment ? Tout renvoyer puis retirer plus tard, c'est ce que Claude fait maintenant.
Summarizer d'abord. Tout envoyer puis compacter pour n'avoir plus qu'un lien fichier dans l'historique. Comment tu vois ça précisément ?
A : Ça dépend du scénario. Recherche complexe, pas une seule query.
Plusieurs queries, tu veux ramasser l'important et dropper le reste.
Là, sub-agents, en interne agent as tool. Pour le modèle c'est encore une function, advanced search peut-être.
Function appelée event search, mais ça déclenche un autre sub-agent, plutôt un workflow / agentic workflow à schema de sortie fixe, et c'est ça qui revient à l'agent.
Recherche plus simple, Google, on met le format full detail dans le context et on s'appuie sur la compaction.
On instruit aussi toujours le modèle d'écrire insights intermédiaires et key findings dans des fichiers, au cas où la compaction arrive plus tôt que prévu.
Si tu fais ça bien, tu ne perds pas beaucoup à la compaction : parfois les vieux tool calls ne sont plus pertinents.
Q&A - Agent-to-Agent Communication & MapReduce
Q : J'aime agent as tool, on le fait beaucoup, c'est très efficace, mais ça pose la comm agent-agent. Tu y as un peu touché.
Comment vous traitez ça ?
Walden Yen de Cognition a un super blog : gros problème chez Devin.
Comm entre agents, assez d'info transférée sans overloader le prefill du sub-agent ?
A : On a lancé Wide Research il y a un mois. En interne, agentic map reduce, inspiré de MapReduce.
Spécial à Manus : une VM complète derrière la session. Un moyen de passer l'info / le context du main au sub-agent : partager la même sandbox.
Le file system est là, tu ne passes que des paths différents.
Envoyer n'est pas si dur. Le plus complexe : obtenir le bon output de différents agents.
Le trick : chaque fois que le main veut spawn un sub-agent, ou dix, il doit définir le schema de sortie.
Côté sub-agent, un outil spécial submit_result, constraint decoding pour que ce qui revient au main respecte le schema défini par le main.
Tu peux imaginer que ce MapReduce génère une sorte de spreadsheet contrainte par le schema.
Lance : Thème récurrent dans le design Manus : schemas et structured outputs pour la summarization et pour cette comm agent-agent.
Les schemas comme contrats entre agent et sub-agent, ou outil et agent, pour passer assez d'info de façon structurée et complète. Pour résumer aussi, un schema.
Q&A - Model Choice and Open Models
D'autres questions. Les modèles : vous êtes sur Anthropic, vous travaillez avec des open models ?
Fine-tuning ? Beaucoup de KV cache, donc peut-être de l'open.
Comment vous voyez le choix de modèle ?
A : Pour l'instant on n'utilise aucun modèle open source. Pas la qualité, c'est le coût, c'est intéressant.
On croit souvent que l'open baisse le coût, mais à l'échelle Manus, un vrai agent dont l'input est bien plus long que l'output, le KV cache est super important.
Un KV cache distribué est très dur à implémenter en solutions open source.
Les providers frontier ont une infra plus solide pour du cache distribué global.
Si tu fais les maths, au moins chez Manus, les flagships peuvent même être moins chers que l'open.
Et on n'est plus seulement sur Anthropic.
Le modèle Anthropic est le meilleur pour l'agentic, mais on voit aussi les progrès de Gemini et du nouveau modèle OpenAI.
Les labs frontier ne convergent pas encore. Coding : Claude.
Plus multimodal : Gemini.
OpenAI est super sur maths complexes et reasoning. Pour une boîte d'appli comme nous, un avantage : ne pas n'être que sur un modèle.
Routing au niveau tâche, voire subtask ou step, si tu peux calculer / brancher ce genre de validation KV cache.
C'est un avantage, on fait beaucoup d'évals internes pour savoir quel modèle pour quel subtask.
Lance : KV cache, quelles features des providers pour le cache management ? Anthropic a l'input caching par exemple.
Q&A - Tool Selection and Layered Action Space (Revisited)
Q : Tool selection. Tu disiez : pas d'index des descriptions, pas de fetch on the fly par similarité sémantique.
Comment vous gérez ? Seuil du trop d'outils ?
Le tool choice est un classique. Comment tu vois ça ?
A : Ça dépend du modèle. Capacités différentes. Rule of thumb : pas plus d'environ 30 outils.
Nombre un peu au pif, mais pour un general AI agent comme Manus, tu veux des native functions super atomiques.
Il n'y a pas tant de fonctions atomiques à mettre dans l'action space.
Manus n'en a que 10 ou 20, le reste est dans la sandbox.
Pas besoin de pull dynamique.
Lance : Disons 10 outils appelables directement, et l'agent peut aussi écrire un script et l'exécuter.
Ça explose l'action space sans un outil indépendant par script possible, ce qui serait insensé.
Un outil très général write+run fait beaucoup.
A : Pourquoi on est super confiants pour appeler Manus un general agent ?
Parce qu'il tourne sur un ordinateur, et les ordis sont Turing-complets. Meilleure invention humaine.
Théoriquement un agent peut faire tout ce qu'un junior intern peut faire avec un ordi.
Shell tool + text editor, on pense que c'est déjà complet, tu peux offloader beaucoup vers la sandbox.
Lance : Les code agents. Ma compréhension : le modèle produit toujours un script, exécuté dans une code sandbox, chaque tool call est un script généré et run.
Vous faites un hybride : parfois Manus appelle des outils directement, parfois il choisit la sandbox, c'est ça ?
A : Super important. On a essayé de tout faire en CodeAct pour Manus. Le problème : en code tu ne peux pas tirer parti du constraint decoding, ça peut casser.
CodeAct a des cas spéciaux, comme dans les slides : traiter beaucoup de data.
Tu n'as pas à tout porter dans le tool result.
Tu le mets dans la mémoire runtime de Python, tu ne ramènes que le résultat au modèle.
Il faut le faire en hybride.
Q&A - Planning and To-Do Lists
Q : Le planning. Manus a un outil to-do, ou génère une to-do list au début des tâches.
A : Au début Manus utilisait le paradigme to-do.md.
Je ne veux pas dire stupid, mais ça gaspille beaucoup de tours.
Vers mars-avril, dans les logs de certaines tâches, un tiers des actions c'était mettre à jour la to-do.
Beaucoup de tokens.
Maintenant un planning plus structuralisé. Si tu uses Manus, il y a un planner en bas du système.
En interne c'est une sorte d'outil, agent as tool, un agent séparé gère le plan.
La dernière version de Manus n'utilise plus to-do.md.
todo.md marche encore, de bons résultats, mais si tu veux sauver des tokens, tu peux faire autrement.
Q&A - Multi-Agent Design and Roles
Un planning agent avec sa window, un plan, un plan object, fichier ou appels directs de sub-agents.
Comment tu vois ça, et combien de sub-agents différents tu recommandes ?
A : Ça dépend du design. Chez Manus, ce n'est pas le multi-agent typique.
On a vu beaucoup d'agents découpés par rôle.
Designer, programming, manager. On ne fait pas ça : c'est comme ça qu'une boîte humaine marche, à cause de la limite du context humain.
Manus est multi-agent, mais on ne découpe pas par rôle.
Très peu d'agents. Un gros general executor, un planner, un knowledge management, peut-être un data API registration.
Très prudents avant d'ajouter des sub-agents : la comm est dure, on l'a dit.
On implémente plus de types en agent as tools.
Lance : Je vois souvent ça, je ne sais pas si c'est une erreur, anthropomorphiser : my designer agent. Analogie forcée avec un org chart humain.
Planner et knowledge manager. Le knowledge manager fait quoi ?
A : On a un système knowledge dans Manus.
Le knowledge agent revoit la conversation user-agent et décide ce qui doit aller en mémoire long terme.
Q&A - Safety and Guardrailing in Sandboxed Environments
Guardrailing, quelqu'un a demandé sécurité.
A : Un sandbox branché à internet, tout est dangereux. Beaucoup d'effort sur le guard railing : au moins, l'info ne sort pas du sandbox.
Prompt injected : checks sur le trafic sortant.
Rien de type token ne sort du sandbox.
Si le user veut imprimer hors sandbox, on a des mécanismes de retrait pour que rien ne sorte.
Autre chose : un browser dans Manus, très compliqué.
Tu te logues sur tes sites, tu peux laisser Manus persister le login. Tricky : le contenu de la page peut être malveillant, prompt injection.
Un peu hors scope pour une boîte d'appli. On bosse très près des providers computer-use.
Anthropic et Google. Ils ajoutent beaucoup de guardrails.
Dans Manus, chaque opération sensible, browser ou sandbox, demande une confirmation manuelle : tu acceptes, sinon tu prends la main pour finir toi-même.
Dur de designer une solution très propre. Approche progressive.
Pour l'instant le user takeover plus souvent ; si le guardrail du modèle s'améliore, on en fera moins.
Q&A - Evaluation Strategies
Les evals. Beaucoup discuté en ligne. Claude Code : moins d'évals formelles au moins pour le code, saturées, beaucoup de dogfooding interne.
Votre avis ? Utiles ? Lesquelles vraiment ?
Votre approche ?
A : Au lancement on utilisait des benches académiques publics type Gaia. Après le public, super misaligned.
Les modèles qui scorent haut sur Gaia, les users ne les aiment pas.
Trois types d'évals maintenant.
Le plus important : chaque session terminée, on demande un feedback 1 à 5 étoiles.
Gold standard. On se soucie toujours de la note moyenne. Numéro un.
Deux : tests auto internes à résultats vérifiables.
Dataset maison avec réponses claires. On utilise encore des benches académiques, mais on a aussi créé des datasets plus axés execution : la plupart des benches sont read-only.
Tâches d'exécution ou transactionnelles : on a le sandbox, on reset souvent l'env de test.
Ça c'est l'auto. Trois, le plus important : beaucoup d'internes. Il faut de vrais humains pour eval site generation ou data viz, très dur de designer un reward model qui sait si c'est visuellement bien.
C'est une affaire de goût.
Q&A - RL with Verifiable Rewards vs. Tool Calling Agents
Tendance : RL avec récompenses vérifiables vs juste des agents tool calling.
Claude Code, extrêmement bon, ils ont le harness et peuvent RL dessus, ça devient vraiment très bon avec les outils du harness.
Vous faites du RL ? Comment vous voyez ça ?
Dans ce cas tu utiliserais des open models.
J'ai beaucoup joué avec ça. Tool calling out of the box des providers vs RL toi-même dans ton env, ton harness ?
A : Pre-training, post-training, RL depuis des années. Si tu as assez de ressources, tu peux essayer.
Mais MCP change beaucoup : supporter MCP, ce n'est plus un action space fixe.
Sans space fixe, très dur de designer un bon reward, tu ne génères pas beaucoup de rollouts, le feedback est unbalanced.
Construire un modèle qui supporte MCP, c'est littéralement construire un foundation model toi-même.
Les boîtes modèle de la communauté font la même chose.
Ils le font pour toi. Je ne pense pas qu'on doive passer tant de temps sur le RL maintenant. Comme je disais, on explore des voies, personalization ou online learning parameter free.
Feedback collectif par exemple.
Lance : Dans cette lignée : Anthropic a fait du RL à récompenses vérifiées sur un set d'outils via Claude Code.
Vous avez mocké votre harness avec des noms d'outils similaires pour unlock la même capa ?
Ils ont utilisé glob, grep, d'autres outils filesystem.
Reproduire la même fonctionnalité avec les mêmes outils, mêmes noms, mêmes descriptions dans le harness ? Comment tu vois cet unlock ?
A : Je connais la réponse claire ici, mais chez nous on essaie de ne pas utiliser les mêmes noms : si tu designs ta propre function, tes requirements peuvent différer, les params aussi.
Tu ne veux pas confondre le modèle s'il a été post-entraîné sur beaucoup de data avec des outils internes.