
何か月か前、Manus が Context Engineering のブログを出した。
https://manus.im/blog/Context-Engineering-for-AI-Agents-Lessons-from-Building-Manus
agent の messages history にすべての context を置く必要はない。だから context offloading が要る。
Langchain experience
Offload context to a file system
いちばん人気のアイデアのひとつは、ただ file system を使うこと。
tool message の出力を例にすると、ファイルシステムに dump して、agent には必要最小限だけ返す。必要なら全文を参照できるけど、token を食うウェブ検索結果みたいなフル payload を、context window に永久に詰め込まない。
offloading は、token の重い tool message みたいな情報を messages list に全部戻さず、ファイルシステムに捨てて、必要なときだけ取る。
Reduce context
要約や圧縮で context を減らす。tool call の出力を要約するのは直感的なやり方。古い tool call と tool output / tool message を剪定するこの考え方は、Claude が今 SDK に組み込みつつある。
Cognition(agent アプリ)も、agent-to-agent の handoff で summarization / pruning する話をしている。
Retrieve Context
Claude Code Force はファイルシステムと単純な検索、主に glob と grep だけ使う。agent がオンデマンドで context を取る方法はいろいろある。
Indexing や意味検索、ファイルシステムと単純なファイル検索、どちらもかなり効く。
Context isolation
Context isolation は大きい。特に multi-agent に context を分けること。
各 sub-agent は自分の context window を持ち、関心の分離ができる。
Caching Context
langchain open deep research
https://github.com/langchain-ai/open_deep_research
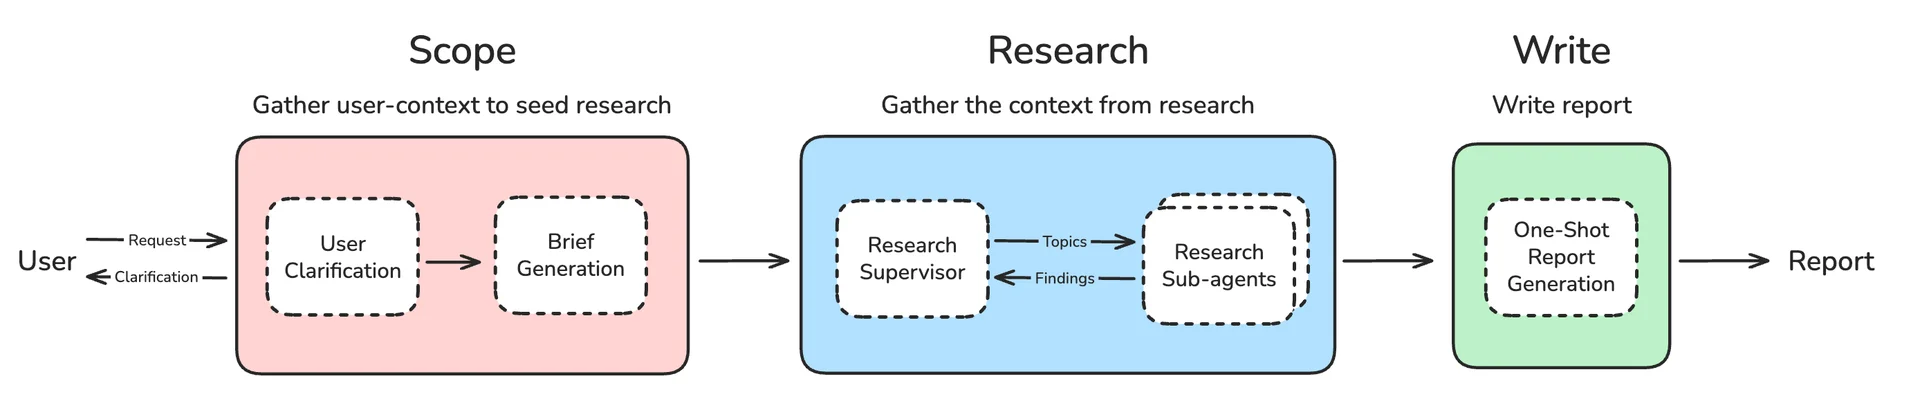
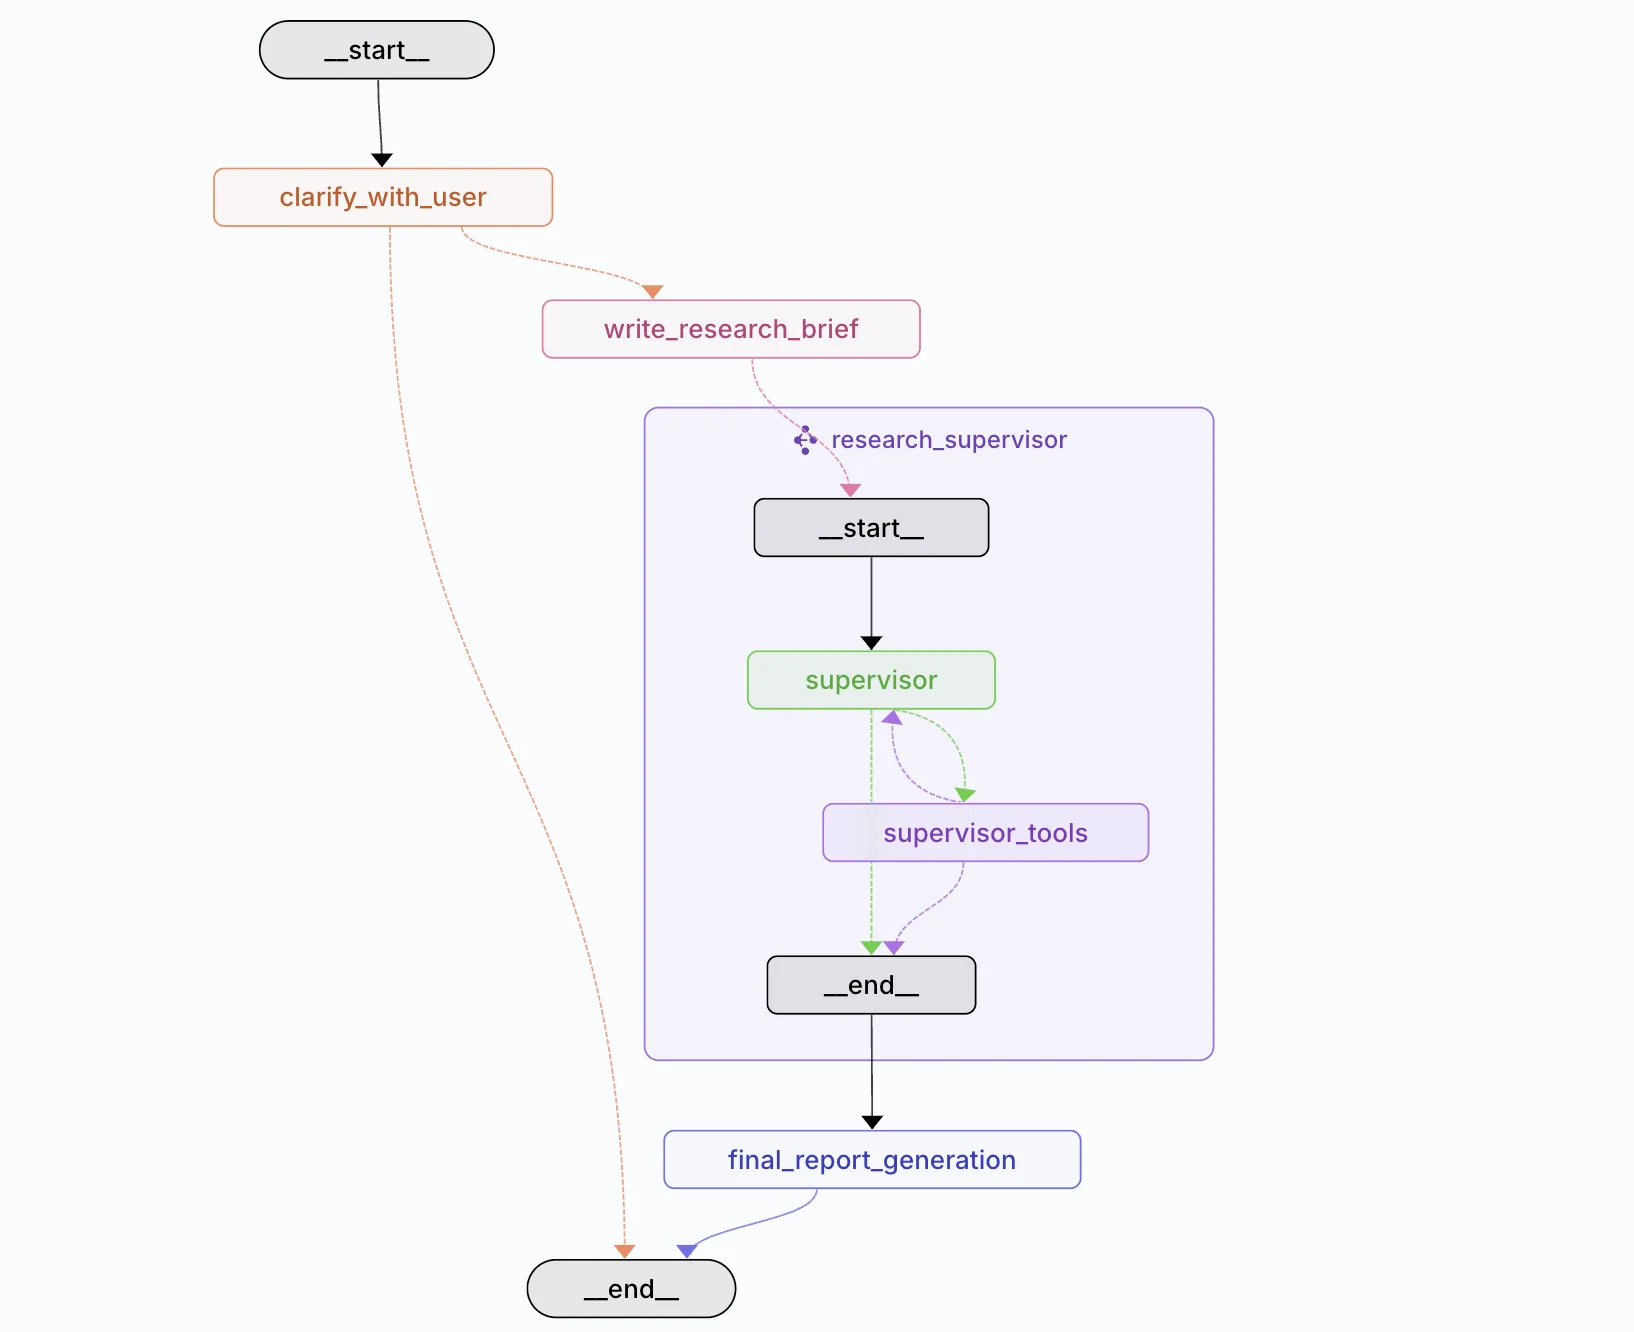
三相ある。研究の scoping、multi-agent アーキテクチャでの研究そのもの、最後の one-shot 執筆。offloading を使う。研究計画を枠取る brief を作る。
context window にだけ置かない。その window は他のものがどんどん入ってくるから。
独立して保存する。うちは LangGraph state から取るけど、ファイルシステムでも同じ。
研究計画を作って offload する。いつでも取れる。仕事をして、必要なら末尾に戻して、たとえば執筆フェーズで agent がすぐ使えるようにする。
offloading で研究と執筆を誘導する。token の重い surf tool call の observation は reduction で要約する。研究の中でやる。
研究の中の sub-agent 同士では context isolation。いろんなプロジェクトのアイデアをまとめた感じ。
Manus experience
特化モデルを早すぎる段階で作るより、スタートアップはできるだけ長く general model と context engineering に寄せるべき。
Context Reduction: Compaction vs. Summarization
compaction では、Manus の tool call と tool result は full と compact の二形式がある。
compact はファイルシステムや外部状態から再構成できる情報を落とす。たとえばファイル書き込みツールなら path と content。
ツールが返ったあと、ファイルは環境にあると保証できる。だから compact では超長い content を捨てて path だけ残せる。
agent が十分賢ければ、また読むときは path で取る。情報は失われない。外に出しただけ。
この可逆性が大事だと思う。agent は過去の action と observation で連鎖予測するし、10 ステップ後に突然重要になる過去の行動は予測できない。
予測できない。だから compaction は可逆な reduction。
もちろん compaction だけでは足りない。context は伸びて天井に当たる。そこで伝統的な summarization と組み合わせる。ただし慎重に。
要約の前に、重要な部分をファイルに offload することがある。もっと攻めて、要約前の context 全体をテキストや log としてファイルシステムに dump して、あとでいつでも戻せるようにする。
Lance が言ったように、glob と grep だけ使う人もいる。glob は log にも効く。モデルが賢ければ、要約された、要約前の context の取り出し方も知っている。
違いは compaction は可逆、summarization は不可逆。どちらも長さは減るが、挙動が違う。
共存させるには context 長の閾値を追う。一番上はモデルのハード上限、今なら 100 万 token とか。
でも実際はもっと早く劣化する。だいたい 200k くらいで context rot、繰り返し、推論が遅く、品質が落ちる。
評価をたくさんやって、rot 前の閾値を見つけるのが大事。だいたい 128K から 200K。それを reduction のトリガーにする。
近づいたら reduction。ただし summarization からではなく compaction から。
compaction は履歴全体を潰す意味ではない。古い tool call の 50% を compact して、新しいものはフルで残す。モデルにツールの使い方の新鮮な few-shot が残るように。
さもないと最悪、モデルが compact 形式を真似して欠落フィールドを出す。それは完全に間違い。
compaction のあと、どれだけ空きが出たか見る。グラフみたいに何ラウンドやっても、compact でもまだ context を食って、利得が小さいことがある。
そこで summarization。ただし要約は必ず full 版を使う。compact ではない。
最後の数個の tool call / tool result はフルのまま。要約しない。どこで止まったかモデルが分かって、スムーズに続く。
さもないと要約後にスタイルやトーンが変わる。tool call / tool result の例を少し残すのが効く。
Context Isolation: Communicating vs. Sharing Memory
Cognition のブログは multi-agent を警告している。複数 agent の同期が悪夢になるから。
マルチプロセスやマルチスレッドの協調 は初期のプログラミングの古典的難題で、知恵を借りられると思う。
Go コミュニティの有名な gopher の言葉。「Do not communicate by sharing memory, instead share memory by communicating.」
https://chatgpt.com/share/68f4f8c3-baac-8004-9cf7-421375260909
agent の話そのものではないし、agent には間違っていることもある。でも二つのパターンをはっきりさせる。communicating か sharing memory。
memory を context に置き換えると平行関係が見える。「By communicating」は分かりやすい。古典的な sub-agent。
メインが prompt を書き、sub-agent に送る。sub-agent の context はその指示だけ。
短く明確な指示で最終出力だけが大事なら、コードベースから snippet を探すとか、communication で単純に。
メインは探し方を気にしない。結果だけ。
Claude Code がやっていること。task tool で分離した明確なタスクを sub-agent に渡す。
複雑な場面の「by sharing memory」は、sub-agent がこれまでの context 全部を見られること。tool 履歴全部。ただし system prompt と action space は自分のもの。
deep research なら最終レポートは途中の検索とノートに依存する。そのときは share memory、うちの言い方では「by sharing context」。ノートを全部ファイルに書いて sub-agent に再読ませると、遅延と context を無駄にする。
token を数えると、むしろ増えるかも。フル履歴が要るなら share memory。
ただし sharing context は高い。各 sub-agent の prefill 入力が大きく、input token が増え、system prompt と action space が違うので KV cache を再利用できず、フル価格を払う。
Context Offloading: Layered Action Space
offload と言うと、作業中の context を外部ファイルに移すことが多い。
システムが大きくなると、特にいつか MCP を入れると、ツール自体が context を食う。多すぎると混乱する。
context confusion。モデルが違うツールや存在しないツールを呼ぶ。
ツールも offload しないといけない。今よくあるのは tool description の dynamic RAG。タスクや状態に応じてオンデマンドで載せる。
でも問題が二つ。まず tool definition が context の先頭にあるので、毎回 KV が reset する。
いちばん大事なのは、消したツールへの過去の呼び出しがまだ context に残って、無効なツールやパラメータを呼ぶようモデルを騙すこと。
そこで Manus は layered action space を試している。三つの抽象から選ぶ。一、function calling。二、sandbox utilities。三、packages and API。
三層を深く見る。level one の function calling は古典。constraint decoding で schema safe。欠点も知っている。
cache を壊す、ツールが多すぎると混乱する。
だから Manus は固定数の atomic function。ファイル読み書き、shell、ネット検索、ブラウザ操作など。
境界がはっきりしていて、組み合わせて複雑な workflow になる。
残りは次の層、sandbox utilities。Manus の各 session はフル VM sandbox。自前のカスタム Linux。shell で Manus 用に作ったプリインストールユーティリティを走らせられる。
フォーマット変換、音声認識、それから特別な MCP CLI。MCP の呼び方。
MCP ツールを function calling space に注入しない。sandbox の CLI ですべてやる。
utilities はいい。モデルの calling space を触らず能力を足せる。パソコンに入っているコマンドと同じ。
Linux を知っていれば新しいコマンドの探し方は分かる。--help を走らせて使い方も分かる。
大きい出力はファイルに書くか、ページで返す。
grep、cat、less、more でその場で処理できる。trade-off は大出力に強い一方、フロントとの低遅延の往復には向かない。
agent のやり取りを可視化してユーザーに見せないといけないから。
最後の層が packages and APIs。Manus が Python を書いて、事前認可した API やカスタムパッケージを呼ぶ。
3D デザインライブラリでモデリングしたり、金融 API で相場を取ったり。API はユーザーの代わりにこちらが買って払っている。
サブスクに含まれる。API key がたくさん入っていて、Manus はそれでアクセスする。
メモリ内で大量計算が要るけど、データを全部モデル context に入れなくていいタスクに向く。
株の一年分の価格を分析するなら、数字を全部モデルに渡さない。スクリプトに計算させて、要約だけ戻す。
code と API は composable なので、一歩でたくさん繋げる。
都市名、city ID、天気を一つの Python で、とか。
友達の論文 Code Act も同じアイデア。code は composable で、一歩でたくさんできる。
でも schema safe ではない。code に constrained decoding はとても難しい。
シナリオを選ぶべき。compiler や interpreter で扱えるものは code。
それ以外は sandbox utilities か function calls。
いいのは、モデルから見ると三層とも標準 function call を通るので、インタフェースは単純、cache に優しく、関数同士は直交。
sandbox utilities も shell tool / shell function で触る。
サードパーティ API も file function で書いて読んで、shell function で実行。
モデルに overhead を足さない。訓練済みで慣れているものだけ。
Connecting the Five Dimensions and Avoiding Over-engineering
引いて五つの次元をつなぐ。offload、reduce、retrieve、isolate、cache。独立していない。
offload と retrieve が効率的な reduction を可能にし、安定した retrieve が isolation を安全にする。一方 isolation は context を遅くし、reduction の頻度を下げる。
isolation と reduction を増やすと cache 効率と出力品質にも効く。結局 context engineering は、衝突しうる複数の目的のバランスが要る科学であり芸術。
最後に、今言ったことと逆の話。context over-engineering を避けて。
Manus 公開から六、七か月、いちばんの飛躍は派手な context 管理や retrieval hack ではなかった。
単純化、不要なトリックを外す、モデルをもう少し信頼することから来た。
アーキテクチャを単純にするたびに、速く、安定し、賢くなった。context engineering のゴールはモデルの仕事を簡単にすることであって、難しくすることではない。
今日一つ持って帰るなら build less and understand more。
Q&A
Q&A - Shell Tools and Sandboxing
Q: LLM はどうやって各種 shell ツールを呼ぶ?どれがあって、どう呼べるか、どう知る?
Manus の多層 sandbox も少し説明して。
A: まず system prompt にヒントがある。特定フォルダにプリインストールの CLI がたくさんあるよ、と。
よく使うものは system prompt に入れてある。超 compact。使い方は教えない。
一覧だけ。--help は安全に使っていい、チーム製でフォーマットが同じだから。
Q&A - Indexing vs. File System for Context Retrieval
Q: ファイルシステムの話が多かった。indexing はどう?context が大きくなったらその場で vector store を立てる?
A: この領域に正解不正解はない。でも Manus は index DB を使わない。今は毎回新しい sandbox で、ユーザーは速いやり取りが欲しい。その場で index を作る時間がない。
Claude Code 寄りで grep と glob。長期メモリや企業ナレッジを入れるなら外部 vector index が要る。アクセスできる情報量の問題。
Manus は sandbox、coding agent は codebase。スケール次第。
Q: ユーザーとして Manus アカウントで何 session もやり取りする。memory の概念はある?
Claude は CLAUDE.md が session をまたいで残る。長期記憶はどう?
A: Manus には knowledge という概念がある。explicit memory に近い。
たとえば「毎回 Excel で出して」と伝える。自動では memory に入らない。
ダイアログが出て、前回の会話からこう学びました、accept / reject?明示的で、ユーザー確認が要る。
もっと自動にもしようとしている。agent の面白いところは、chatbot よりユーザーが訂正することが多いこと。
よくあるミスはデータ可視化で、中日韓だとフォント問題で描画が壊れる。
ユーザーが CJK フォントを使えと言う。違うユーザーが同じ訂正をする。集団フィードバックの使い方を見つけたい。
parameter free な online learning の self-improving agent、と呼んでいる。
Q&A - Adapting to Evolving Models
Q: talk の終わりで、外して得たものが大きいと言った。モデルが良くなっているからでもあるだろう。
能力が上がると scaffolding を外せる。どう考える?
僕の最大の課題の一つで、モデルが良くなると scaffolding の一部を消せる。水位が上がる土台の上に建てている。
数か月ごとに新リリースでアーキテクチャを見直して、モデルが良くなったら消す?どうやってる?
A: すごくいい質問。Manus はもう五回リファクタした。3 月ローンチ、今は 10 月。五回。
止められない。モデルは良くなるだけじゃなく、変わる。振る舞いが時間で変わる。
一つのやり方は provider と近く働くこと。内部には評価と設計の別の理論もある。
Twitter で少し話した。静的ベンチの静的スコアは気にしない。
アーキテクチャを固定してモデルを切り替える。
弱いモデルから強いモデルに切り替えて大きく得するなら、そのアーキテクチャは future-proof 寄り。明日の弱いモデルは今日の強いモデルくらいかもしれない。
弱強の切り替えは来年の早期シグナルになって、準備の時間をくれる。
Manus では一、二か月ごとにこの種のレビューをする。OSS モデルや proprietary の早期アクセスで、次のモデル公開前に次リリースを準備する。
Q&A - Data Storage Formats
データの保存フォーマットの best practice は?
markdown、プレーンテキスト、log、好みは?
A: プレーンか markdown かより、常に line based を優先する。grep や行範囲読みができるから。
markdown はたまに面倒。モデルは markdown が上手で、あるモデルは名前を出したくないけど、markdown が多いと bullet を出しすぎる。
だからプレーンテキストをもっと使いたい。
Q&A - Prompting for Summarization
compaction 対 summarization。
summarization のほう。よく聞かれる。いい要約の prompt はどうする?
不可逆だから、prompt を間違えると情報が消える。
僕の最善は prompt を high recall にチューニングすること。どうしてる?
A: summarization prompt の最適化はたくさん試した。うまくいった単純な方法は、自由形式で全部生成させないこと。
schema を定義する。フォームで、フィールドがたくさんあって、AI に埋めてもらう。
変更したファイル、ユーザーのゴール、どこで止まったか。
構造化 schema なら出力が安定して iterate できる。自由形式の要約はしない。
Q&A - Compaction of Search Results
compaction は?
理解の確認。検索ツールなら生の検索出力が raw message で、compaction 後はファイル名みたいな感じ?
A: そう。tool call だけでなく結果にも適用する。
面白いのは、ファイルシステムや外部状態に offload できれば、Manus のほぼすべての action が可逆だということ。
たいてい一意の ID がある。ファイルなら path。
ブラウザなら URL、検索なら query。
もともとそこにある。
Lance: もう一度。よく困る。検索する agent が token の重い tool call を返す。
全部を agent に返したくない。
要約や compaction して要約を返すこともある。次の判断には全部欲しいが、巨大ブロックを message history に置きたくない。
どうする?全部返して後で消す、Claude は今そう。
先に要約して送る。全部送ってあとで compaction して、history にはファイルへのリンクだけ。具体的にどう思う?
A: シナリオ次第。複雑な検索、一つの query ではない場合。
複数 query で重要なものを集めて残りを捨てたい。
そのときは sub-agent、内部では agent as tool。モデルからは function、advanced search みたいな。
event search という function だが、実際は別の sub-agent。固定出力 schema の workflow / agentic workflow で、それが agent に返る。
単純な Google 検索ならフル詳細を context に append して compaction に任せる。
compaction が予想より早く来てもいいように、中間 insight や key findings をファイルに書けと常に指示する。
うまくやれば compaction で失うものは多くない。古い tool call は時間が経つと関係なくなることもある。
Q&A - Agent-to-Agent Communication & MapReduce
Q: agent as tool は好きでよく使うし効く。でも agent 間通信の話になる。少し触れていた。
どう対処する?
Cognition の Walden Yen のブログで、Devin の大きな問題だと言っていた。
agent 間で十分な情報を渡しつつ、sub-agent の prefill をoverload しないには?
A: 一か月前に Wide Research を出した。内部では agentic map reduce。MapReduce の設計から。
Manus は session の裏にフル VM があるので、メインから sub-agent へは同じ sandbox を共有して渡す。
ファイルシステムがある。違う path を渡すだけ。
送ること自体は難しくない。難しいのは違う agent から正しい出力を得ること。
トリックは、メインが sub-agent を 1 個でも 10 個でも spawn するとき、メインに出力 schema を定義させること。
sub-agent 側には submit_result という特別なツール。constraint decoding で、メインが定義した schema で戻す。
MapReduce が spreadsheet みたいなものを生成し、schema で制約されるイメージ。
Lance: Manus の設計でよく出るテーマだね。summarization も agent 通信も schema と structured output。
schema を agent / sub-agent、ツールと agent の契約にして、構造化されて完全な情報を渡す。要約でも schema。
Q&A - Model Choice and Open Models
他の質問。モデルは Anthropic だと思うけど、オープンモデルは?
fine-tuning は?KV cache の話が多かったから、オープンを使う?
モデル選択はどう考える?
A: 今はオープンソースモデルは使っていない。品質ではなく、面白いことにコスト。
オープンは安いと思いがちだが、Manus の規模で本物の agent を作ると input が output よりずっと長い。KV cache が超重要。
分散 KV cache はオープン解では実装が難しい。
frontier の LLM provider のほうが、グローバルな分散 cache の基盤が厚い。
計算すると、少なくとも Manus ではフラッグシップのほうがオープンより安いことさえある。
今は Anthropic だけでもない。
agentic タスクは Anthropic が最善だが、Gemini と OpenAI の新モデルの進捗も見ている。
frontier lab の方向はまだ収束していない。coding なら Claude。
マルチモーダルなら Gemini。
OpenAI は複雑な数学と推論が強い。アプリ会社の利点は、一つのモデルの上にだけ建てなくていいこと。
task レベルのルーティング、KV cache の validation を入れられれば subtask や step レベルも。
利点で、内部でどの subtask にどのモデルかをたくさん評価している。
Lance: KV cache で、provider のどの機能を cache 管理に使っている?Anthropic の input caching とか。
Q&A - Tool Selection and Layered Action Space (Revisited)
Q: tool selection。tool description の indexing や意味類似でオンデマンド取得はしないと言っていた。
どう扱う?多すぎの閾値は?
tool choice は古典。どう考える?
A: まずモデル次第。ツール容量は違う。目安は 30 個を超えないこと。
頭の中のランダムな数字。でも Manus みたいな general AI agent なら native function は超 atomic にしたい。
action space に入れる atomic function は実は多くない。
Manus は今 10 か 20 の atomic function。残りは sandbox。
動的に pull しなくていい。
Lance: もう少し。直接呼べるツールが 10 個あって、agent はスクリプトを書いて実行することも選べる。
可能なスクリプトごとに独立ツールを持たずに action space が巨大に広がる。もちろんそれは狂っている。
スクリプトを書いて走らせる汎用ツールがかなりやる。
A: なぜ Manus を general agent と呼ぶ自信があるか。
コンピュータの上で動くから。コンピュータはチューリング完全。人類最高の発明。
理論上、ジュニアインターンがコンピュータでできることは agent にもできる。
shell と text editor があれば完備だと思う。多くを sandbox に offload できる。
Lance: code agent の話。モデルはいつもスクリプトを出し、code sandbox で走る、tool call は実質スクリプト生成と実行、という理解。
ハイブリッドで、直接ツールを呼ぶことも、sandbox でやることも選ぶ、であってる?
A: すごく大事。Manus を全部 CodeAct にしようとした。問題は code だと constraint decoding が使えず、壊れる。
CodeAct にはスライドで言った特殊用途がある。大量データの処理など。
tool result に全部 port しなくていい。
Python の runtime memory に置いて、結果だけモデルに戻す。
ハイブリッドでやるべき。
Q&A - Planning and To-Do Lists
Q: planning。Manus の to-do ツール、タスク開始時の to-do list。
A: 最初は to-do.md パラダイム。
stupid とは言いたくないけど、turn をかなり無駄にする。
3 月 4 月のログを見ると、action の三分の一が to-do 更新だったりする。
token を食う。
今はもっと構造化した planning。Manus を使うとシステムの下に planner がある。
内部では tool で、agent as tool。計画を管理する別 agent。
最新の Manus はもう to-do.md を使っていない。
todo.md はまだ動くし結果も出る。token を節約したければ別のやり方がある。
Q&A - Multi-Agent Design and Roles
planning agent が自分の context で計画を作り、plan object を出す。ファイルか、直接 sub-agent。
どう考える?sub-agent は何種類が目安?
A: 設計次第。Manus は典型的な multi-agent ではない。
役割で割る agent をよく見る。
designer、programming、manager。やらない。人間の会社がそうだからで、人間の context の限界だから。
Manus は multi-agent だが役割では割らない。
ごく少数。大きな general executor、planner、knowledge management、data API registration くらいかも。
sub-agent を増やすのはとても慎重。通信が難しいから、前に言った通り。
それ以外の種類は agent as tools で実装する。
Lance: よく見る。間違いかは分からないけど、agent の擬人化。my designer agent。人間の組織図を sub-agent に当てるのは無理な比喩だと思う。
planner と knowledge manager。knowledge manager のタスクは?
A: Manus の knowledge システム。
knowledge agent はユーザーと agent の会話を見て、長期記憶に何を残すか決める。
Q&A - Safety and Guardrailing in Sandboxed Environments
guardrailing。安全の質問。
A: インターネットに繋がった sandbox は全部危険。だからガードにかなり力を入れている。少なくとも情報を sandbox の外に出さない。
prompt injection されたら、外向きトラフィックを検査する。
token 類が外に出ないようにする。
ユーザーが sandbox の外に印刷したいときは、取り除く仕組みで情報が出ないようにする。
もう一つは Manus 内のブラウザ。とても複雑。
サイトにログインして状態を persist させる選択ができる。ウェブの中身が悪意で prompt injection することもある。厄介。
アプリ会社の範囲を超えると思う。computer use のモデル提供者と近く働いている。
Anthropic と Google。ガードレールを足している。
今の Manus では、ブラウザでも sandbox でも敏感な操作のたびに手動確認が要る。accept するか、自分で takeover して終わらせる。
きれいな完成解は難しい。progressive。
今はユーザーに takeover してもらう頻度が高い。モデル側のガードが良くなれば、こちらは減らせる。
Q&A - Evaluation Strategies
evals。オンラインでもよく議論されている。Claude Code は code では形式的 eval を減らすと言っていた。飽和気味で、内部 dogfooding が多い。
evals はどう?役に立つ?どれが本当に役立つ?
アプローチは?
A: ローンチ当初は Gaia みたいな公開学術ベンチ。公開後、すごく misaligned だと分かった。
Gaia で高得点のモデルをユーザーは好きじゃない。
今は三種類。
いちばん大事なのは、完了した session ごとに 1 から 5 の星をユーザーに聞くこと。
gold standard。平均レーティングを常に見る。これが一。
二は、検証可能な内部自動テスト。
明確な答えのある自前データセット。公開学術ベンチもまだ使うが、execution 寄りのデータセットも作った。世の中のベンチは read-only が多い。
sandbox があるのでテスト環境を頻繁にリセットできる実行タスク、トランザクションタスクを設計した。
ここまでが自動。三番、いちばん大事なのはインターンがたくさんいること。サイト生成や可視化は、見た目が良いか分かる良い reward model がとても難しいので、本物の人間のインターンで評価する。
taste の問題。
Q&A - RL with Verifiable Rewards vs. Tool Calling Agents
検証可能報酬の強化学習対、ただの tool calling agent、という流れについて。
Claude Code はとても強い。harness を自分で作り、その上で RL できる。harness のツールで本当に良くなる。
RL はやる?どう考える?
その場合オープンモデルを使うことになる。
最近かなり遊んでいる。provider の tool calling をそのまま使う対、自分の環境と harness で RL。
A: pre-training、post-training、RL を何年もやってきた。リソースが十分なら今試していい。
でも前に言った通り MCP が大きい。MCP を支えるなら固定 action space ではない。
固定でないと良い reward を設計しにくい。rollout を大量に出せず、feedback が偏る。
MCP 対応モデルを自分で作るのは、実質 foundation model を自分で作ること。
コミュニティのモデル会社は同じことをしている。
あなたのためにやっている。今 RL にそんなに時間を使うべきではないと思う。前に言ったように、personalization や parameter free な online learning の新しいやり方を探している。
集団フィードバックとか。
Lance: その線で。Anthropic が Claude Code のツール集合で検証可能報酬の RL をした、という話。
harness のツール名を似せて同じ能力を unlock できる?
glob、grep、ファイルシステム操作用のツールセット。
同じ名前、同じ description の同じツールを harness に置けば、同じ機能を再現できる?unlock についてどう思う?
A: ここは答えははっきりしている。でも僕らは同じ名前を使わないようにしている。自分の function を設計すると要件が違い、パラメータも違うかもしれないから。
モデルを混乱させたくない。内部ツールを含む大量の post-training データで訓練されているなら、混ぜたくない。