
🔗 https://github.com/QuarkContainer/Quark/blob/main/doc/Hibernate.pdf
Titre anglais : Hibernate Container: A Deflated Container Mode for Fast Startup and High-density Deployment in Serverless Computing
0 Résumé
L’informatique serverless est un paradigme cloud populaire, qui demande une faible latence de réponse pour traiter des requêtes utilisateur à la demande. Deux techniques bien connues réduisent cette latence : garder un conteneur entièrement initialisé en vie (conteneur chaud1), ou réduire le délai de démarrage d’un nouveau conteneur (cold start). Cet article propose un troisième mode : le conteneur en hibernation2, plus rapide à démarrer que le cold start, et moins gourmand en mémoire qu’un conteneur chaud. Un conteneur en hibernation est essentiellement un conteneur chaud « dégonflé ». La mémoire applicative est swappée disque, la mémoire libérée est récupérée, la mémoire mmap adossée à des fichiers est nettoyée. La mémoire dégonflée est regonflée pour répondre à une requête. Comme l’appli est déjà entièrement initialisée, la latence est plus basse que le cold start ; comme la mémoire appli est dégonflée, la conso est plus basse qu’un conteneur chaud. De plus, quand un conteneur en hibernation est « réveillé » pour traiter une requête, le conteneur réveillé a une latence proche du chaud, mais moins de mémoire, car il n’est pas nécessaire de regonfler toute la mémoire dégonflée. Nous avons implémenté l’hibernation dans le runtime sécurisé open source Quark. Nos tests montrent une conso d’environ 7 % à 25 % d’un conteneur chaud. Au total : densité de déploiement plus haute, latence plus basse, et un vrai gain de perf système.
1 Un conteneur chaud est un conteneur entièrement initialisé créé dans un chemin de hot start
2 Conteneur en hibernation désigne le mode hibernate-container
1 Introduction
L’informatique serverless, FaaS et conteneurs serverless compris, devient un paradigme cloud de plus en plus populaire. Ces environnements font tourner des workloads multi-tenant en partage pour des requêtes à la demande. Les grands clouds le proposent : AWS Lambda [1]/Fargate [2], Google Function [3]/Cloud Run [4], Azure Function[5]/Container Instance [6].
Pour héberger des applis multi-tenant en partage, les grands clouds utilisent en général un runtime de conteneur sécurisé à base de VM, pas un runtime processus comme runC/LXC. L’isolation ressemble à une VM classique. AWS utilise Firecracker[7], GCP gVisor[8], Alibaba Cloud et Huawei Cloud Kata[9] pour le serverless. Ces runtimes VM consomment plus de mémoire et ont une latence plus haute que les runtimes processus.
La latence de réponse est critique en serverless. Trois parts : démarrage du runtime, init de l’appli, traitement de la requête. Le démarrage runtime fait souvent ~100 ms ; l’init appli va de 10 ms à 10 s ; le traitement est souvent court, quelques ms à 10 s. Face au traitement, runtime + init pèsent lourd. Les réduire est un défi clé. Deux grandes optimisations :
- Optimisation du hot start : garder le runtime en vie un court moment — conteneur chaud — pour réutiliser le même appel plus tard. Ça coupe le coût du cold start, mais garder des conteneurs en vie brûle beaucoup de compute, surtout la mémoire, donc plus de demande de ressources. Il y a du travail en cours : moins d’overhead runtime[10][8], meilleurs ordonnancements keep-alive[11].
- Optimisation de la latence cold start : on ne peut pas tout garder en vie. Autre axe : réduire le cold start — démarrage runtime[10][8] et init appli[12][13][14].
Cet article propose un troisième mécanisme, fondé sur le swap mémoire classique, bien adapté au temps de démarrage serverless. Deux points :
- Stockage de swap rapide : avec SSD, NVM dispo commercialement dans le cloud public[15], le swap a beaucoup gagné.
- Workloads serverless légers : le démarrage rapide veut des footprints bas. Chez AWS [16], 47 % des fonctions sont au minimum par défaut 128 MB. Seules 14 % des Lambda ont plus de 512 MB. Chez Azure[17], 90 % des applis ne dépassent jamais 400 MB, 50 % des workloads serverless ont au plus 170 MB. Petit footprint ⇒ coût de swap relativement bas.
Donc il y a une vraie ouverture pour le swap : démarrage basse latence + peu de mémoire pour les keep-alive. Avec le swap comme levier, nous proposons et implémentons le conteneur en hibernation : un conteneur chaud keep-alive dégonflé. Optimisations :
- Mémoire : bien moins qu’un chaud, car on swap l’appli disque, on rend la mémoire libre au noyau hôte, et on jette le mmap fichier vers l’OS hôte.
- CPU : zéro cycle, l’appli utilisateur est entièrement en pause.
La latence requête d’un hibernate est bien plus basse que le cold start, surtout parce que l’appli est déjà init et que le runtime garde ces ressources keep-alive :
- Objets OS hôte : processus runtime, cgroups, réseau conteneur, FS conteneur, processus. Ça mange peu de mémoire, mais ça évite un gros coût de ré-init.
- Threads runtime bloqués : les threads hôte attendent la requête. Pas de CPU, réponse immédiate, comme un chaud.
Important : un conteneur réveillé a une latence presque comme un chaud sur les requêtes suivantes, avec moins de mémoire, car il n’a pas besoin de toute la mémoire gonflée pour traiter.
Au total : plus de densité, meilleure perf système.
Contributions :
- Nous proposons et implémentons le mode hibernate-container dans Quark open source [18]. Moins de mémoire qu’un chaud, démarrage plus vite que le cold start. Un réveillé dérivé utilise aussi moins de mémoire qu’un chaud, latence presque identique.
- Le gros du délai de swap-in vient des lectures aléatoires SSD. Inspirés par REAP[16] (enregistrement et préfetch), nous implémentons un swap-in par préfetch mémoire par lots dans l’inflation. Nous comparons page-fault et REAP sur des benches.
- Nous implémentons un allocateur orienté récupération qui rend efficacement les pages libres au noyau hôte, sans ballooning complexe.
Le ballooning imagine un ballon dans la mémoire occupée par le guest. La mémoire du ballon est utilisable par l’hôte (pas par le guest). Quand l’hôte manque de libre, il peut demander au guest de récupérer une partie de la mémoire allouée ; le guest libère du idle, et s’il n’en a pas assez il peut récupérer de l’en-cours, voire swaper vers la partition swap guest, ce qui gonfle le ballon pour que l’hôte réutilise cette mémoire. Inversement, si le guest manque, on dégonfle le ballon pour lui rendre de la mémoire.
2 Contexte et motivation
Un conteneur en hibernation est un chaud dégonflé dans Quark. La déflation récupère la mémoire libre de l’appli et swappe la mémoire utilisateur vers le secondaire. Cette section : design du runtime sécurisé Quark, récupération / swap côté guest OS, puis motivation et opportunités.
2.1 Conteneurs sécurisés et runtime Quark
Comme dit, le mode hibernate est dans Quark open source [18]. Petit tour des runtimes sécurisés de pointe, puis l’archi Quark.
Le serverless héberge du multi-tenant en partage. RunC/LXC ne conviennent pas : pas d’isolation multi-tenant. Les grands clouds utilisent des runtimes VM : Kata[9]/Firecracker[19] et gVisor[8].
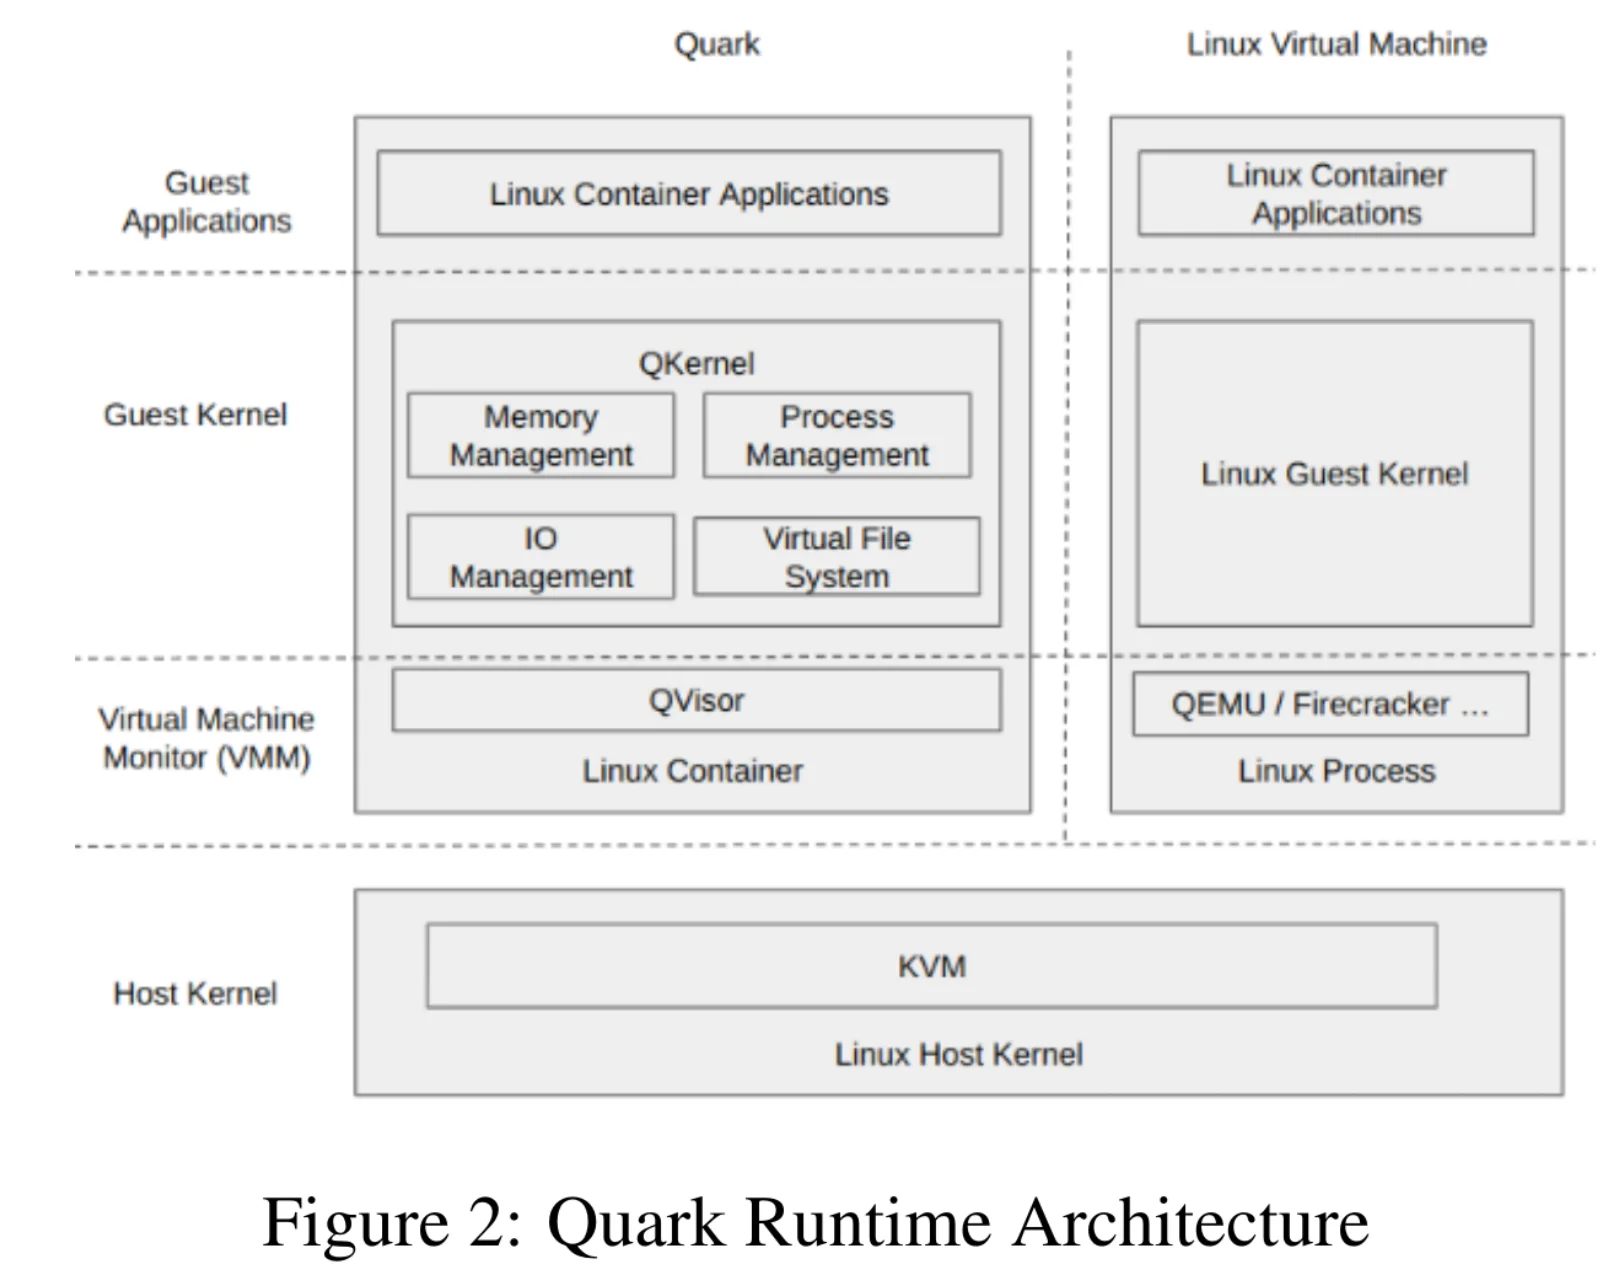
Kata et Firecracker isolent avec une VM noyau Linux. Noyau Linux généraliste ⇒ latence de start et overhead assez hauts en serverless.
Quark[18] et gVisor[8] sont deux autres runtimes notables faits pour le serverless. Noyau OS userspace + VMM léger. Interface syscall compatible Linux et CRI/OCI, pour faire tourner les images Linux sans changement. Très optimisés serverless, donc start et overhead plus bas que Kata/Firecracker. Contrairement à Kata/Firecracker explicitement basés Linux, la compat Linux de Quark et gVisor n’est pas aussi bonne.
La figure 2 montre l’archi Quark. Comme une VM Linux classique : noyau hôte Linux, hyperviseur KVM. Le processus runtime tourne dans un conteneur Linux standard, cgroups et namespaces réseau/FS. Quark a un nouveau noyau userspace (QKernel) et un VMM (QVisor), très optimisés serverless. Il virtualise une interface syscall qui émule Linux, et implémente l’essentiel : mémoire, processus, I/O, etc.
Quark est conçu serverless, avec des fonctions spécifiques comme le mode hibernate.
2.2 Récupérer la mémoire libérée par le guest OS
Une valeur clé du mode hibernate : rendre à l’hôte la mémoire libérée par l’appli. Pour un guest Linux généraliste, ce n’est pas simple. Quand l’appli guest libère vers le noyau guest, idéalement ce noyau devrait rendre à Linux hôte pour d’autres processus. Malheureusement le guest Linux garde ça dans son pool. Linux est optimisé bare metal, sans reclaim vers un hôte. Bref : la mémoire libérée dans le guest n’est pas rendue/récupérée par l’hôte en virtualisation classique.
Deux approches :
- Ballooning[20] : driver balloon dans le guest, qui coopère avec le VMM pour retailler la mémoire VM. L’hyperviseur récupère du unused chez certains guests et le partage.
- Memory plug-in[21] : hot-add/hot-remove de mémoire physique. Le hot-remove rend une région indisponible et demande une migration de pages, coût perf. Utilisé pour la collecte mémoire VM [22].
Kata/Firecracker, aussi sur guest Linux, ont le même problème. À notre connaissance, ni ballooning ni plug-in — trop complexes en serverless.
Dans le travail hibernate, nous avons mis un gestionnaire mémoire dédié dans Quark pour l’efficacité du reclaim.
2.3 Swap de la mémoire applicative guest
Autre valeur : swaper la mémoire de l’appli utilisateur.
Le swap écrit temporairement des pages inactives sur le secondaire et marque l’entrée de table non présente. Quand il faut la page, le sous-système VM lève un page fault pour le swap-in.
En virtualisation courante, le swap hôte est inefficace car non coopératif. VSWAPPER[23] étudie ça : écritures silencieuses, lectures périmées, fausses lectures, etc. VSWAPPER implémente un swapper indépendant du guest. Ça marche assez bien en virtualisation classique, pas spécialement serverless.
En serverless, on veut swaper toute la mémoire d’un conteneur idle — d’où des opportunités :
- Swap-out par lots des pages appli : d’habitude le noyau choisit des inactives. Ici on swap tout le working set utilisateur d’un idle, ce qui économise du chemin MM.
- Swap-out sans course d’une appli en pause : on peut pauser les processus idle pendant le swap, sans les races du swap ordinaire.
- Lectures disque séquentielles par lots au swap-in : le swap-in classique est page-fault, accès aléatoire. HDD ou SSD, le séquentiel par lots bat toujours le random. REAP[14] montre qu’une fonction touche le même working set stable d’un appel à l’autre. Une fois l’ensemble identifié, préfetch séquentiel par lots. Versus page-fault, on économise le random disque et le coût des faults + commutations guest/hôte.
Motivation : prendre toutes ces opportunités et faire un swap plus efficace pour le serverless.
3 Conception et implémentation
Les sous-sections suivantes détaillent l’archi hibernate-container dans Quark.
3.1 Machine à états du conteneur en hibernation
Comment un hibernate répond aux requêtes.
La figure 3 montre les transitions d’état.
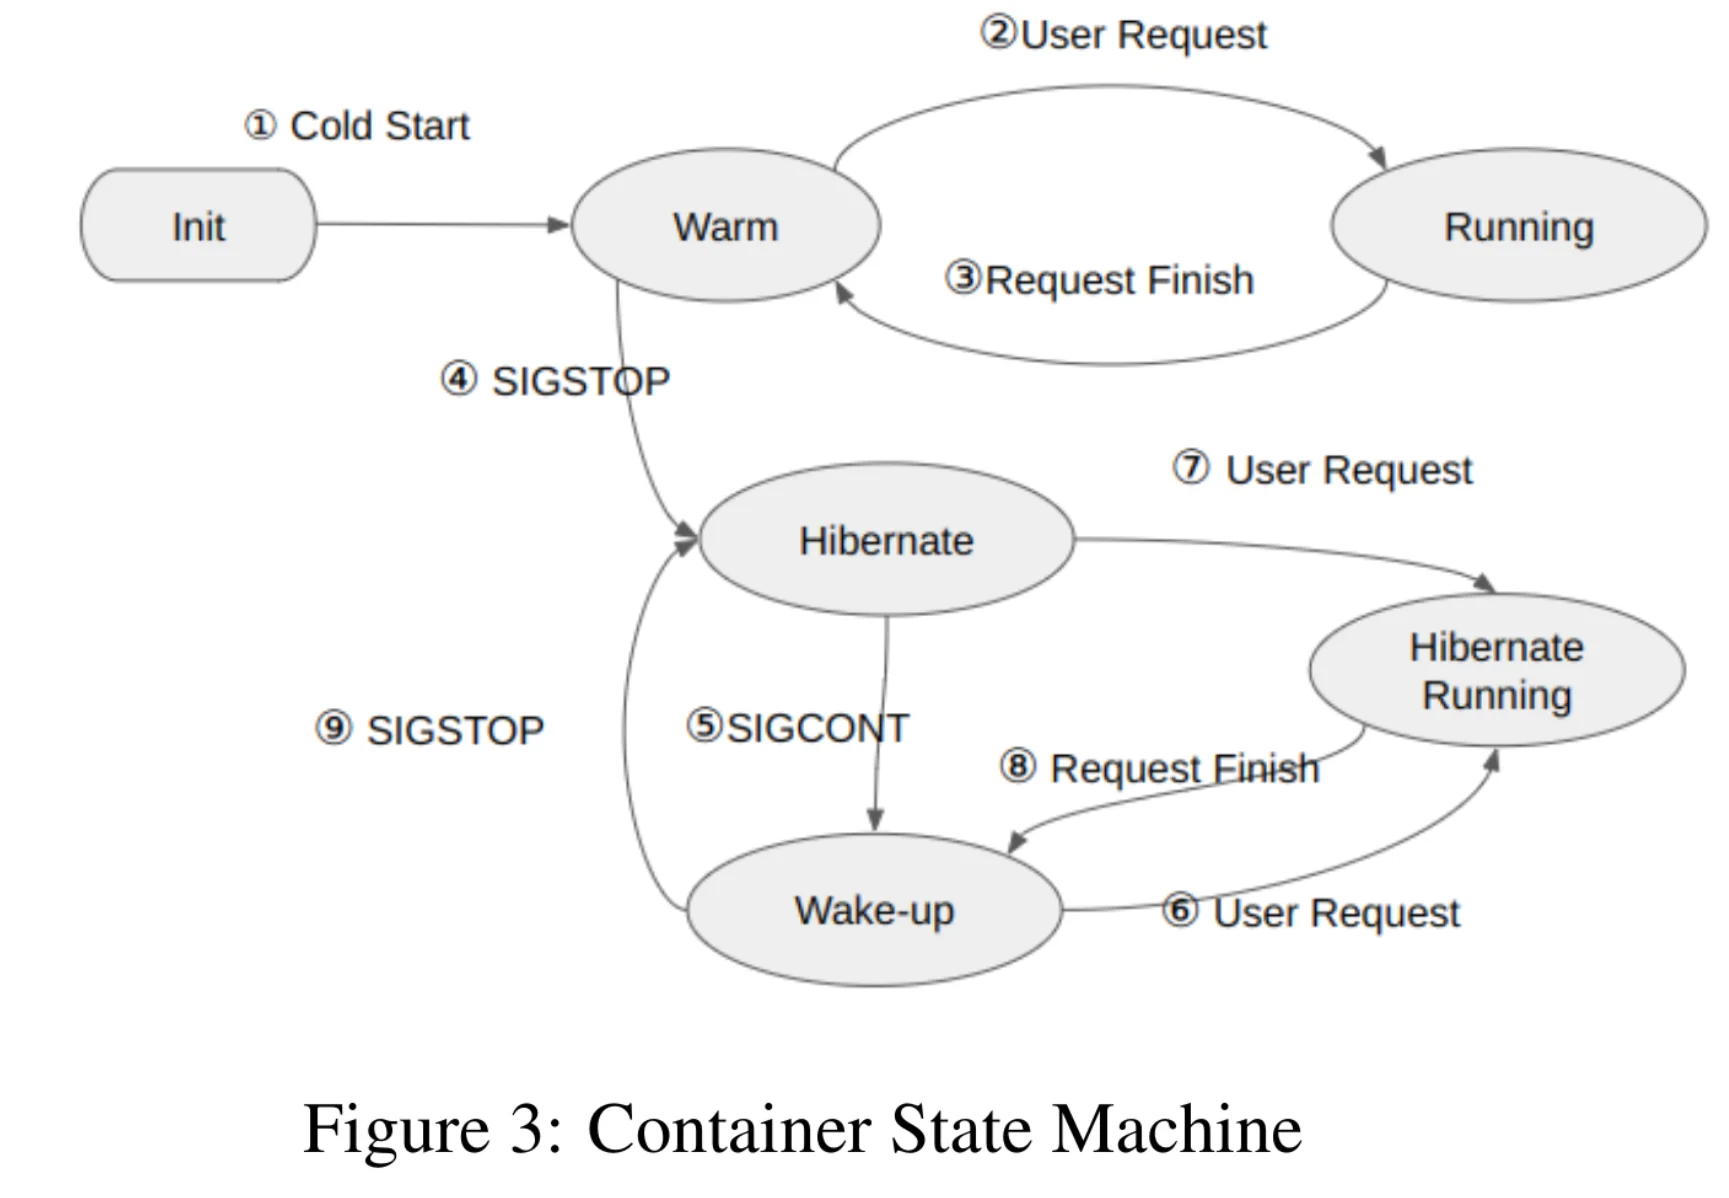
Sur une requête, la plateforme fait 1️⃣ un cold start. Un nouveau chaud est créé, la requête lui est transmise. En recevant la requête il 2️⃣ passe running, puis 3️⃣ revient hot une fois fini.
Pour la latence, la plateforme peut garder le chaud un court moment. D’autres requêtes dans la fenêtre peuvent être servies à basse latence. Idle, il occupe encore sa mémoire appli. Sous pression, la plateforme peut l’évincer pour d’autres fonctions. Après éviction, la prochaine requête paie un cold start plus cher. Bref : plus de chauds, meilleure latence.
Outre les états classiques, trois nouveaux :
Hibernate : un hibernate est un chaud dégonflé, footprint plus petit. Au lieu d’évincer, on peut « dégonfler » un chaud en hibernate pour libérer de la mémoire.
La plateforme envoie SIGSTOP au chaud, 4️⃣ hot → hibernate, pour lancer la déflation.
Hibernate-running : sur une requête, un hibernate peut 7️⃣ passer hibernate-running, comme un running, pour traiter.
Réveillé : un hibernate-running 8️⃣ revient réveillé après traitement. Le réveillé 6️⃣ reprend hibernate-running à la requête suivante. Il peut 9️⃣ revenir hibernate sur SIGSTOP. Latence presque comme un chaud, moins de mémoire. Si la plateforme prévoit une requête, elle peut aussi « réveiller » un hibernate en réveillé avec SIGCONT 5️⃣.
3.2 Aperçu du processus de déflation (Deflation Process Overview)
Un hibernate est essentiellement un chaud compressé. Quatre étapes depuis un chaud :
- Pauser les processus appli du chaud, bloquer les threads runtime hôte en attente d’un trigger « wake ».
- Récupérer les pages appli libérées et les rendre au noyau Linux hôte.
- Swaper les pages appli commises vers le disque local.
- Jeter le mmap fichier avec madvise() et MADV DONTNEED, rendu au noyau Linux.
Après #1, plus de CPU. Après #2, #3, #4, la mémoire allouée appli est rendue à l’hôte, donc bien moins qu’un chaud. Détails en 3.3, 3.4, 3.5.
Un hibernate peut redevenir chaud : inflation mémoire + reprise des processus. Deux triggers :
- Requête utilisateur : la plateforme peut transférer directement au hibernate sans le réveiller d’abord. Le hibernate bloque un thread runtime (sys accept / sys read POSIX). Connect ou data socket ⇒ le noyau hôte débloque, puis swap-in et reprise appli.
- Plan de contrôle serverless : réveil explicite si une requête est attendue. L’inflation est en partie faite avant, latence plus basse que le chemin requête.
3.3 Gestion mémoire orientée récupération
Un hibernate récupère les pages libérées par l’appli guest et les rend au noyau Linux hôte, comme le ballooning VM.
QKernel tourne dans une VM KVM ; sa mémoire physique guest est de la virtuelle hôte. Les pages physiques guest (virtuelles hôte) ne sont pas commises par l’hôte tant qu’on n’y touche pas. Quark peut rendre des pages commises avec sys madvise() et MADV DONTNEED[24]. Après un madvise() OK, les accès suivants réussissent encore, mais ça fait des pages zero-fill on-demand pour les mappings anonymes privés. Idéalement, une fois les zones libres identifiées dans l’allocateur guest, on reclaim avec madvise().
Malheureusement le Quark d’origine ne reclaimait pas facilement. Il utilise un buddy binaire [25]. Mauvais pour le reclaim : blocs libres en liste linéaire, pointeur « next » dans le bloc libre. OK sur bare metal. Sur guest, madvise() d’un bloc libre ⇒ accès suivants zero-fill ⇒ « next » effacé ⇒ liste corrompue. Donc le buddy existant ne convient pas. Nous avons fait un bitmap page allocator.
Deux domaines d’alloc d’origine :
- Espace d’adressage appli guest : sys brk, sys mmap, etc. Ça n’alloue que de l’espace ; les pages ne sont commises qu’au page fault.
- Tas global du runtime : Quark est en Rust, allocateur de tas custom buddy. Stacks noyau QKernel, etc. L’ancien Quark allouait aussi les pages appli depuis ce tas dans le fault handler — hostile au reclaim. D’où un troisième allocateur : bitmap page allocator.
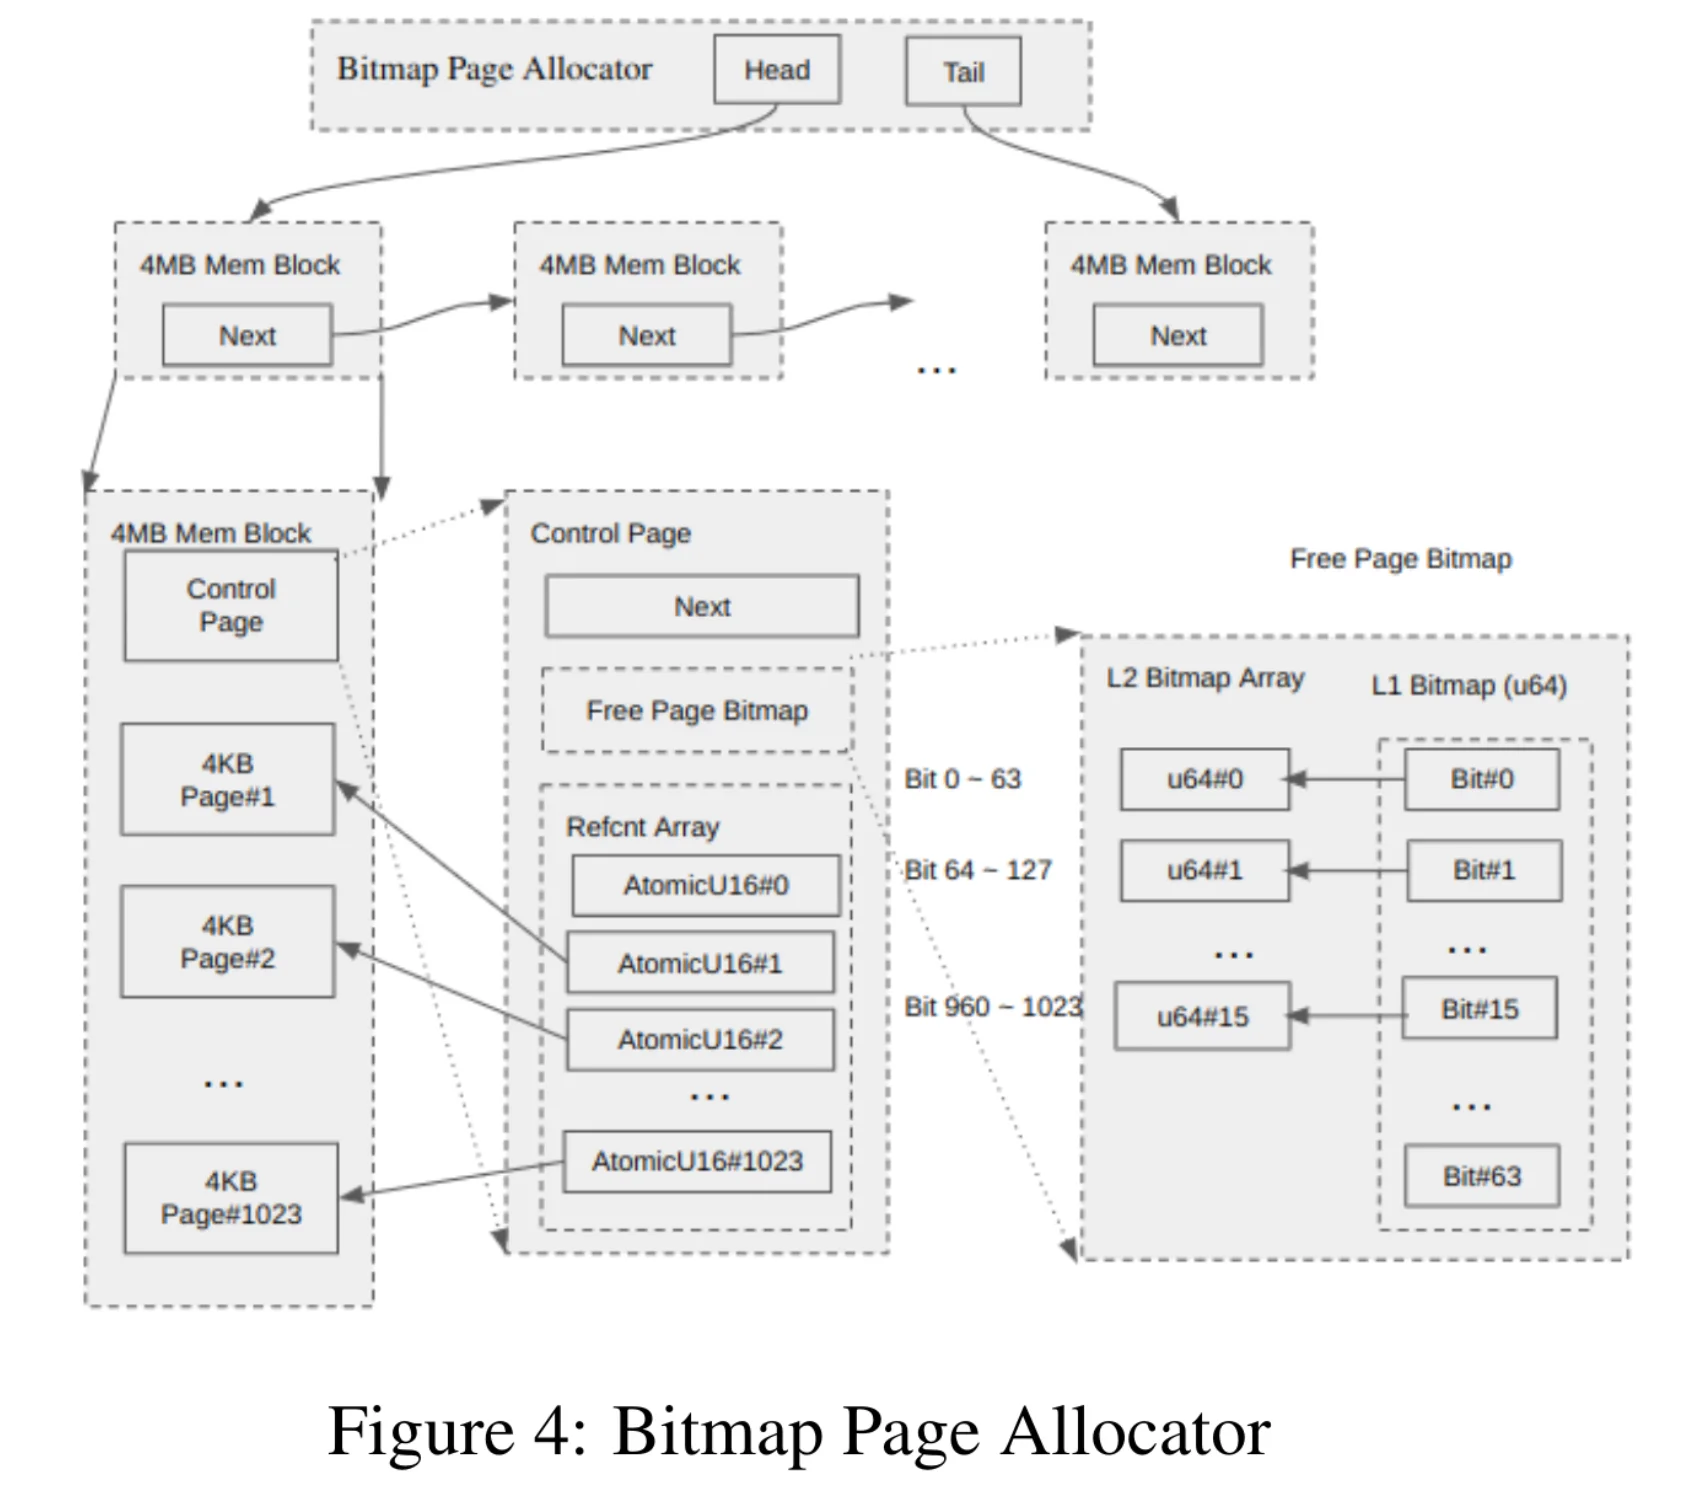
Le bitmap page allocator gère les pages de l’appli guest. Uniquement dans le fault handler, pages 4 Ko fixes.
Figure 4 : chunks 4 Mo pour pages 4 Ko. Début aligné 4 Mo ; première page 4 Ko = page de contrôle, 3 champs :
- Pointeur « next » : tous les chunks 4 Mo avec des pages libres sont en liste linéaire. Le next est dans la page de contrôle.
- Bitmap de pages libres : un chunk 4 Mo = 1024 pages 4 Ko. La première est contrôle ; 1023 allouables. Bitmap L2, tableau 16 × 64 bits (1024 bits), un bit par page. Pour accélérer, un entier 64 bits L1 indique si chaque mot L2 est zéro. Chaque alloc touche deux 64 bits : L1 et un mot L2. Pour une page libre, d’abord le premier bit non zéro de L1.
Si c’est le bit 4 : le 4e mot L2 a une page libre. Puis premier bit non zéro de ce mot. Lookup O(2).
- Tableau de refcounts : une page noyau peut être référencée par plusieurs tables (clone). Refcounts sur la page de contrôle, tableau d’entiers atomiques 16 bits[26].
Alloc et inc/dec de refcount :
- Alloc : depuis le premier chunk 4 Mo de la liste libre, MAJ bitmap. Plus de libre ⇒ hors liste. Liste vide ⇒ autre chunk 4 Mo depuis le tas global (buddy). Lock global contre les courses.
- Inc/dec : clone/exit guest ou COW. Les stocker sur la page de contrôle aide la perf. Chunks alignés 4 Mo : n’importe quelle page guest trouve sa page de contrôle en masquant les 22 bits bas. Pas de table de lookup. Puis atomics Rust fetch_add / fetch_sub [26], lock-free. Refcount à zéro ⇒ page rendue via le bitmap. Si le compteur de libres du chunk était 0 et qu’une page se libère, le chunk revient en liste. À 1023 libres, le chunk 4 Mo peut revenir au tas global.
Quand Quark hiberné, les pages libres doivent revenir à l’hôte. Elles sont indiquées par le bitmap de contrôle, pas de « next » dans la page comme un buddy. madvise() des pages libres. Bien plus simple que le ballooning.
Au réveil, quand des pages reclaimées sont réallouées à l’appli, l’hôte les commet par page fault hôte. Transparent pour Quark guest : pas de réalloc explicite. Moins de latence de wake et moins de complexité.
3.4 Swap mémoire du conteneur en hibernation
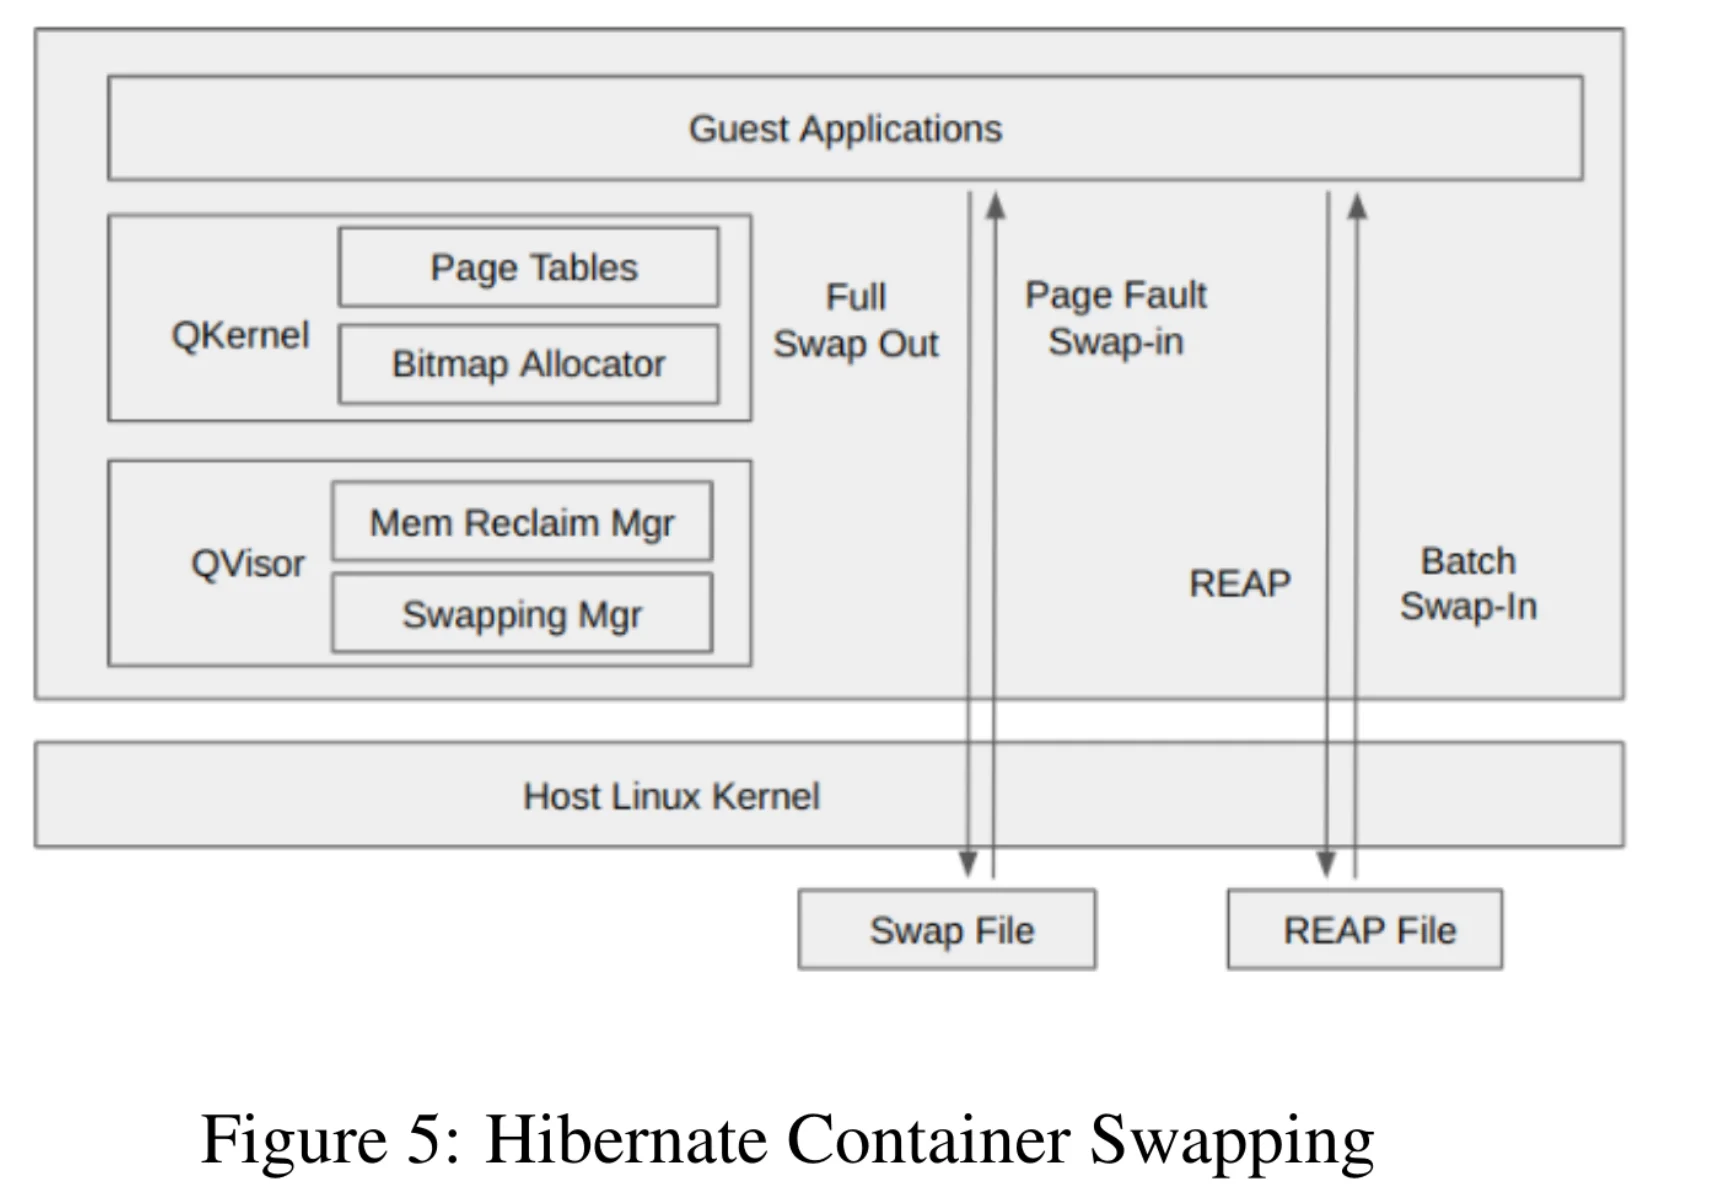
Un hibernate swappe la mémoire appli guest vers le secondaire ; ces pages peuvent revenir au réveil.
Deux mécanismes de swap-in :
- Page-fault : comme l’OS, accéder à une page swappée faut, le handler charge.
- REAP par lots : préfetch de toutes les pages enregistrées par REAP.
Figure 5 : par sandbox, un fichier swap pour le page-fault et un fichier REAP pour le batch. Fichier swap dédié, pas partagé, pour limiter les failles ; supprimé à la fin du sandbox.
Le page-fault swap-in et le REAP swap-out diffèrent.
3.4.1 Swap-in / swap-out par page fault
La plateforme peut SIGSTOP un chaud idle pour hiberné. Puis le swap manager de la figure 5 :
- Pause l’appli guest : handler SIGSTOP générique, toutes les applis guest. Threads user bloqués, plus d’accès mémoire, pas de races complexes ;
- Parcourir et modifier les page tables guest : tables de toutes les applis, pages anonymes :
- Marquer chaque PTE anonyme not present, pour faulter plus tard ;
- Mettre le bit custom #9 : fault due au swap-out ;
- Mettre le GPA dans une hash table pour dédup si plusieurs tables pointent le même GPA.
- Écrire le fichier swap : un par sandbox Quark. Enumérer la hash, écrire, stocker les offsets.
- Rendre à Linux hôte : madvise() des pages swappées.
Au réveil, reprise de l’appli. Accès à une page swappée ⇒ fault ⇒ swap-in.
Traitement du fault :
- Confirmer le bit #9. Si set, page swappée, swap-in à l’étape #2.
- Charger depuis le fichier : le vCPU faut sort guest→hôte et lit le fichier swap.
- MAJ PTE : clear #9, present, plus de fault.
Le page-fault swap-in est cher :
- Traitement de fault : vCPU guest user→kernel, GPRs en mémoire.
- Commutation guest/hôte : chère, GPRs + contexte FP. Chez nous ~15 µs.
- Lectures 4K aléatoires SSD : tests sur SSD. Le random 4 Ko SSD bat le HDD, mais reste sous le séquentiel par lots. Chez nous ~100 MB/s random 4K, >1 GB/s séquentiel par lots.
On a vu que le page-fault ne recharge que 30 % à 90 % des pages swappées pour une requête. Node.js Hello World hibernate : ~10 MB out, ~4 MB in pour la requête. Les pages out mêlent init et handling ; à l’inflation l’init est déjà faite. D’où, inspirés par REAP[14], un swap-in REAP par lots.
3.4.2 Swap-out REAP et swap-in par lots (record and prefetch)
Idée REAP : enregistrer le working set physique guest pendant une requête, préfetch par lots au réveil suivant. Optimisation du page-fault swap-in.
Versus le swap-out page-fault, REAP ajoute un enregistrement après le premier hibernate + wake. Après la première entrée en hibernate :
- Requête échantillon : la plateforme envoie un sample pour passer hibernate-running ;
- Enregistrement du working set physique : en hibernate-running, le working set GPA est chargé du fichier swap par page-fault ; les pages non touchées restent ; 3. Hibernate REAP : après le sample, retour réveillé. SIGSTOP pour hiberné le réveillé. Swap-out REAP :
- Pauser tous les processus user.
- Parcourir toutes les tables, pages anonymes actives.
- Enregistrer les GPA dans un vecteur d’I/O hashé, pwritev() par lots vers le fichier REAP de la figure 5.
- Libérer les pages physiques guest avec madvise().
Le swap-out REAP ≠ page-fault :
- Il ne change pas les PTE, donc pas de fault ;
- Il écrit un fichier REAP dédié, swap-in accéléré par lectures séquentielles par lots.
Le swap-in REAP est plus simple.
Étapes :
- Préfetch de toutes les pages du fichier REAP avec preadv() séquentiel par lots, via le vecteur d’I/O hashé.
- Reprendre les processus guest. REAP bat le page-fault parce que :
- Pas d’overhead de fault : pas de changement de PTE ⇒ pas de fault au swap-in.
- Lectures fichier par lots : meilleur débit que le random.
3.5 Partage de mémoire fichier et sécurité
Un hibernate jette aussi le mmap fichier avec madvise() vers Linux hôte. Quark peut partager du mmap fichier entre conteneurs en copy-on-write. Si c’est partagé, la déflation n’a pas à le jeter : d’autres conteneurs s’en servent. Le partage coupe la latence de start et le footprint global — attractif en serverless.
Malheureusement, en multi-tenant, partager du mmap fichier entre tenants = risques (canaux caches [27]). Pas recommandé en prod multi-tenant [7].
Deux grandes sortes de mémoire fichier partageable dans un conteneur sécurisé :
- Binaires de runtime langage : Node.js, Python, etc., mappés en user space, accessibles par l’appli. Partage inter-tenants risqué.
- Binaires du runtime sécurisé : exécutable et libs, p.ex. noyau guest Linux de Kata. Pas mappés en user space, l’appli n’y touche pas directement, risque plus bas. RunD [10] partage le noyau guest Linux en prod pour accélérer le cold start et couper le footprint.
Hibernate active le partage des binaires Quark, désactive celui des runtimes langage.
Le partage des binaires runtime coupe beaucoup la latence. Node.js : avec partage mémoire du binaire Node.js, hello-world hibernate passe de 25 ms à 11 ms. Il existe des mitigations [28] [29] ; certaines en prod. Cloudflare Worker [29], isolates V8, accepte un risque d’isolation multi-tenant. Une fois le problème réglé, hibernate pourra partager plus de mémoire fichier avec ces mitigations.
3.6 Implémentation
Code hibernate en Rust, dans Quark. Quark est un OS userspace virtuel, >200k lignes Rust. Hibernate touche MMU virtuelle, I/O, VMM. Swap manager et bitmap allocator écrits from scratch : 780 LOC swap manager, 484 bitmap. Gestionnaire de reclaim en modifiant le mmap fichier et les page tables Quark, ~500 lignes. ~300 lignes de plus dans signaux et I/O pour déclencher l’hibernation.
4 Évaluation
Expériences. Machine : 1×12 cœurs Intel(R) Core(TM) i7-8700K @ 3.70 GHz, 64 Go RAM, SSD PM981 NVMe Samsung 512 Go, Ubuntu 20.04.4, noyau 5.15.0-46-generic.
Deux jeux de microbenches : latence requête et footprint.
- Benches Python : un set Function Bench[30], types de process, mémoire, latence.
- Flottant : petite mémoire et petite latence ;
- Vidéo : grayscale OpenCV sur une vidéo. >200 Mo, >1000 ms.
- Image : transforms Python Pillow. Deux tailles d’image pour voir l’effet de la taille des données.
- Hello-world de runtimes : Python, Node.js, Golang, Java.
4.1 Latence de réponse
Latence hibernate < cold start ; réveillé ≈ chaud. Comparaison page-fault vs REAP.
Comme un hibernate est déjà démarré keep-alive, on mesure la latence bout-en-bout requête/réponse, pas le start appli. Sauf cold start, microbenches en HTTP, trigger par requête HTTP, mesure de la latence HTTP.
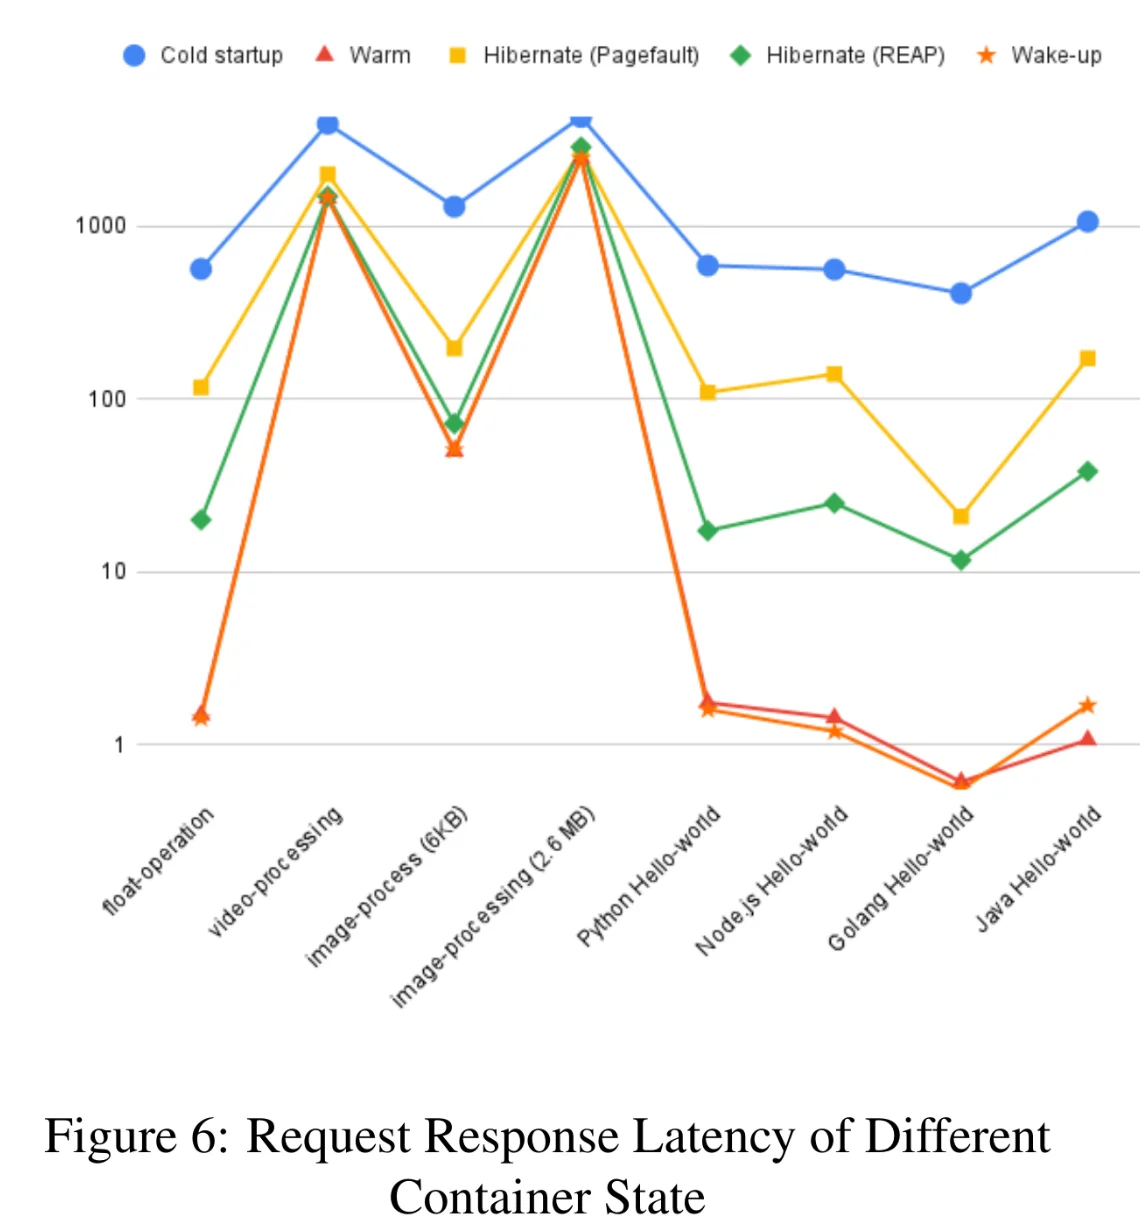
Latences collectées : cold start, chaud, hibernate page-fault/REAP, réveillé :
- Cold start : latence processus start conteneur + handling, sans trigger HTTP ;
- Chaud : latence après init complète ;
- Hibernate : première requête après hibernate. Page-fault et REAP aussi.
- Réveillé : latence d’un réveillé.
Figure 6. Conclusions :
- Latence Hibernate < cold start : p.ex. Hibernate REAP = 3 % (Python/Golang Hello-world) à 67 % (image, fichier 2,6 Mo) de la latence processus cold start. Hibernate REAP économise 296 ms (Golang Hello-world) à 2407 ms (vidéo).
- Latence réveillé ≈ chaud.
- Hibernate page-fault > REAP : REAP gagne sur la plupart des benches. Seule exception : image 2,6 Mo, écart négligeable.
Hibernate bat le cold start ; le réveillé match le chaud. Ça aide aussi Python, Node.js, Golang, Java.
4.2 Conso mémoire
Un hibernate et son réveillé consomment moins qu’un chaud. PSS via pmap Linux :
- Chaud : quelques requêtes déjà traitées.
- Hibernate : passage chaud → hibernate.
- Réveillé : hibernate réveillé par une requête.
Comme en §3.4, hibernate partage les binaires Quark, donc PSS plus petit avec plus d’instances. PSS sur 10 instances de bench.
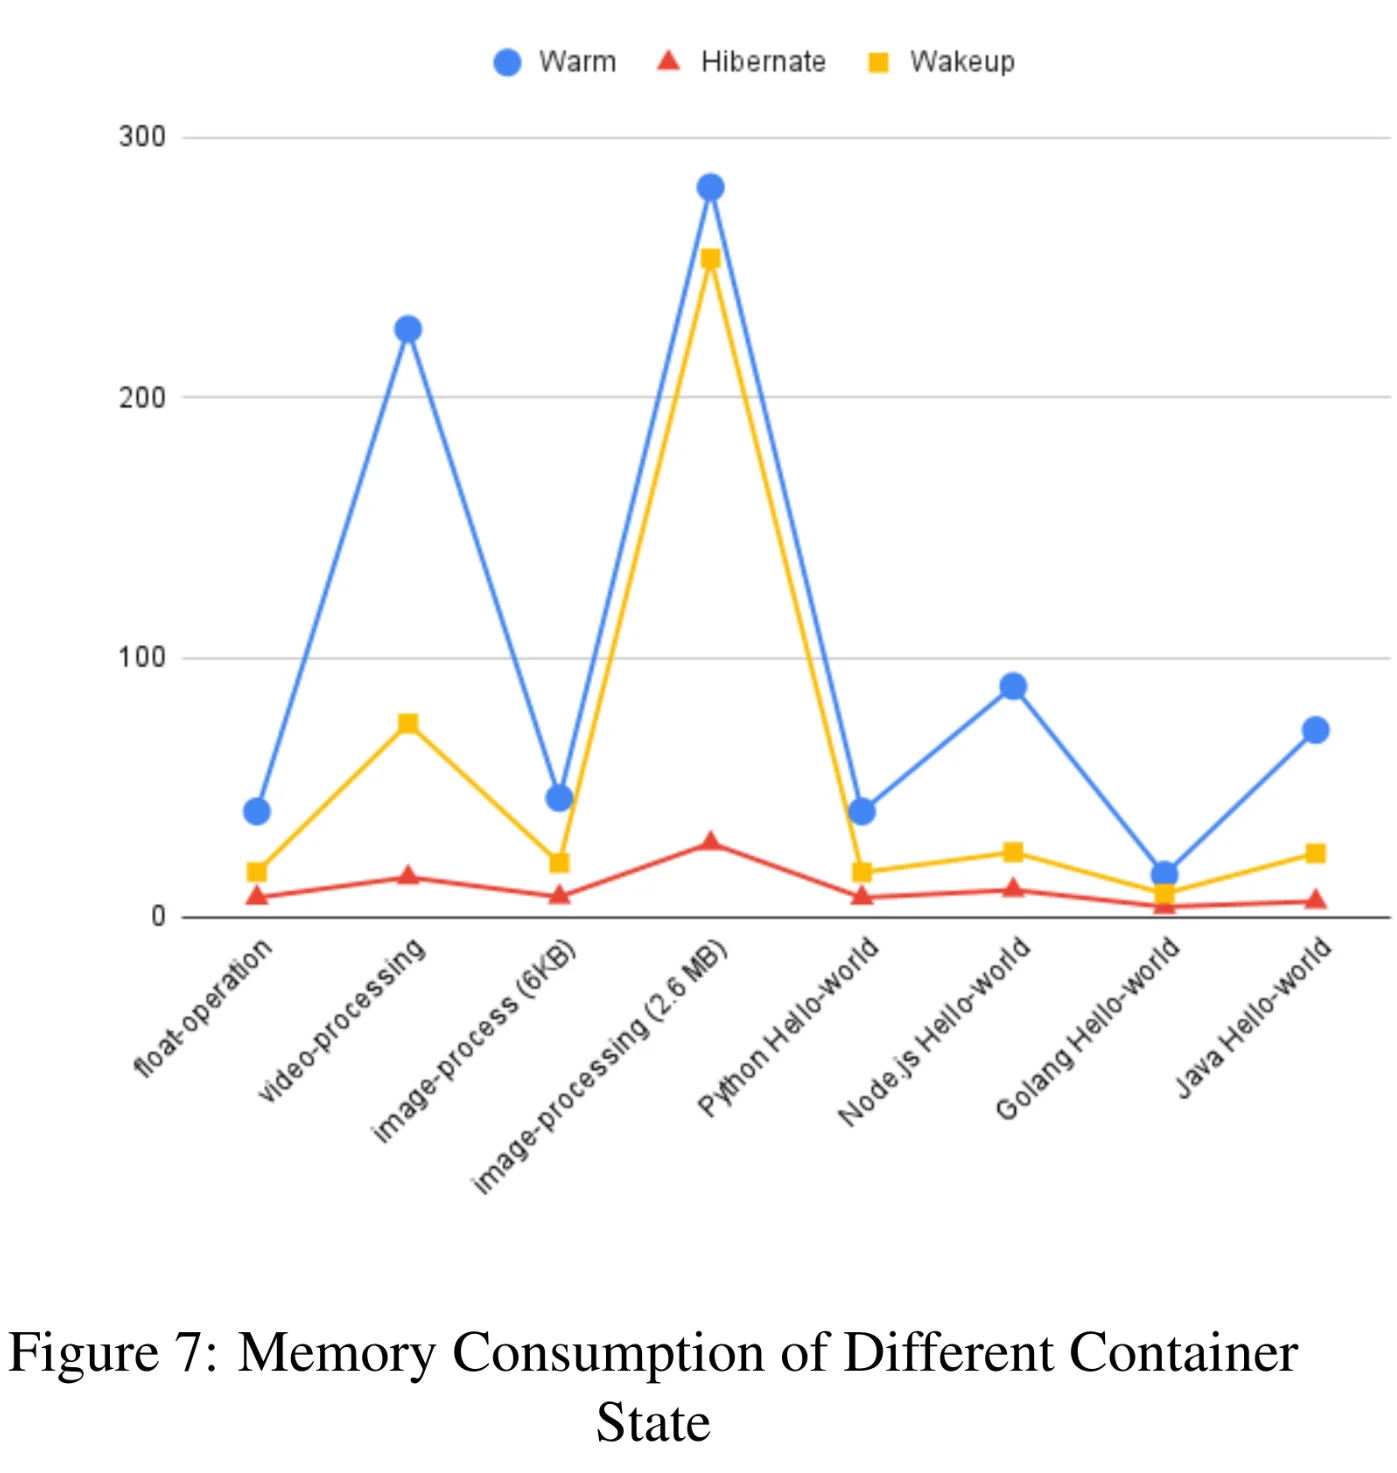
Figure 7 :
- Mémoire hibernate ≪ chaud : ~7 % (vidéo) à 25 % (Golang Hello-world). Économie 12 Mo (sur 16 Mo, Golang Hello-world) à 252 Mo (sur 281 Mo, image 2,6 Mo).
- Réveillé < chaud : 28 % (Node.js Hello-world) à 90 % (image 2,6 Mo). Économie 7 Mo (sur 16 Mo Golang Hello-world) à 151 Mo (sur 226 Mo vidéo).
Hibernate et réveillé < chaud, pour Python, Node.js, Golang, Java.
Des tests latence + mémoire :
- Co-déployer hibernate et réveillé donne une densité plus haute que des chauds.
- Un réveillé a moins de mémoire et une latence proche du chaud. Quand c’est possible, transformer un chaud en réveillé keep-alive via hibernate est bénéfique.
5 Travaux liés
Plusieurs travaux, surtout cold start. Le cold start a deux activités : start du runtime sécurisé et start de l’appli.
Les sous-sections suivantes.
5.1 Optimisation des runtimes VM sécurisés
Le start VM-sécurisé = setup d’environnement Linux (cgroups, réseau, FS) + boot du noyau VM. RunD [10] accélère le setup : pré-création de cgroups, mapping rootfs. RunD utilise des templates Kata pour l’overhead mémoire par micro-VM et la latence de start.
Firecracker[19] introduit un VMM léger à la place de QEMU / Cloud Hypervisor. Peu de devices : virtio net et un seul type block. Ça aide mémoire et latence de sandbox.
Quark[18] et gVisor[8] : nouveau noyau userspace et VMM serverless, footprint et start plus bas.
5.2 Optimisation du start applicatif
L’idée : démarrer d’un état « plus proche » d’un chaud. [13][31] utilisent C/R de gVisor ou de la JVM. [32] réutilise un chaud sur le point d’être reclaimé pour une autre image.
Sur C/R, Catalyzer [13] fait un start sans init. D’autres opts sur C/R : REAP préfetche par lots le chargement d’image VMM. Sock [12] étend Zygote en forking un helper avec paquets pré-importés. Catalyzer introduit sfork : fork depuis un chaud existant avec l’état appli complet, mémoire partagée parent/enfant.
Conclusion
Un start conteneur basse latence est critique pour l’UX serverless. Outre cold start et hot start, cet article propose un troisième mode : le conteneur en hibernation. Essentiellement un chaud dégonflé.
Nos expériences : mémoire hibernate ≪ chaud, latence requête < cold start. Une fois réveillé, encore moins de mémoire qu’un chaud, même latence de requête. Au total : plus de densité, moins de latence, et une nette amélioration de la perf système.